 产学研创新服务平台(全国)


声纹识别方法、系统、移动终端及存储介质发明专利
更新时间:2026-11-01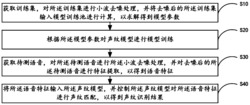 专利申请类型:发明专利;
地区:福建-厦门;
源自:厦门高价值专利检索信息库;
声纹识别方法、系统、移动终端及存储介质
摘要:本发明提供了一种声纹识别方法、系统、移动终端及存储介质,该方法包括:获取训练集,对训练集进行小波去噪处理,并将去噪后的训练集输入模型训练池,以求解得到模型参数;根据模型参数对声纹模型进行模型参数设置;获取待测语音,对待测语音进行小波去噪处理,并对去噪后的待测语音进行特征提取,以得到语音特征;将语音特征输入声纹模型,并控制声纹模型对所述语音特征进行声纹匹配,以得到声纹识别结果。本发明通过对训练集和待识别语音进行小波去噪处理的设计,能有效的提升训练后的声纹模型的准确度,降低了背景环境噪声对声纹识别的影响,且有效的提高了同一语音或者不同语音片段在不同环境噪声下的识别准确率。
专利类型:发明专利
专利申请号:CN202010097502.6
专利申请(专利权)人:厦门快商通科技股份有限公司
权利人地址:福建省厦门市软件园三期诚毅北大街63号1301单元
专利发明(设计)人: 叶林勇 ,肖龙源 ,李稀敏 ,蔡振华 ,刘晓葳
主权利要求:声纹识别方法、系统、移动终端及存储介质
技术领域
[0001] 本发明属于声纹识别技术领域,尤其涉及一种声纹识别方法、系统、移动终端及存储介质。
背景技术
[0002] 每个人的声音都蕴涵着特有的生物特征,声纹识别是指利用说话人的声音来识别说话人的一种技术手段。声纹识别同指纹识别等技术一样具有高度的安全可靠性,可以应用在所有需要做身份识别的场合。如在刑侦、银行、证券、保险等金融领域。与传统的身份识别技术相比,声纹识别的优势在于,声纹提取过程简单,成本低,且具有唯一性,不易伪造和假冒。
[0003] 现有声纹识别方案是提前采集至少一个用户的语音数据,并对语音数据进行特征值提取,将提取到的特征值输入声纹模型得到N维声纹向量。后面在做确认或者识别的时候,先获取任意一个用户的语音数据,然后对语音数据提取特征值,将特征值输入声纹模型,得到N维声纹向量,再与声纹库里原有的声纹向量做相似度匹配,每匹配一个用户会得到一个分值,分值最高并且大于阈值的声纹为待测语音所对应的用户。但现有技术中,待测语音的背景环境噪声对声纹识别的准确率影响较大,进而导致现有的声纹识别准确率低下。
发明内容
[0004] 本发明实施例的目的在于提供一种声纹识别方法、系统、移动终端及存储介质,旨在解决现有的声纹识别方法识别准确率低的问题。
[0005] 本发明实施例是这样实现的,一种声纹识别方法,所述方法包括:
[0006] 获取训练集,对所述训练集进行小波去噪处理,并将去噪后的所述训练集输入模型训练池进行计算,以求解得到模型参数;
[0007] 根据所述模型参数对声纹模型进行模型参数设置;
[0008] 获取待测语音,对所述待测语音进行所述小波去噪处理,并对去噪后的所述待测语音进行特征提取,以得到语音特征;
[0009] 将所述语音特征输入所述声纹模型,并控制所述声纹模型对所述语音特征进行声纹匹配,以得到声纹识别结果。
[0010] 更进一步的,所述对所述训练集进行小波去噪处理的步骤包括:
[0011] 对所述训练集中的每个子集分别进行小波分解,以得到多个小波信号;
[0012] 根据多个不同的预设频段对所述小波信号进行分类;
[0013] 分别查询每个所述预设频段对应的去噪方式,并根据所述去噪方式对对应所述预设频段内的所述小波信号进行自适应去噪;
[0014] 在每个所述预设频段中对自适应去噪后所述小波信号进行小波重构,并根据重构结果输出每个所述预设频段的小波重构信号;
[0015] 将所述小波重构信号输入预设滤波器,以得到样本声纹特征。
[0016] 更进一步的,所述在每个所述预设频段中对自适应去噪后所述小波信号进行小波重构的步骤之前,所述方法还包括:
[0017] 对各个所述预设频段中所述小波信号的小波系数进行加权处理。
[0018] 更进一步的,所述控制所述声纹模型对所述语音特征进行声纹匹配的步骤包括:
[0019] 对所述语音特征进行向量转换,以得到特征向量;
[0020] 将所述特征向量与本地预存储的声纹库中的样本向量依序进行比对,以得到多个比对值;
[0021] 获取所述比对值中的最大值,并判断所述最大值是否大于或等于比对阈值;
[0022] 当判断到所述最大值大于或等于所述比对阈值时,获取所述最大值对应的所述样本向量的用户标识,并将所述用户标识进行输出;
[0023] 当判断到所述最大值小于所述比对阈值时,发出声纹识别错误提示。
[0024] 更进一步的,所述特征向量与所述样本向量之间所采用的比对公式为欧式距离公式,所述欧式距离公式为:
[0025]
[0026] 更进一步的,所述小波分解所采用的实部分量计算公式为:
[0027]
[0028]
[0029] 所述小波分解所采用的虚部分量计算公式为:
[0030]
[0031]
[0032] 更进一步的,所述小波重构所采用的递推公式为:
[0033]
[0034] 本发明实施例的另一目的在于提供一种声纹识别系统,所述系统包括:
[0035] 模型参数求解模块,用于获取训练集,对所述训练集进行小波去噪处理,并将去噪后的所述训练集输入模型训练池进行计算,以求解得到模型参数;
[0036] 模型训练模块,用于根据所述模型参数对声纹模型进行模型参数设置;
[0037] 特征提取模块,用于获取待测语音,对所述待测语音进行所述小波去噪处理,并对去噪后的所述待测语音进行特征提取,以得到语音特征;
[0038] 声纹匹配模块,用于将所述语音特征输入所述声纹模型,并控制所述声纹模型对所述语音特征进行声纹匹配,以得到声纹识别结果。
[0039] 本发明实施例的另一目的在于提供一种移动终端,包括存储设备以及处理器,所述存储设备用于存储计算机程序,所述处理器运行所述计算机程序以使所述移动终端执行上述的声纹识别方法。
[0040] 本发明实施例的另一目的在于提供一种存储介质,其存储有上述的移动终端中所使用的计算机程序,该计算机程序被处理器执行时实现上述的声纹识别方法的步骤。
[0041] 本发明实施例,通过对训练集和待识别语音进行小波去噪处理的设计,能有效的提升训练后的声纹模型的准确度,降低了背景环境噪声对声纹识别的影响,且有效的提高了同一语音或者不同语音片段在不同环境噪声下的识别准确率。
附图说明
[0042] 图1是本发明第一实施例提供的声纹识别方法的流程图;
[0043] 图2是本发明第二实施例提供的声纹识别方法的流程图;
[0044] 图3是本发明第三实施例提供的声纹识别系统的结构示意图;
[0045] 图4是本发明第四实施例提供的移动终端的结构示意图。
具体实施方式
[0046] 为了使本发明的目的、技术方案及优点更加清楚明白,以下结合附图及实施例,对本发明进行进一步详细说明。应当理解,此处所描述的具体实施例仅仅用以解释本发明,并不用于限定本发明。
[0047] 为了说明本发明所述的技术方案,下面通过具体实施例来进行说明。
[0048] 实施例一
[0049] 请参阅图1,是本发明第一实施例提供的声纹识别方法的流程图,包括步骤:
[0050] 步骤S10,获取训练集,对所述训练集进行小波去噪处理,并将去噪后的所述训练集输入模型训练池进行计算,以求解得到模型参数;
[0051] 其中,该训练集中至少设有一个子集,该子集的数量和数据可以根据需求进行设置,该小波去噪处理用于对该训练集中的噪声数据进行降噪,具体的,该小波去噪处理所采用的去噪方式可以为:小波分解与重构法去噪、非线性小波变换阈值法去噪、平移不变量小波去噪或小波变换模极大值法去噪;
[0052] 优选的,本实施例中,该模型训练池可以根据需求进行选择,该步骤中采用的是高斯混合(GMM)模型训练池,优选的,该步骤可以采用最大期望算法(EM)算法以进行该模型参数的求解,因此,该步骤中求解得到的是GMM模型参数,该GMM模型参数用于进行模型参数的设置;
[0053] 步骤S20,根据所述模型参数对声纹模型进行模型参数设置;
[0054] 步骤S30,获取待测语音,对所述待测语音进行所述小波去噪处理,并对去噪后的所述待测语音进行特征提取,以得到语音特征;
[0055] 其中,对该待测语音的小波去噪处理与训练集的相同,且该步骤中可以通过采用MFCC算法的方式以提取该语音特征,以得到梅尔倒谱系数(Me l‑sca leFrequencyCepstralCoefficients);
[0056] 具体的,该梅尔倒谱系数的提取方式包括:预加重‑分帧‑加窗‑FFT处理‑滤波器处理‑对数运算‑离散余弦变换,优选的,该步骤中可以通过将该去噪后的所述待测语音输入梅尔滤波器组,以得到该MFCC特征;
[0057] 步骤S40,将所述语音特征输入所述声纹模型,并控制所述声纹模型对所述语音特征进行声纹匹配,以得到声纹识别结果;
[0058] 其中,将MFCC特征输入GMM声纹模型,并通过控制该GMM声纹模型将该MFCC特征与本地的样本特征进行声纹匹配,以判断针对该MFCC特征在本地是否对应存在样本特征;
[0059] 具体的,该步骤中,当判断到MFCC特征与样本特征声纹匹配成功时,则判定发出该待识别语音的用户与该样本特征对应的用户为同一用户;
[0060] 本实施例,通过对训练集和待识别语音进行小波去噪处理的设计,能有效的提升训练后的声纹模型的准确度,降低了背景环境噪声对声纹识别的影响,且有效的提高了同一语音或者不同语音片段在不同环境噪声下的识别准确率。
[0061] 实施例二
[0062] 请参阅图2,是本发明第二实施例提供的声纹识别方法的流程图,包括步骤:
[0063] 步骤S11,获取训练集,对所述训练集中的每个子集分别进行小波分解,以得到多个小波信号,并根据多个不同的预设频段对所述小波信号进行分类;
[0064] 其中,小波的多分辨分析特性能将信号在不同尺度下进行多分辨率的分解,并将交织在一起的各种不同频率组成的混合信号分解成不同频段的子信号,因而对信号具有按频带处理的能力,因此,该步骤中能通过将训练集中的有效音频和噪声进行小波分解,并基于分解结果有效的方便了针对性的进行降噪,进而有效的对信号和噪声得到了简化,提高了收敛时间和去噪效果;
[0065] 优选的,该步骤中,该预设频段的数量和频段范围的参数可以根据需求进行选择,且通过根据多个不同的预设频段对所述小波信号进行分类的设计,有效的方便了后续在各个频段分别进行数据的自适应去噪;
[0066] 具体的,本实施例中,所述小波分解所采用的实部分量计算公式为:
[0067]
[0068]
[0069] 所述小波分解所采用的虚部分量计算公式为:
[0070]
[0071]
[0072] 此外,该步骤中可以根据需求进行小波和小波分解层数的选择,例如选择的是Symmlet8小波,小波分别层数为4层;
[0073] 步骤S21,分别查询每个所述预设频段对应的去噪方式,并根据所述去噪方式对对应所述预设频段内的所述小波信号进行自适应去噪;
[0074] 其中,本地设有去噪查询表,该去噪查询表中存储有多组不同预设频段与对应去噪方式之间的对应关系,该去噪方式可以采用函数或参数的方式进行滤波器的设置,以使针对性的对各个不同频段的音频数据进行去噪;
[0075] 步骤S31,在每个所述预设频段中对自适应去噪后所述小波信号进行小波重构,并根据重构结果输出每个所述预设频段的小波重构信号;
[0076] 其中,所述小波重构所采用的递推公式为:
[0077]
[0078] 具体的,该步骤中,所述在每个所述预设频段中对自适应去噪后所述小波信号进行小波重构的步骤之前,所述方法还包括:
[0079] 对各个所述预设频段中所述小波信号的小波系数进行加权处理;
[0080] 具体的,加权公式为:
[0081] ak*χk;
[0082] 加权系数为a1,a2,a3...ak,k为预设频段数,a为可调系数,取值范围为0到1;
[0083] 步骤S41,将所述小波重构信号输入预设滤波器,以得到样本声纹特征,并将所述样本声纹特征输入模型训练池,以求解得到模型参数;
[0084] 其中,该预设滤波器可以为梅尔滤波器组,以使能得到对应的MFCC特征,并基于该MFCC特征采用EM算法以进行该模型参数的求解;
[0085] 步骤S51,根据所述模型参数对声纹模型进行模型参数设置;
[0086] 其中,该声纹识别模型可以根据需求进行选择,例如GMM声纹模型或UBM声纹模型等,当该步骤所采用的为UBM声纹模型时,则步骤S10中的模型训练池为UBM模型训练池,求解得到的为UBM模型参数;
[0087] 具体的,该步骤中,GMM声纹模型的概率分布的形式为:
[0088]
[0089] 其中,α是系数,αk≥0, φ(y|θk)φ(y|θk)是高斯分布;
[0090] θk=(μk,σ2k)θk=(μk,σk2), 为第k个高斯分布;
[0091] 步骤S61,获取待测语音,对所述待测语音进行所述小波去噪处理,并对去噪后的所述待测语音进行特征提取,以得到语音特征;
[0092] 其中,对所述待测语音进行所述小波去噪处理所采用的方式与训练集相同,以使将该待测语音中的有效语音和噪声进行频段分类,并基于频段分类结果对应进行自适应去噪处理;
[0093] 步骤S71,将所述语音特征输入所述声纹模型,并控制所述声纹模型对所述语音特征进行声纹匹配,以得到声纹识别结果;
[0094] 具体的,该步骤中,所述控制所述声纹模型对所述语音特征进行声纹匹配的步骤包括:
[0095] 步骤S711,对所述语音特征进行向量转换,以得到特征向量;
[0096] 其中,通对MFCC特征进行向量转换的设计,以输出得到256维的一阶向量;
[0097] 步骤S712,将所述特征向量与本地预存储的声纹库中的样本向量依序进行比对,以得到多个比对值;
[0098] 其中,所述特征向量与所述样本向量之间所采用的比对公式为欧式距离公式,所述欧式距离公式为:
[0099]
[0100] 其中,通过使用欧式距离公式将当前特征值(一阶向量)和声纹库已存在的特征值(样本向量)做1:N检索打分,以得到该比对值;
[0101] 步骤S713,获取所述比对值中的最大值,并判断所述最大值是否大于或等于比对阈值;
[0102] 其中,该比对阈值可以根据需求进行参数设置,例如该比对阈值可以为0.8、0.9或0.95等,该比对阈值用于判断该语音特征与本地预存储的样本特征是否一致;
[0103] 步骤S714,当判断到所述最大值大于或等于所述比对阈值时,获取所述最大值对应的所述样本向量的用户标识,并将所述用户标识进行输出;
[0104] 其中,该用户标识可以采用文字、数字、编号、图像或生物特征的方式进行存储,该用户标识用于指向对应用户,例如当采用文字的方式进行该用户标识的存储时,该用户标识可以为用户姓名,例如“张三”、“李四”等;
[0105] 当采用编号的方式进行该用户标识的存储时,该用户标识可以为用户工号,当采用图像的方式进行该用户标识的存储时,该用户标识为用户的头像图片;
[0106] 步骤S715,当判断到所述最大值小于所述比对阈值时,发出声纹识别错误提示;
[0107] 本实施例中,通过对训练集和待识别语音进行小波去噪处理的设计,能有效的提升训练后的声纹模型的准确度,降低了背景环境噪声对声纹识别的影响,且有效的提高了同一语音或者不同语音片段在不同环境噪声下的识别准确率。
[0108] 实施例三
[0109] 请参阅图3,是本发明第三实施例提供的声纹识别系统100的结构示意图,包括:模型参数求解模块10、模型训练模块11、特征提取模块12和声纹匹配模块13,其中:
[0110] 模型参数求解模块10,用于获取训练集,对所述训练集进行小波去噪处理,并将去噪后的所述训练集输入模型训练池进行计算,以求解得到模型参数。
[0111] 其中,所述模型参数求解模块10还用于:对所述训练集中的每个子集分别进行小波分解,以得到多个小波信号;
[0112] 根据多个不同的预设频段对所述小波信号进行分类;
[0113] 分别查询每个所述预设频段对应的去噪方式,并根据所述去噪方式对对应所述预设频段内的所述小波信号进行自适应去噪;
[0114] 在每个所述预设频段中对自适应去噪后所述小波信号进行小波重构,并根据重构结果输出每个所述预设频段的小波重构信号;
[0115] 将所述小波重构信号输入预设滤波器,以得到样本声纹特征。
[0116] 具体的,所述模型参数求解模块10中,所述小波分解所采用的实部分量计算公式为:
[0117]
[0118]
[0119] 所述小波分解所采用的虚部分量计算公式为:
[0120]
[0121]
[0122] 所述小波重构所采用的递推公式为:
[0123]
[0124] 优选的,所述模型参数求解模块10还用于:对各个所述预设频段中所述小波信号的小波系数进行加权处理。
[0125] 模型训练模块11,用于根据所述模型参数对声纹模型进行模型参数设置。
[0126] 特征提取模块12,用于获取待测语音,对所述待测语音进行所述小波去噪处理,并对去噪后的所述待测语音进行特征提取,以得到语音特征。
[0127] 其中,对该待测语音的小波去噪处理与训练集的相同,且该模块中可以通过采用MFCC算法的方式以提取该语音特征,以得到梅尔倒谱系数;具体的,该梅尔倒谱系数的提取方式包括:预加重‑分帧‑加窗‑FFT处理‑滤波器处理‑对数运算‑离散余弦变换,优选的,该模块中可以通过将该去噪后的所述待测语音输入梅尔滤波器组,以得到该MFCC特征。
[0128] 声纹匹配模块13,用于将所述语音特征输入所述声纹模型,并控制所述声纹模型对所述语音特征进行声纹匹配,以得到声纹识别结果,其中,将MFCC特征输入GMM声纹模型,并通过控制该GMM声纹模型将该MFCC特征与本地的样本特征进行声纹匹配,以判断针对该MFCC特征在本地是否对应存在样本特征;
[0129] 具体的,该模块中,当判断到MFCC特征与样本特征声纹匹配成功时,则判定发出该待识别语音的用户与该样本特征对应的用户为同一用户。
[0130] 本实施例中,所述声纹匹配模块13还用于:对所述语音特征进行向量转换,以得到特征向量;
[0131] 将所述特征向量与本地预存储的声纹库中的样本向量依序进行比对,以得到多个比对值;
[0132] 获取所述比对值中的最大值,并判断所述最大值是否大于或等于比对阈值;
[0133] 当判断到所述最大值大于或等于所述比对阈值时,获取所述最大值对应的所述样本向量的用户标识,并将所述用户标识进行输出;
[0134] 当判断到所述最大值小于所述比对阈值时,发出声纹识别错误提示。
[0135] 优选的,所述声纹匹配模块13中,所述特征向量与所述样本向量之间所采用的比对公式为欧式距离公式,所述欧式距离公式为:
[0136]
[0137] 本实施例,通过对训练集和待识别语音进行小波去噪处理的设计,能有效的提升训练后的声纹模型的准确度,降低了背景环境噪声对声纹识别的影响,且有效的提高了同一语音或者不同语音片段在不同环境噪声下的识别准确率。
[0138] 实施例四
[0139] 请参阅图4,是本发明第四实施例提供的移动终端101,包括存储设备以及处理器,所述存储设备用于存储计算机程序,所述处理器运行所述计算机程序以使所述移动终端101执行上述的声纹识别方法。
[0140] 本实施例还提供了一种存储介质,其上存储有上述移动终端101中所使用的计算机程序,该程序在执行时,包括如下步骤:
[0141] 获取训练集,对所述训练集进行小波去噪处理,并将去噪后的所述训练集输入模型训练池进行计算,以求解得到模型参数;
[0142] 根据所述模型参数对声纹模型进行模型参数设置;
[0143] 获取待测语音,对所述待测语音进行所述小波去噪处理,并对去噪后的所述待测语音进行特征提取,以得到语音特征;
[0144] 将所述语音特征输入所述声纹模型,并控制所述声纹模型对所述语音特征进行声纹匹配,以得到声纹识别结果。所述的存储介质,如:ROM/RAM、磁碟、光盘等。
[0145] 所属领域的技术人员可以清楚地了解到,为描述的方便和简洁,仅以上述各功能单元、模块的划分进行举例说明,实际应用中,可以根据需要而将上述功能分配由不同的功能单元或模块完成,即将存储装置的内部结构划分成不同的功能单元或模块,以完成以上描述的全部或者部分功能。实施方式中的各功能单元、模块可以集成在一个处理单元中,也可以是各个单元单独物理存在,也可以两个或两个以上单元集成在一个单元中,上述集成的单元既可以采用硬件的形式实现,也可以采用软件功能单元的形式实现。另外,各功能单元、模块的具体名称也只是为了便于相互区分,并不用于限制本申请的保护范围。
[0146] 本领域技术人员可以理解,图3中示出的组成结构并不构成对本发明的声纹识别系统的限定,可以包括比图示更多或更少的部件,或者组合某些部件,或者不同的部件布置,而图1‑2中的声纹识别方法亦采用图3中所示的更多或更少的部件,或者组合某些部件,或者不同的部件布置来实现。本发明所称的单元、模块等是指一种能够被所述目标声纹识别系统中的处理器(图未示)所执行并功能够完成特定功能的一系列计算机程序,其均可存储于所述目标声纹识别系统的存储设备(图未示)内。
[0147] 以上所述仅为本发明的较佳实施例而已,并不用以限制本发明,凡在本发明的精神和原则之内所作的任何修改、等同替换和改进等,均应包含在本发明的保护范围之内。
专利地区:福建
专利申请日期:2020-02-17
专利公开日期:2022-12-30
专利公告号:CN111312259B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




