 产学研创新服务平台(全国)


基于增强学习的水下机器人姿态控制方法发明专利
更新时间:2026-11-02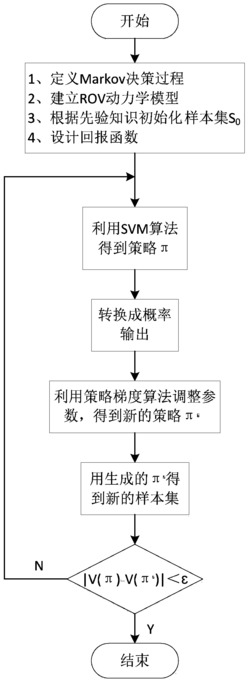 专利申请类型:发明专利;
地区:江苏-镇江;
源自:镇江高价值专利检索信息库;
基于增强学习的水下机器人姿态控制方法
摘要:本发明公开了一种基于增强学习的水下机器人姿态控制方法,结合支持向量机的策略梯度增强学习算法,实现水下机器人在水下进行悬停定点作业,首先定义马尔科夫决策过程,利用先验知识,得到一些样本点,然后根据这些样本点利用SVM生成初始策略,再利用策略梯度算法对初始策略进行改进,根据改进后的策略生成新的样本点,再一次利用SVM生成策略,在此策略的基础上调整参数,将以上过程循环,得到最优的策略,最后将通过增强学习的控制器应用到实际的水下机器人系统中。本发明采用结合支持向量机的策略梯度增强学习算法,解决水下机器人动力学模型难以建立的问题,在学习过程中可以克服各种不确定性,更好地逼近最优策略,提高系统的控制精度。
专利类型:发明专利
专利申请号:CN201911079467.9
专利申请(专利权)人:江苏科技大学
权利人地址:江苏省镇江市京口区梦溪路2号
专利发明(设计)人: 朱延栓 ,戴晓强 ,赵强 ,袁文华
主权利要求:基于增强学习的水下机器人姿态控制方法
技术领域
[0001] 本发明涉及一种水下机器人姿态控制方法,尤其涉及一种基于增强学习的水下机器人姿态控制方法。
背景技术
[0002] 水下救援作业的重点是水下搜寻和水下救援作业,利用人力搜救是有限的,这些任务完全可以由水下机器人来完成。水下机器人最大的特点是深水作业能力强,操作简便,操作员在地面控制室通过控制台的简单按钮就可以遥控机器人在水下进行高难度的作业。水下机器人能够在潜水员不能达到的深度和不安全的水域,完成高强度、大负荷的水下救援作业。当搜救型水下机器人进行水下悬停作业时,由于受到机械手以及水流等干扰因素的影响,且机械手的姿态和持重、载荷等情况,水流情况很难定量得出,这对水下机器人的控制系统提出了更高的要求。这就需要采用环境适应性非常强的控制方法来解决水下机器人(ROV)定点作业的稳定性。
[0003] 目前常用的水下机器人姿态控制的算法有:PID控制、滑模控制、自适应控制、智能控制以及这些方法的组合控制等。PID控制是应用最广泛的控制算法,但是在偏离工作点之外的区域,PID控制器往往难以取得满意的控制性能,而且PID控制本身不具备自适应能力。抖振现象是滑模控制应用于实际控制问题的最大障碍之一。自适应控制以精确的数学模型为基础,主要建立在线性控制理论的基础之上,并且要求闭环系统对于各种干扰具有强抑制能力以及对参数变化具有低敏感性,能在各种工况和环境下稳定运行,这些限制条件在很大程度上影响了自适应控制在水下机器人运动控制中的应用。智能控制是较为先进的控制算法,但是其控制器参数只能在全局范围内调整,没有局部调整能力,故不能实现最佳匹配。
[0004] 近年来,增强学习算法在水下机器人控制领域得到了一定的发展。Carreras研究组基于Baxter和Bartlett的直接梯度算法OLPOMDP提出了一种增强学习直接策略梯度搜索方法(RLDPS),用以解决自主水下机器人的动作选择问题。策略用一个神经网络表示,其输入是状态,输出是动作选择概率,权值是策略参数。该算法易于实现,而且计算时间大为缩短。但在URIS和GARBI水下机器人上进行的仿真试验表明,若要寻找最优解,则其收敛速度将非常缓慢。
发明内容
[0005] 发明目的:针对以上问题,本发明提出一种基于增强学习的水下机器人姿态控制方法,实现搜救型水下机器人在有外界扰动及机械手动作影响下,能够进行稳定悬停作业。
[0006] 技术方案:为实现本发明的目的,本发明所采用的技术方案是:一种基于增强学习的水下机器人姿态控制方法,包括步骤:
[0007] (1)构建基于马尔科夫序列的水下机器人动力学模型和回报函数;
[0008] (2)引入先验知识,利用支持向量机算法作为函数逼近器,寻找最优策略;
[0009] (3)将通过增强学习的控制器应用到水下机器人系统中。
[0010] 进一步地,所述步骤1中,水下机器人动力学模型为:
[0011]
[0012]
[0013] 其中,M是由刚体惯性和附加质量组成的惯性矩阵,C(ζ)是刚体项和附加质量项组成的哥式力和向心力矩阵,D(ζ)是由阻力引起的阻尼矩阵,g(n)是由重力和浮力引起的恢复力与力矩矢量,B是取决于推进器配置的控制矩阵,u是机器人推进器提供的力与力矩矢量;
[0014] 是机器人在地球坐标系中的姿态,包括三维位置和三个欧拉T
角;ξ=(u,v,w,p,q,r) 是机器人在载体坐标系中的速度矢量,包括三个方向的线速度和角速度。
[0015] 进一步地,所述步骤1中,回报函数为:
[0016]
[0017] 其中,c1,c2是反映姿态误差e和误差变化率 对控制性能影响权重的系数;
[0018] 策略优化目标函数为:
[0019]
[0020] 其中,γ为折扣因子,0<γ<1。
[0021] 进一步地,所述步骤2具体包括:
[0022] (2.1)根据先验知识生成初始训练样本集St={(e1,u1),(e2,u2),...(en,un)},t=0;其中,e是增强学习控制器的状态,u是增强学习控制器的输出;
[0023] (2.2)根据样本集St利用支持向量机算法得到策略π;
[0024] (2.3)利用策略梯度算法调整策略π的参数,得到新的策略π’;
[0025] (2.4)利用新的策略π’生成新的训练样本集St+1={(e1,u1),(e2,u2),…(en,un)};
[0026] (2.5)令t=t+1,继续步骤2.2;
[0027] (2.6)判断第2.2步生成的策略π和在第2.3步生成的策略π’值相等,即得到最优策略π。
[0028] 进一步地,所述步骤2.2中,策略π为:
[0029]
[0030] 其中,f为SVM逼近函数,σ2为样本方差。
[0031] 进一步地,所述步骤2.3具体为,将π(e,u)参数化为π(u|θ,e),利用策略梯度算法调整参数θ,得到新的策略π’,策略梯度算法为:
[0032]
[0033] 其中,Qπ(e,u)为马尔科夫决策行为值函数:
[0034]
[0035] 进一步地,所述步骤2.6的判断条件为|V(π)‑V(π’)|<ε,ε为预先指定的某个很小的正数。
[0036] 进一步地,所述步骤2.6中最优策略π满足目标函数J得到最大值。
[0037] 有益效果:本发明充分利用水下机器人运动的先验知识,解决在增强学习中学习时间过长的问题,策略梯度方法是基于梯度的,每次参数的更新使得策略性能提高,更好保证系统的安全性。
[0038] 本发明结合支持向量机方法,解决控制器中神经网络存在结构难以确定,容易陷入局部极小的缺点,巧妙解决系统的维数问题,最终获得系统的最优策略。
[0039] 本发明采用结合支持向量机的策略梯度增强学习算法,解决水下机器人动力学模型难以建立的问题,在学习过程中可以克服各种不确定性,更好地逼近最优策略,提高系统的控制精度。
附图说明
[0040] 图1是本发明所述的基于增强学习的水下机器人姿态控制方法流程图。
具体实施方式
[0041] 下面结合附图和实施例对本发明的技术方案作进一步的说明。
[0042] 本发明所述的基于增强学习的水下机器人姿态控制方法,结合支持向量机的策略梯度算法和增强学习算法,首先构建基于马尔科夫序列的水下机器人模型和回报函数,引入先验知识,利用SVM作为函数逼近器,寻找最优策略,最后将通过增强学习的控制器应用到水下机器人系统中。
[0043] 如图1所示,本发明所述的基于增强学习的水下机器人姿态控制方法,包括步骤:
[0044] (1)构建基于马尔科夫序列的水下机器人动力学模型和回报函数;
[0045] 马尔可夫决策过程(MarkovDecisionProcess,MDP)是序贯决策(sequentialdecision)的数学模型,用于在系统状态具有马尔可夫性质的环境中模拟智能体可实现的随机性策略与回报。马尔可夫决策基于一组交互对象,即智能体和环境进行构建,所具有的要素包括状态、动作、策略和奖励。
[0046] 定义马尔科夫决策过程如下:一个离散时间平稳Markov决策过程可以表示为一个五元组,即{S,A,P,r,J},其中,S为环境中所有可能的状态集合;A为空间中的动作集合;P为MDP的状态转移概率,表示在当前s∈S状态下,通过执行动作a∈A后转移到其他状态的概率分布;r:S×A→R为回报函数;J为策略优化的目标函数。
[0047] 对于水下机器人ROV的姿态控制是以地球坐标为标准,所以适用于在地球坐标中研究。构建水下机器人动力学模型方程如下:
[0048]
[0049]
[0050] 其中,M是由刚体惯性和附加质量组成的惯性矩阵,C(ζ)是刚体项和附加质量项组成的哥式力和向心力矩阵,D(ζ)是由阻力引起的阻尼矩阵,g(n)是由重力和浮力引起的恢复力与力矩矢量,B是取决于推进器配置的控制矩阵,u是机器人推进器提供的力与力矩矢量。
[0051] 是机器人在地球坐标系中的姿态,包括三维位置和三个欧拉T
角;ζ=(u,v,w,p,q,r) 是机器人在载体坐标系中的速度矢量,包括三个方向的线速度和角速度。
[0052] 式(2)可以改写为:
[0053]
[0054] 对式(2)求导得到:
[0055]
[0056] 将式(3)代入式(4)有:
[0057]
[0058] 再将式(5)代入式式(1),则可消除大部分载体坐标系中的速度,有:
[0059]
[0060] 对式(6)左右两边均左乘J‑T(η),得到:
[0061]
[0062] 这样就把定义在载体坐标系中的姿态方程转换到了地球坐标系。
[0063] 上述η包含了三维位置和三个欧拉角,但在姿态镇定范畴内,水下机器人的横滚角和俯仰角θ具有自稳定性,扰动消除后能够自行恢复至原平衡状态。
[0064] 因此将地球坐标系中的姿态η分解为动力项和非动力项,即ηa=[x,y,z,ψ]T与[0065] 假设期望姿态是ηd,定义姿态误差为e=ηa‑ηd。对误差求导,得 因此水下机器人的姿态镇定问题可以描述为,设计策略π使得||e||≤δ。
[0066] 设计回报函数:
[0067]
[0068] 其中,c1,c2是反映姿态误差e和误差变化率 对控制性能影响权重的系数。
[0069] 然后选择策略优化的目标函数:
[0070]
[0071] 其中,γ为折扣因子,0<γ<1。
[0072] 定义马尔科夫决策过程的行为值函数:
[0073]
[0074] (2)引入先验知识,利用SVM作为函数逼近器,寻找最优策略;
[0075] 利用先验知识,得到一些样本点,然后根据这些样本点利用支持向量机算法SVM生成初始策略,再利用策略梯度算法对初始策略进行改进,根据改进后的新策略生成新的样本点,再一次利用SVM生成策略,在此策略的基础上调整参数,将以上过程循环,得到最优的策略。
[0076] SVM根据有限的样本信息在模型的复杂性和学习能力之间寻求最佳折衷,以期获得最好的泛化能力,在形式上类似多层前向神经网络,可用于模式识别和非线性回归。SVM算法具体步骤如下:
[0077] (1)给定先验知识,并令t=0;
[0078] (2)利用先验知识生成初始的训练样本集S0={(e1,u1),(e2,u2),...(en,un)};
[0079] 其中,ei是增强学习控制器中的状态,ui是增强学习控制器的输出。
[0080] (3)循环;
[0081] 3.1、根据样本集St利用SVM分类算法得到策略π;
[0082] 利用SVM的逼近算法来获得策略方法如下:对于水下机器人此类具有连续行为的问题,策略不再是一个分类器,而是一个逼近函数,所以可以直接利用SVM的逼近算法来获得策略。此时SVM的输出为:
[0083]
[0084] 3.2、把策略π的输出转换成概率输出;
[0085] 将其转换成概率形式,定义实际的概率策略输出为:
[0086]
[0087] 其中,以σ2为方差的高斯分布,参数σ2可调。
[0088] 3.3、利用策略梯度算法调整π的参数,得到新的策略π’;
[0089] 将π(e,u)参数化为π(u|θ,e),利用梯度估计来调整参数θ,其中,参数θ包括参数2
αi、参数b、参数σ,得到新的策略π’,策略梯度算法:
[0090]
[0091] 3.4、利用生成的策略π’训练样本集St+1={(e1,u1),(e2,u2),…(en,un)};
[0092] 3.5、令t=t+1;继续执行步骤3.3;
[0093] 3.6、判断直到在第3.2步生成的策略π和在第3.3步生成的策略π’值相等,也就是|V(π)‑V(π’)|<ε,这里ε为预先指定的某个很小的正数。当得到最终策略π,即满足目标函数J得到最大值。
[0094] (3)将通过增强学习的控制器应用到水下机器人系统中。
[0095] 本发明解决了现有算法中存在的不足,提供了结合策略梯度算法和增强学习算法的连续控制方法,实现搜救型水下机器人在有外界扰动及机械手动作影响下,能够进行稳定悬停作业。
专利地区:江苏
专利申请日期:2019-11-07
专利公开日期:2022-12-30
专利公告号:CN110703792B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




