 产学研创新服务平台(全国)


一种驾驶员状态监测方法、装置及系统发明专利
更新时间:2026-11-01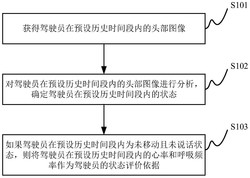 专利申请类型:发明专利;
源自:北京高价值专利检索信息库;
一种驾驶员状态监测方法、装置及系统
摘要:本申请公开一种驾驶员状态监测方法、装置及系统。该方法包括:获得驾驶员在预设历史时间段内的头部图像,其中,驾驶员的头部图像由图像采集装置生成;对驾驶员在预设历史时间段内的头部图像进行分析,确定驾驶员在预设历史时间段内的状态;如果驾驶员在预设历史时间段内为未移动且未说话状态,则将驾驶员在预设历史时间段内的心率和呼吸频率作为驾驶员的状态评价依据,其中,驾驶员的心率和呼吸频率由基于微波多普勒效应的检测设备生成。基于本申请公开的技术方案,能够方便地测量驾驶员的心率和呼吸频率,并保证测量结果具有较高的准确性。
专利类型:发明专利
专利申请号:CN202111041977.4
专利申请(专利权)人:北京经纬恒润科技股份有限公司
权利人地址:北京市朝阳区酒仙桥路14号1幢4层
专利发明(设计)人: 成一诺 ,冉洪亮 ,郭健
主权利要求:一种驾驶员状态监测方法、装置及系统
技术领域
[0001] 本申请属于行车安全控制技术领域,尤其涉及一种驾驶员状态监测方法、装置及系统。
背景技术
[0002] 随着交通运输业和汽车制造业的持续快速发展,人们对出行的要求越来越高,汽车逐渐成为人们日常出行重要的代步工具之一。汽车给人们的日常生活带来舒适、便捷的同时,随之发生的交通事故直接危害驾驶员和他人的生命财产安全。
[0003] 研究数据表明,患有心脑血管疾病的驾驶员比正常驾驶员发生交通事故的概率高23%,国外路面交通事故中,大约11%的事故跟驾驶员的心脏疾病有关。另外,疲劳驾驶也是造成交通事故的重要因素之一,据统计,超过30%的公路交通事故与疲劳驾驶有关。监测驾驶员的心率和呼吸频率是发现心脑血管疾病发作症状和疲劳驾驶症状的一个有效方法。
[0004] 目前,主要通过以下方式测量驾驶员的心率和呼吸频率:第一,使用接触式检测设备测量驾驶员的心率和呼吸频率,例如,使用PPG(PhotoPlethysmoGraphic,光电容积脉搏波描记法)心率传感器、PVDF(PolyvinylideneFluoride,聚偏氟乙烯)压电薄膜传感器、脉搏信号采集装置测量驾驶员的心率和呼吸频率;第二,使用非接触式检测设备测量驾驶员的心率和呼吸频率,如毫米波雷达。
[0005] 但是,现有的测量驾驶员的心率和呼吸频率的方案存在弊端:采用第一种方案,驾驶员必须佩戴接触式检测设备,不够方便;采用第二种方案,往往存在测量结果准确性不足的问题。因此,如何方便地测量驾驶员的心率和呼吸频率,并保证测量结果具有较高的准确性,是本领域技术人员亟待解决的问题。
发明内容
[0006] 有鉴于此,本申请的目的在于提供一种驾驶员状态监测方法、装置及系统,能够方便地测量驾驶员的心率和呼吸频率,并保证测量结果具有较高的准确性。
[0007] 为实现上述目的,本申请提供如下技术方案:
[0008] 一方面,本申请提供一种驾驶员状态监测方法,该方法应用于处理器,包括:
[0009] 获得驾驶员在预设历史时间段内的头部图像,其中,所述驾驶员的头部图像由图像采集装置生成;
[0010] 对所述驾驶员在所述预设历史时间段内的头部图像进行分析,确定所述驾驶员在所述预设历史时间段内的状态;
[0011] 如果所述驾驶员在所述预设历史时间段内为未移动且未说话状态,则将所述驾驶员在所述预设历史时间段内的心率和呼吸频率作为所述驾驶员的状态评价依据,其中,所述驾驶员的心率和呼吸频率由基于微波多普勒效应的检测设备生成。
[0012] 可选的,所述对所述驾驶员在所述预设历史时间段内的头部图像进行分析,确定所述驾驶员在所述预设历史时间段内的状态,包括:
[0013] 从所述驾驶员在所述预设历史时间段内的头部图像中获取N帧图像,N为大于2的整数;
[0014] 对所述N帧图像进行分析,得到N个头部特征数据集和N个嘴部特征数据集,其中,每个头部特征数据集包括多种头部特征数据,所述头部特征数据为头部特征点的横坐标或者纵坐标,所述N个头部特征数据集中包含的头部特征数据的种类相同,每个嘴部特征数据集包括多种嘴部特征数据,所述嘴部特征数据为嘴部特征点的纵坐标,所述N个嘴部特征数据集中包含的嘴部特征数据的种类相同;
[0015] 基于所述N个头部特征数据集确定所述驾驶员在所述预设历史时间段内是否移动;
[0016] 基于所述N个嘴部特征数据集确定所述驾驶员在所述预设历史时间段内是否说话。
[0017] 可选的,所述基于所述N个头部特征数据集确定所述驾驶员在所述预设历史时间段内是否移动,包括:
[0018] 确定所述N个头部特征数据集中每一种头部特征数据的标准差值;
[0019] 根据所述N个头部特征数据集中各种头部特征数据的标准差值确定所述N个头部特征数据集之间的最大标准差值;
[0020] 如果所述最大标准差值小于或等于所述第一阈值,则确定所述驾驶员在所述预设历史时间段内未移动,否则,确定所述驾驶员在所述预设历史时间段内发生移动。
[0021] 可选的,所述基于所述N个头部特征数据集确定所述驾驶员在所述预设历史时间段内是否移动,包括:
[0022] 将所述N个头部特征数据集输入预先完成训练的第一判别模型,得到所述第一判别模型对所述N个头部特征数据集处理后输出的预测结果;
[0023] 根据所述预测结果确定所述驾驶员在所述预设历史时间段内是否移动。
[0024] 可选的,所述基于所述N个头部特征数据集确定所述驾驶员在所述预设历史时间段内是否移动,包括:
[0025] 将所述N个头部特征数据集输入预先完成训练的第一判别模型,得到所述第一判别模型对所述N个头部特征数据集处理后输出的预测结果;
[0026] 确定所述N个头部特征数据集中每一种头部特征数据的标准差值;
[0027] 根据所述N个头部特征数据集中各种头部特征数据的标准差值确定所述N个头部特征数据集之间的最大标准差值;
[0028] 如果所述最大标准差值小于或等于第一阈值,且所述预测结果指示所述驾驶员在所述预设历史时间段内未移动,则确定所述驾驶员在所述预设历史时间段内未移动,否则,确定所述驾驶员在所述预设历史时间段内发生移动。
[0029] 可选的,所述基于所述N个嘴部特征数据集确定所述驾驶员在所述预设历史时间段内是否说话,包括:
[0030] 根据所述N个嘴部特征数据集确定所述驾驶员的双唇上边缘距离的标准差值、以及双唇下边缘距离的标准差值;
[0031] 如果所述驾驶员的双唇上边缘距离的标准差值和双唇下边缘距离的标准差值均小于或等于第二阈值,则确定所述驾驶员在所述预设历史时间段内未说话,否则,确定所述驾驶员在所述预设历史时间段内说话。
[0032] 可选的,所述基于所述N个嘴部特征数据集确定所述驾驶员在所述预设历史时间段内是否说话,包括:
[0033] 将所述N个嘴部特征数据集输入预先完成训练的第二判别模型,得到所述第二判别模型对所述N个嘴部特征数据集处理后输出的预测结果;
[0034] 根据所述预测结果确定所述驾驶员在所述预设历史时间段内是否说话。
[0035] 可选的,所述基于所述N个嘴部特征数据集确定所述驾驶员在所述预设历史时间段内是否说话,包括:
[0036] 将所述N个嘴部特征数据集输入预先完成训练的第二判别模型,得到所述第二判别模型对所述N个嘴部特征数据集处理后输出的预测结果;
[0037] 根据所述N个嘴部特征数据集确定所述驾驶员的双唇上边缘距离的标准差值、以及双唇下边缘距离的标准差值;
[0038] 如果所述驾驶员的双唇上边缘距离的标准差值和双唇下边缘距离的标准差值均小于或等于第二阈值,且所述预测结果指示驾驶员在预设历史时间段内未说话,则确定所述驾驶员在所述预设历史时间段内未说话,否则,确定所述驾驶员在所述预设历史时间段内说话。
[0039] 另一方面,本申请提供一种驾驶员状态监测装置,包括:
[0040] 头部图像获取模块,用于获得驾驶员在预设历史时间段内的头部图像,其中,所述驾驶员的头部图像由图像采集装置生成;
[0041] 状态分析模块,用于对所述驾驶员在所述预设历史时间段内的头部图像进行分析,确定所述驾驶员在所述预设历史时间段内的状态;
[0042] 数据处理模块,用于如果所述驾驶员在所述预设历史时间段内为未移动且未说话状态,则将所述驾驶员在所述预设历史时间段内的心率和呼吸频率作为所述驾驶员的状态评价依据,其中,所述驾驶员的心率和呼吸频率由基于微波多普勒效应的检测设备生成。
[0043] 另一方面,本申请提供一种驾驶员状态监测系统,包括:
[0044] 图像采集装置,用于采集驾驶员的头部图像;
[0045] 检测装置,用于基于微波多普勒效应测量所述驾驶员的心率和呼吸频率;
[0046] 处理器,用于获得驾驶员在预设历史时间段内的头部图像,对所述驾驶员在所述预设历史时间段内的头部图像进行分析,确定所述驾驶员在所述预设历史时间段内的状态,如果所述驾驶员在所述预设历史时间段内为未移动且未说话状态,则将所述驾驶员在所述预设历史时间段内的心率和呼吸频率作为所述驾驶员的状态评价依据。
[0047] 由此可见,本申请的有益效果为:
[0048] 本申请公开的驾驶员状态监测方法、装置及系统,利用检测设备测量驾驶员的心率和呼吸频率,利用图像采集装置采集驾驶员的头部图像,通过对驾驶员在预设历史时间段内的头部图像进行分析,确定驾驶员在该预设历史时间段内的状态,如果确定驾驶员在该预设历史时间段内未移动且未说话,那么检测设备在该预设历史时间段内测量得到的驾驶员的心率和呼吸频率具有较高的准确性,将其作为驾驶员的状态评价依据。可以看到,检测设备基于微波多普勒效应测量驾驶员的心率和呼吸频率,能够方便地测量驾驶员的心率和呼吸频率;另外,通过对图像采集装置采集的驾驶员的头部图像进行分析,确定驾驶员在预设历史时间段内的状态,如果驾驶员在该预设历史时间段内未移动且未说话,那么表明检测设备在该预设历史时间段内测量得到的驾驶员的心率和呼吸频率具有较高的准确性,将在该时间段内测量得到的驾驶员的心率和呼吸频率作为驾驶员的状态评价依据,能够准确地评价驾驶员的健康状态和驾驶状态。
附图说明
[0049] 为了更清楚地说明本申请实施例或现有技术中的技术方案,下面将对实施例或现有技术描述中所需要使用的附图作简单地介绍,显而易见地,下面描述中的附图是本申请的一些实施例,对于本领域普通技术人员来讲,在不付出创造性劳动的前提下,还可以根据这些附图获得其他的附图。
[0050] 图1为本申请公开的一种驾驶员状态检测方法的流程图;
[0051] 图2为本申请公开的驾驶员状态检测方法的应用场景示意图;
[0052] 图3为本申请公开的确定驾驶员在预设历史时间段内的状态的方法的流程图;
[0053] 图4为本申请公开的脸部特征点的示意图;
[0054] 图5为本申请公开的头部区域顶点的示意图;
[0055] 图6为本申请公开的训练第一判别模型的方法的流程图;
[0056] 图7为本申请公开的一种驾驶员状态检测装置的结构示意图。
具体实施方式
[0057] 本申请公开一种驾驶员状态监测方法、装置及系统,能够方便地测量驾驶员的心率和呼吸频率,并保证测量结果具有较高的准确性。
[0058] 为使本申请实施例的目的、技术方案和优点更加清楚,下面将结合本申请实施例中的附图,对本申请实施例中的技术方案进行清楚、完整地描述,显然,所描述的实施例是本申请一部分实施例,而不是全部的实施例。基于本申请中的实施例,本领域普通技术人员在没有做出创造性劳动前提下所获得的所有其他实施例,都属于本申请保护的范围。
[0059] 参见图1,图1为本申请公开的一种驾驶员状态检测方法的流程图。该方法应用于处理器,包括:
[0060] S101:获得驾驶员在预设历史时间段内的头部图像。
[0061] 其中,驾驶员的头部图像由图像采集装置生成。
[0062] 实施中,可以将图像采集装置布置于汽车的A柱上,以保证图像采集装置采集驾驶员完整的头部图像。
[0063] 可选的,图像采集装置采用摄像机。当然,也可以采用其他的图像采集设备,如相机。
[0064] S102:对驾驶员在预设历史时间段内的头部图像进行分析,确定驾驶员在预设历史时间段内的状态。
[0065] S103:如果驾驶员在预设历史时间段内为未移动且未说话状态,则将驾驶员在预设历史时间段内的心率和呼吸频率作为驾驶员的状态评价依据。
[0066] 其中,驾驶员的心率和呼吸频率由基于微波多普勒效应的检测设备生成。
[0067] 当驾驶员位于检测设备的检测区域内时,检测设备可以测量得到驾驶员的心率和呼吸频率。实施中,可以将检测设备布置于驾驶员座椅的靠背处,如图2中所示。在图2中,201为汽车的A柱,202为图像采集装置,203为处理器,204为检测设备,205为驾驶员座椅。
[0068] 需要说明的是,当驾驶员保持静止状态时,检测设备能够准确地测量驾驶员的心率和呼吸频率。如果驾驶员未处于静止状态,检测设备获得的驾驶员的心率和呼吸频率的准确性将无法保证。这是现有技术中的第二个方案不能保证测量结果的准确性的根本原因。
[0069] 需要说明的是,本申请中的静止状态不是绝对静止状态,而是指:驾驶员未大幅度移动,也未说话。
[0070] 可选的,检测设备采用毫米波雷达。当然,也可以采用其他的非接触式检测设备,具备测量驾驶员的心率和呼吸频率功能即可。
[0071] 当驾驶员保持静止状态时,检测设备能够准确地测量驾驶员的心率和呼吸频率。通过对图像采集装置采集的驾驶员的头部图像进行分析,确定驾驶员在预设历史时间段内(如过去的2秒内)的状态,也就是确定驾驶员在该预设历史时间段内是否未移动且未说话。
如果确定驾驶员在该预设历史时间段内处于未移动且未说话状态,那么检测设备在该预设历史时间段内测量得到的驾驶员的心率和呼吸频率是准确的,因此,将检测设备在该预设历史时间段内测量得到的驾驶员的心率和呼吸频率作为驾驶员的状态评价依据,以便对驾驶员的健康状态和驾驶状态进行准确的评价。
[0072] 需要说明的是,驾驶员未移动是指驾驶员未发生大幅度的移动,而不是指驾驶员保持绝对的不动。
[0073] 在一种可能的实现方式中,当确定驾驶员在预设历史时间段内为未移动且未说话状态时,利用驾驶员在该预设历史时间段内的心率和呼吸频率,确定驾驶员的状态。
[0074] 在另一种可能的实现方式中,利用驾驶员在多个历史时间段内的心率和呼吸频率,确定驾驶员的状态,其中,驾驶员在前述多个历史时间段内均处于未移动且未说话状态,前述多个历史时间段可能是连续的,也可能是非连续的。其中,根据驾驶员的心率和呼吸频率确定驾驶员的状态的过程,可以基于现有的算法实现。
[0075] 本申请公开的驾驶员状态监测方法,利用检测设备测量驾驶员的心率和呼吸频率,利用图像采集装置采集驾驶员的头部图像,通过对驾驶员在预设历史时间段内的头部图像进行分析,确定驾驶员在该预设历史时间段内的状态,如果确定驾驶员在该预设历史时间段内未移动且未说话,那么检测设备在该预设历史时间段内测量得到的驾驶员的心率和呼吸频率具有较高的准确性,将其作为驾驶员的状态评价依据。可以看到,检测设备基于微波多普勒效应测量驾驶员的心率和呼吸频率,能够方便地测量驾驶员的心率和呼吸频率;另外,通过对图像采集装置采集的驾驶员的头部图像进行分析,确定驾驶员在预设历史时间段内的状态,如果驾驶员在该预设历史时间段内未移动且未说话,那么表明检测设备在该预设历史时间段内测量得到的驾驶员的心率和呼吸频率具有较高的准确性,将在该时间段内测量得到的驾驶员的心率和呼吸频率作为驾驶员的状态评价依据,能够准确地评价驾驶员的健康状态和驾驶状态。
[0076] 在本申请的另一个实施例中,对驾驶员在预设历史时间段内的头部图像进行分析,确定驾驶员在预设历史时间段内的状态,采用如图3所示的方案。具体包括:
[0077] S301:从驾驶员在预设历史时间段内的头部图像中获取N帧图像,N为大于2的整数。
[0078] 实施中,可以获取该预设历史时间段内采集到的驾驶员的头部图像的全部,也可以获取该预设历史时间段内采集到的驾驶员的头部图像中的一部分。
[0079] S302:对N帧图像进行分析,得到N个头部特征数据集和N个嘴部特征数据集。
[0080] 其中,每个头部特征数据集包括多种头部特征数据,头部特征数据为头部特征点的横坐标或者纵坐标,N个头部特征数据集中包含的头部特征数据的种类相同。每个嘴部特征数据集包括多种嘴部特征数据,嘴部特征数据为嘴部特征点的纵坐标,N个嘴部特征数据集中包含的嘴部特征数据的种类相同。
[0081] 需要说明的是,头部特征点是在头部选定的特征点,嘴部特征点是在嘴部选定的特征点。可以理解的是,头部特征点和嘴部特征点应选定为便于机器识别的点,以便更准确地确定各个头部特征点和嘴部特征点的坐标。
[0082] 另外,需要说明的是,驾驶员的嘴部特征点可以为驾驶员的头部特征点的一部分。
[0083] 这里结合图4和图5进行说明。
[0084] 预设的头部特征点为30个,包括28个脸部特征点和2个头部区域顶点。
[0085] 在图4中,28个脸部特征点依次记为脸部特征点1至脸部特征点28。脸部特征点1为右侧眉毛的外侧顶点,脸部特征点2为右侧眉毛的中间点,脸部特征点3为右侧眉毛的内侧顶点,脸部特征点4为左侧眉毛的内侧顶点,脸部特征点5为左侧眉毛的中间点,脸部特征点6为左侧眉毛的外侧顶点,脸部特征点7为右眼的外眼角,脸部特征点8为右眼的上眼睑中点,脸部特征点9为右眼的内眼角,脸部特征点10为右眼的中心点,脸部特征点11为右眼的下眼睑中点,脸部特征点12为左眼的内眼角,脸部特征点13为左眼的上眼睑中点,脸部特征点14为左眼的外眼角,脸部特征点15为左眼的中心点,脸部特征点16为左眼的下眼睑中点,脸部特征点17为右鼻翼底部,脸部特征点18为鼻尖,脸部特征点19为左鼻翼底部,脸部特征点20为右侧嘴角,脸部特征点21为上唇的上边缘中点,脸部特征点22为左侧嘴角,脸部特征点23为上唇的下边缘中点,脸部特征点24为下唇的上边缘中点,脸部特征点25为下唇的下边缘中点,脸部特征点26为右颧部的边缘点,脸部特征点27为下巴的边缘点,脸部特征点28为左颧部的边缘点。
[0086] 需要说明的是,图4仅是对脸部特征点的一个举例,实施中,脸部特征点可以为图4所示28个脸部特征点中的一部分,也可以多于图4所示的28个脸部特征点。
[0087] 在图5中,2个头部区域顶点为头部最小外切框的左上顶点L1和右下顶点R1。实施中,2个头部区域顶点也可以为头部最小外切框的右上顶点和左下顶点。也就是说,优选头部最小外切框处于对角线位置的两个顶点作为头部特征点。需要说明的是,头部区域顶点并不限定为2个,也可以为1个或者多于2个。
[0088] 可选的,嘴部特征点包括图4中所示的脸部特征点21、脸部特征点23、脸部特征点24和脸部特征点25。
[0089] S303:基于N个头部特征数据集确定驾驶员在预设历史时间段内是否移动。
[0090] S304:基于N个嘴部特征数据集确定驾驶员在预设历史时间段内是否说话。
[0091] 可以理解的是,如果驾驶员移动,那么驾驶员的全部或者部分头部特征点的坐标会发生较大的变化,因此,基于N个头部特征数据集能够确定驾驶员在预设历史时间段内是否移动。另外,如果驾驶员说话,那么驾驶员的上唇和下唇之间的距离会发生变化,因此,基于N个嘴部特征数据及能够确定驾驶员在预设历史时间段内是否说话。
[0092] 在本申请的另一个实施例中,基于N个头部特征数据集确定驾驶员在预设历史时间段内是否移动,采用如下方案:
[0093] A1:确定N个头部特征数据集中每一种头部特征数据的标准差值。
[0094] A2:根据N个头部特征数据集中各种头部特征数据的标准差值确定N个头部特征数据集之间的最大标准差值。
[0095] A3:如果最大标准差值大于第一阈值,则确定驾驶员在预设历史时间段内发生移动,如果最大标准差值小于或等于第一阈值,则确定驾驶员在预设历史时间段内未移动。
[0096] 这里结合图4和图5进行说明。
[0097] 利用图像采集装置在过去2秒内采集的驾驶员的头部图像进行分析,以确定驾驶员在前述2秒内是否移动。
[0098] 首先,按照每秒15帧的频率,在图像采集装置在过去2秒内采集到的驾驶员的头部图像中获取30帧图像。针对30帧图像进行分析,得到30个头部特征数据集,记为:
[0099]
[0100] 其中:该矩阵中的第i行是对第i帧图像进行分析得到的头部特征数据集。针对矩阵中的任意一行,第1列为头部特征点1的横坐标,第2列为头部特征点1的纵坐标,第3列为头部特征点2的横坐标,第4列为头部特征点2的纵坐标,以此类推,第57列为头部特征点29的横坐标,第58列为头部特征点29的纵坐标,第59列为头部特征点30的横坐标,第60列为头部特征点30的纵坐标。
[0101] 之后,分别确定30个头部特征数据集中每一种头部特征数据的标准差值,也就是分别计算上述矩阵中每一列的标准差值。具体的,按照公式(1)计算每一种头部特征数据的标准差值。
[0102]
[0103] 其中:
[0104] σj为N个头部特征数据集中第j种头部特征数据的标准差值,j=1,2,3,…,60;N为头部特征数据集的数量,这里具体为30;ai,j为上述矩阵中位于第i行第j列的元素,也就是第i个头部特征数据集中的第j种头部特征数据;μj为上述矩阵中位于第j列的元素的平均值,也就是N个头部特征数据集中第j种头部特征数据的平均值。
[0105] 在分别确定30个头部特征数据集中60种头部特征数据的标准差值后,确定这60个标准差值中的最大值,该最大值即为30个头部特征数据集之间的最大标准差。如果该最大标准差大于预设的第一阈值,则确定驾驶员在预设历史时间段内发生移动,如果该最大标准差小于或等于该第一阈值,则确定驾驶员在预设历史时间段内未移动。其中,第一阈值为经验值。
[0106] 需要说明的是,本申请中所使用的坐标系,横坐标为左右方向,纵坐标为上下方向。
[0107] 在本申请的另一个实施例中,基于N个头部特征数据集确定驾驶员在预设历史时间段内是否移动,采用如下方案:
[0108] B1:将N个头部特征数据集输入预先完成训练的第一判别模型,得到第一判别模型对N个头部特征数据集处理后输出的预测结果。
[0109] B2:根据预测结果确定驾驶员在预设历史时间段内是否移动。
[0110] 其中,第一判别模型是经过大量头部样本数据训练得到的,每个头部样本数据包括被测人员的N个头部特征数据集,N个头部特征数据是根据被测人员在预设时间段内的头部图像生成的。另外,每个头部样本数据均具有标注信息,标注信息用于指示被测人员在预设时间段内是否发生移动。第一判别模型具备将预测结果趋于实际情况的能力。
[0111] 可选的,第一判别模型输出的预测结果为驾驶员在预设历史时间段内移动的概率值。相应的,如果该概率值大于预设的阈值,则确定驾驶员在预设历史时间段内发生移动,否则,确定驾驶员在预设历史时间段内未移动。
[0112] 在本申请的另一个实施例中,基于N个头部特征数据集确定驾驶员在预设历史时间段内是否移动,采用如下方案:
[0113] C1:将N个头部特征数据集输入预先完成训练的第一判别模型,得到第一判别模型对N个头部特征数据集处理后输出的预测结果。
[0114] C2:确定N个头部特征数据集中每一种头部特征数据的标准差值。
[0115] C3:根据N个头部特征数据集中各种头部特征数据的标准差值确定N个头部特征数据集之间的最大标准差值。
[0116] C4:如果最大标准差值小于或等于第一阈值,且预测结果指示驾驶员在预设历史时间段内未移动,则确定驾驶员在预设历史时间段内未移动;如果最大标准差值大于第一阈值,或者预测结果指示驾驶员在预设历史时间段内发生移动,则确定驾驶员在预设历史时间段内发生移动。
[0117] 在上述实施例中,将N个头部特征数据集输入预先完成训练的第一判别模型,基于第一判别模型输出的预测结果得到一个初级结果,确定N个头部特征数据集之间的最大标准差值,通过比较最大标准差值和第一阈值得到另一个初级结果,如果两个初级结果均指示驾驶员在预设历史时间段内未移动,则确定驾驶员在预设历史时间段内未移动,否则确定驾驶员在预设历史时间段内发生移动,能够更加准确地确定出驾驶员在预设历史时间段内是否发生移动。
[0118] 下面对本申请上述所使用的第一判别模型的训练过程进行说明。
[0119] 参见图6,图6为本申请公开的训练第一判别模型的方法的流程图。该方法包括:
[0120] S601:获得多个头部样本数据。
[0121] 其中,每个头部样本数据包括被测人员的N个头部特征数据集,N个头部特征数据集是根据被测人员在预设时间段内的头部图像生成的。另外,每个头部样本数据均具有标注信息,标注信息用于指示被测人员在预设时间段内是否发生移动。
[0122] 优选的,多个头部样本数据包括正样本数据和负样本数据,以便第一判别模型更好地学习特征,从而提高预测准确度。其中,如果被测人员在预设时间段内发生移动,可以将生成的头部样本数据作为正样本,如果被测人员在预设时间段内未移动,可以将生的头部样本数据作为负样本。
[0123] S602:利用预先构建的学习模型对头部样本数据进行预测,获得预测结果。
[0124] S603:根据预测结果和标注信息调整学习模型,直至调整后的学习模型满足预设收敛条件,将满足预设收敛条件的学习模型确定为第一判别模型。
[0125] 预先构建的学习模型的初始模型参数均为自定义数值,训练学习模型的过程就是优化模型参数,以使得学习模型逐渐收敛,且预测结果的准确率逐渐提高的过程。当学习模型满足预设收敛条件时,将当前的学习模型确定为第一判别模型。
[0126] 在一种可能的实现方式中,预设收敛条件为:预设损失函数的值小于预设的阈值。其中,预设损失函数表征预测结果和标注信息之间的误差。预设的阈值为经验值。
[0127] 在本申请的另一个实施例中,基于N个嘴部特征数据集确定驾驶员在预设历史时间段内是否说话,采用如下方案:
[0128] D1:根据N个嘴部特征数据集确定驾驶员的双唇上边缘距离的标准差值、以及双唇下边缘距离的标准差值。
[0129] D2:如果驾驶员的双唇上边缘距离的标准差值和双唇下边缘距离的标准差值均小于或等于第二阈值,则确定驾驶员在该预设历史时间段内未说话,如果驾驶员的双唇上边缘距离的标准差值大于第二阈值,或者驾驶员的双唇下边缘距离的标准差值大于第二阈值,则确定驾驶员在该预设历史时间段内说话。
[0130] 这里仍结合图4进行说明。
[0131] 嘴部特征点包括脸部特征点21(为上唇的上边缘中点)、脸部特征点23(上唇的下边缘中点)、脸部特征点24(为下唇的上边缘中点)和脸部特征点25(为下唇的下边缘中点)。
[0132] 利用图像采集装置在过去2秒内采集的驾驶员的头部图像进行分析,以确定驾驶员在前述2秒内是否说话。
[0133] 首先,按照每秒15帧的频率,在图像采集装置在过去2秒内采集到的驾驶员的头部图像中获取30帧图像。针对30帧图像进行分析,得到30个嘴部特征数据集,记为:
[0134]
[0135] 其中:该矩阵中的第i行是对第i帧图像进行分析得到的嘴部特征数据集。针对矩阵中的任意一行,第1列为嘴部特征点21的纵坐标,第2列为嘴部特征点23的纵坐标,第3列为嘴部特征点24的纵坐标,第4列为嘴部特征点25的纵坐标。
[0136] 之后,按照公式(2)确定驾驶员的双唇上边缘距离的标准差值,按照公式(3)确定驾驶员的双唇下边缘距离的标准差值。
[0137]
[0138]
[0139] 其中:
[0140] σ上为驾驶员的双唇上边缘距离的标准差值;
[0141] σ下为驾驶员的双唇下边缘距离的标准差值;
[0142] μ上为驾驶员的双唇上边缘距离的平均值,具体的,
[0143] μ下为驾驶员的双唇下边缘的平均值,具体的,
[0144] N为嘴部特征数据集的数量,这里具体为30。
[0145] 如果驾驶员的双唇上边缘距离的标准差值小于或等于第二阈值,且驾驶员额双唇下边缘距离的标准差值小于或等于第二阈值,则确定驾驶员在该预设历史时间段内未说话,否则,确定驾驶员在该预设历史时间段内说话。
[0146] 在本申请的另一个实施例中,基于N个嘴部特征数据集确定驾驶员在预设历史时间段内是否说话,采用如下方案:
[0147] E1:将N个嘴部特征数据集输入预先完成训练的第二判别模型,得到第二判别模型对N个嘴部特征数据集处理后输出的预测结果。
[0148] E2:根据预测结果确定驾驶员在预设历史时间段内是否说话。
[0149] 其中,第二判别模型是经过大量嘴部样本数据训练得到的,每个嘴部样本数据包括被测人员的N个嘴部特征数据集,N个嘴部特征数据集是根据被测人员在预设时间段内的头部图像生成的。另外,每个嘴部样本数据均具有标注信息,标注信息用于指示被测人员在预设时间段内是否说话。第二判别模型具备将预测结果趋于实际情况的能力。
[0150] 可选的,第二判别模型输出的预测结果为驾驶员在预设历史时间段内说话的概率值。相应的,如果该概率值大于预设的阈值,则确定驾驶员在预设历史时间段内说话,否则,确定驾驶员在预设历史时间段内未说话。
[0151] 在本申请的另一个实施例中,基于N个嘴部特征数据集确定驾驶员在预设历史时间段内是否说话,采用如下方案:
[0152] F1:将N个嘴部特征数据集输入预先完成训练的第二判别模型,得到第二判别模型对N个嘴部特征数据集处理后输出的预测结果。
[0153] F2:根据N个嘴部特征数据集确定驾驶员的双唇上边缘距离的标准差值、以及双唇下边缘距离的标准差值。
[0154] F3:如果驾驶员的双唇上边缘距离的标准差值和双唇下边缘距离的标准差值均小于或等于第二阈值,且预测结果指示驾驶员在预设历史时间段内未说话,则确定驾驶员在该预设历史时间段内未说话;如果驾驶员的双唇上边缘距离的标准差值大于第二阈值、驾驶员的双唇下边缘距离的标准差值大于第二阈值,或者预测结果指示驾驶员在预设历史时间段内说话,则确定驾驶员在该预设历史时间段内说话。
[0155] 在上述实施例中,将N个嘴部特征数据集输入预先完成训练的第二判别模型,基于第二判别模型输出的预测结果得到一个初级结果,根据N个嘴部特征数据集确定驾驶员的双唇上边缘距离的标准差值、以及双唇下边缘距离的标准差值,通过比较这两个标准差和第二阈值得到另一个初级结果,如果两个初级结果均指示驾驶员在预设历史时间段内未说话,则确定驾驶员在预设历史时间段内未说话,否则确定驾驶员在预设历史时间段内说话,能够更加准确地确定出驾驶员在预设历史时间段内是否说话。
[0156] 下面对本申请上述所使用的第二判别模型的训练过程进行说明,具体包括:
[0157] G1:获得多个嘴部样本数据。
[0158] 其中,每个嘴部样本数据包括被测人员的N个嘴部特征数据集,N个嘴部特征数据集是根据被测人员在预设时间段内的头部图像生成的。另外,每个嘴部样本数据均具有标注信息,标注信息用于指示被测人员在预设时间段内是否说话。
[0159] 优选的,多个嘴部样本数据包括正样本数据和负样本数据,以便第二判别模型更好地学习特征,从而提高预测准确度。其中,如果被测人员在预设时间段内说话,可以将生成的嘴部样本数据作为正样本,如果被测人员在预设时间段内未说话,可以将生的嘴部样本数据作为负样本。
[0160] G2:利用预先构建的学习模型对嘴部样本数据进行预测,获得预测结果。
[0161] G3:根据预测结果和标注信息调整学习模型,直至调整后的学习模型满足预设收敛条件,将满足预设收敛条件的学习模型确定为第二判别模型。
[0162] 预先构建的学习模型的初始模型参数均为自定义数值,训练学习模型的过程就是优化模型参数,以使得学习模型逐渐收敛,且预测结果的准确率逐渐提高的过程。当学习模型满足预设收敛条件时,将当前的学习模型确定为第二判别模型。
[0163] 在一种可能的实现方式中,预设收敛条件为:预设损失函数的值小于预设的阈值。其中,预设损失函数表征预测结果和标注信息之间的误差。预设的阈值为经验值。
[0164] 本申请上述公开了驾驶员状态监测方法,相应的,本申请还公开驾驶员状态监测装置,说明书中关于两者的描述可以相互参考。
[0165] 参见图7,图7为本申请公开的一种驾驶员状态检测装置的结构示意图。该装置包括头部图像获取模块701、头部图像分析模块702和数据处理模块703。
[0166] 头部图像获取模块701用于获得驾驶员在预设历史时间段内的头部图像。其中,驾驶员的头部图像由图像采集装置生成。
[0167] 状态分析模块702用于对驾驶员在预设历史时间段内的头部图像进行分析,确定驾驶员在预设历史时间段内的状态。
[0168] 数据处理模块703,用于如果驾驶员在预设历史时间段内为未移动且未说话状态,则将驾驶员在预设历史时间段内的心率和呼吸频率作为驾驶员的状态评价依据。其中,驾驶员的心率和呼吸频率由基于微波多普勒效应的检测设备生成。
[0169] 在本申请的一个实施例中,状态分析模块702包括:
[0170] 图像获取单元,用于从驾驶员在预设历史时间段内的头部图像中获取N帧图像,N为大于2的整数;
[0171] 数据集提取单元,用于对N帧图像进行分析,得到N个头部特征数据集和N个嘴部特征数据集,其中,每个头部特征数据集包括多种头部特征数据,头部特征数据为头部特征点的横坐标或者纵坐标,N个头部特征数据集中包含的头部特征数据的种类相同,每个嘴部特征数据集包括多种嘴部特征数据,嘴部特征数据为嘴部特征点的纵坐标,N个嘴部特征数据集中包含的嘴部特征数据的种类相同;
[0172] 第一状态分析单元,用于基于N个头部特征数据集确定驾驶员在预设历史时间段内是否移动;
[0173] 第二状态分析单元,用于基于N个嘴部特征数据集确定驾驶员在预设历史时间段内是否说话。
[0174] 在本申请的一个实施例中,第一状态分析单元包括:
[0175] 头部标准差确定子单元,用于确定N个头部特征数据集中每一种头部特征数据的标准差值;
[0176] 最大标准差值确定子单元,用于根据N个头部特征数据集中各种头部特征数据的标准差值确定N个头部特征数据集之间的最大标准差值;
[0177] 第一处理子单元,用于如果最大标准差值小于或等于第一阈值,则确定驾驶员在预设历史时间段内未移动,否则,确定驾驶员在预设历史时间段内发生移动。
[0178] 在本申请的一个实施例中,第一状态分析单元包括:
[0179] 第一预测子单元,用于将N个头部特征数据集输入预先完成训练的第一判别模型,得到第一判别模型对N个头部特征数据集处理后输出的预测结果;
[0180] 第二处理子单元,用于根据预测结果确定驾驶员在预设历史时间段内是否移动。
[0181] 在本申请的一个实施例中,第一状态分析单元包括:
[0182] 第一预测子单元,用于将N个头部特征数据集输入预先完成训练的第一判别模型,得到第一判别模型对N个头部特征数据集处理后输出的预测结果;
[0183] 头部标准差确定子单元,用于确定N个头部特征数据集中每一种头部特征数据的标准差值;
[0184] 最大标准差值确定子单元,用于根据N个头部特征数据集中各种头部特征数据的标准差值确定N个头部特征数据集之间的最大标准差值;
[0185] 第三处理子单元,用于如果最大标准差值小于或等于第一阈值,且预测结果指示驾驶员在预设历史时间段内未移动,则确定驾驶员在预设历史时间段内未移动,否则,确定驾驶员在预设历史时间段内发生移动。
[0186] 在本申请的一个实施例中,第二状态分析单元包括:
[0187] 嘴部标准差确定子单元,用于根据N个嘴部特征数据集确定驾驶员的双唇上边缘距离的标准差值、以及双唇下边缘距离的标准差值;
[0188] 第四处理子单元,用于如果驾驶员的双唇上边缘距离的标准差值和双唇下边缘距离的标准差值均小于或等于第二阈值,则确定驾驶员在预设历史时间段内未说话,否则,确定驾驶员在预设历史时间段内说话。
[0189] 在本申请的一个实施例中,第二状态分析单元包括:
[0190] 第二预测子单元,用于将N个嘴部特征数据集输入预先完成训练的第二判别模型,得到第二判别模型对N个嘴部特征数据集处理后输出的预测结果;
[0191] 第五处理子单元,用于根据预测结果确定驾驶员在预设历史时间段内是否说话。
[0192] 在本申请的一个实施例中,第二状态分析单元包括:
[0193] 第二预测子单元,用于将N个嘴部特征数据集输入预先完成训练的第二判别模型,得到第二判别模型对N个嘴部特征数据集处理后输出的预测结果;
[0194] 嘴部标准差确定子单元,用于根据N个嘴部特征数据集确定驾驶员的双唇上边缘距离的标准差值、以及双唇下边缘距离的标准差值;
[0195] 第六处理子单元,用于如果驾驶员的双唇上边缘距离的标准差值和双唇下边缘距离的标准差值均小于或等于第二阈值,且预测结果指示驾驶员在预设历史时间段内未说话,则确定驾驶员在预设历史时间段内未说话,否则,确定驾驶员在预设历史时间段内说话。
[0196] 本申请还公开一种驾驶员状态检测系统。该系统包括图像采集装置202、检测设备204和处理器203,如图2中所示。
[0197] 图像采集装置202,用于采集驾驶员的头部图像。
[0198] 检测装置204,用于基于微波多普勒效应测量所述驾驶员的心率和呼吸频率。
[0199] 处理器203,用于获得驾驶员在预设历史时间段内的头部图像,对驾驶员在预设历史时间段内的头部图像进行分析,确定驾驶员在预设历史时间段内的状态,如果驾驶员在预设历史时间段内为未移动且未说话状态,则将驾驶员在预设历史时间段内的心率和呼吸频率作为驾驶员的状态评价依据。
[0200] 其中,处理器203的具体实现可以参见前文中的描述,这里不再赘述。另外,图像采集装置202和检测装置204的安装位置可以采用图2所示的方案。
[0201] 最后,还需要说明的是,在本文中,诸如第一和第二等之类的关系术语仅仅用来将一个实体或者操作与另一个实体或操作区分开来,而不一定要求或者暗示这些实体或操作之间存在任何这种实际的关系或者顺序。而且,术语“包括”、“包含”或者其任何其他变体意在涵盖非排他性的包含,从而使得包括一系列要素的过程、方法、物品或者设备不仅包括那些要素,而且还包括没有明确列出的其他要素,或者是还包括为这种过程、方法、物品或者设备所固有的要素。在没有更多限制的情况下,由语句“包括一个……”限定的要素,并不排除在包括所述要素的过程、方法、物品或者设备中还存在另外的相同要素。
[0202] 本说明书中各个实施例采用递进的方式描述,每个实施例重点说明的都是与其他实施例的不同之处,各个实施例之间相同相似部分互相参见即可。对于实施例公开的装置及系统而言,由于其与实施例公开的方法相对应,所以描述的比较简单,相关之处参见方法部分说明即可。
[0203] 对所公开的实施例的上述说明,使本领域专业技术人员能够实现或使用本申请。对这些实施例的多种修改对本领域的专业技术人员来说将是显而易见的,本文中所定义的一般原理可以在不脱离本申请的精神或范围的情况下,在其它实施例中实现。因此,本申请将不会被限制于本文所示的这些实施例,而是要符合与本文所公开的原理和新颖特点相一致的最宽的范围。
专利地区:北京
专利申请日期:2021-09-07
专利公开日期:2022-12-20
专利公告号:CN113602280B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




