 产学研创新服务平台(全国)


一种旅店评论文本的属性描述提取方法发明专利
更新时间:2026-11-01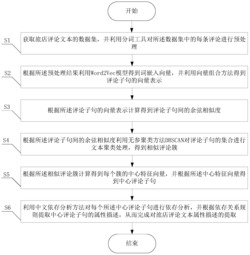 专利申请类型:发明专利;
地区:四川-乐山;
源自:乐山高价值专利检索信息库;
一种旅店评论文本的属性描述提取方法
摘要:本发明提供了一种旅店评论文本的属性描述提取方法,对评论文本进行预处理;利用向量组合方法得到评论子句的向量表示;计算评论子句间的余弦相似度;利用无参聚类方法对评论子句数据集进行文本聚类,得到相似评论簇;计算每个评论簇的中心特征向量,选取中心评论子句;对每个中心评论子句进行依存分析,并根据依存分析关系规则提取属性描述,得到属性评论短语集合。本发明利用无监督的机器学习和自然语言处理技术自动生成产品或服务的属性评论描述,联合属性词和评论词的提取,无需单独构造属性词候选集合和评论词候选集合,利用依存分析技术自动解决属性词和评论词的搭配问题,无需人工知识的引入,简单有效地自动实现属性评论描述的生成。
专利类型:发明专利
专利申请号:CN201910982544.5
专利申请(专利权)人:乐山师范学院
权利人地址:四川省乐山市市中区滨河路778号
专利发明(设计)人:孙锐,曾宇,金澎,谢红
主权利要求:一种旅店评论文本的属性描述提取方法
技术领域
[0001] 本发明属于信息处理技术领域,尤其涉及一种旅店评论文本的属性描述提取方法。
背景技术
[0002] 随着电子商务的流行,更多的消费者习惯在商务网站或论坛上留下对产品或服务的观点态度。多数消费者在购买产品前大多会了解别人对产品或服务的意见,从而做出消费决策。人工浏览这些海量评论文本是非常耗时的,因此,在非结构化的产品评论中提取或标注出相关的属性词和评论词显得尤为重要。消费者可以通过直接浏览属性评论短语(由属性词和评论词构成)即可获得其他消费者对相关产品或服务的总体评论,从而节省大量的浏览时间。
[0003] 现有技术中商家或平台根据产品或服务的特点定制属性评论短语,将这些短语看成已有的分类标签,采用分类模型为每条评论文本分配标签,但其却存在如下问题:方案要求领域专家事先定制产品或服务属性词以及评论词;因有人工知识的引入,故分类标签的设计带有一定的主观性;该技术为分类模型,在为每条评论文本分配标签时须采用有监督的学习方式,其要求之一就是须有已标注的评论文本作为训练语料。现有技术中还采用无监督的方法依次进行属性词提取、评论词提取和搭配关系识别。在属性词的提取上,大多利用词频技术提取名词或名词短语作为候选;在评论词提取部分,利用情感词典匹配的方式来得到评论词候选;在搭配关系识别上,则利用属性词和评论词的距离或互信息来构造属性评论短语。其存在如下问题:采用流水线的方式进行属性词提取和评论词提取,丢失了候选属性词和候选评论词的语义信息;搭配关系识别的性能一定程度上影响属性评论描述的语法正确性和流畅性。
发明内容
[0004] 针对现有技术中的上述不足,本发明提供的一种旅店评论文本的属性描述提取方法,实现了采用无监督的机器学习方法自动发现不同的属性评论簇,并为每个簇提取对应的属性评论描述。
[0005] 为了达到以上目的,本发明采用的技术方案为:
[0006] 本方案提供一种旅店评论文本的属性描述提取方法,包括如下步骤:
[0007] S1、获取旅店评论文本的数据集,并利用分词工具对所述数据集中的每条评论进行预处理;
[0008] S2、根据所述预处理结果利用Word2Vec模型得到词嵌入向量,并利用向量组合方法得到评论子句的向量表示;
[0009] S3、根据所述评论子句的向量表示计算得到评论子句间的余弦相似度;
[0010] S4、根据所述评论子句间的余弦相似度利用无参聚类方法DBSCAN对评论子句的集合进行文本聚类处理,得到相似评论簇;
[0011] S5、根据所述相似评论簇计算得到每个簇的中心特征向量,并根据所述中心特征向量得到中心评论子句;
[0012] S6、利用中文依存分析方法对每个所述中心评论子句进行依存分析,并根据依存关系规则提取中心评论子句的属性描述,从而完成对旅店评论文本属性描述的提取。
[0013] 进一步地,所述步骤S1包括如下步骤:
[0014] S101、获取旅店评论文本的数据集,并去除旅店评论文本数据集中每条评论的空格、HTML和特殊字符;
[0015] S102、将每条评论的长句切分成评论子句得到评论子句集合;
[0016] S103、根据所述评论子句集合,利用中文分词工具对每条评论子句进行分词处理,从而完成对每条评论的预处理。
[0017] 再进一步地,所述步骤S2中评论子句的向量表示s的表达式如下:
[0018]
[0019] 其中,si表示向量s的第i维度值,wji表示评论子句第j个词的第i维度值,k表示评论子句的文本长度,n表示向量s的维度。
[0020] 再进一步地,所述步骤S4包括如下步骤:
[0021] S401、根据所述评论子句间的余弦相似度构建评论子句数据集的相似度矩阵;
[0022] S402、根据所述相似度矩阵利用无参聚类方法DBSCAN对评论子句的集合进行文本聚类处理,得到相似评论簇。
[0023] 再进一步地,所述步骤S5包括如下步骤:
[0024] S501、根据每个所述相似评论簇中所有评论子句的每一维特征向量的平均值计算得到每个簇的中心特征向量;
[0025] S502、根据以下公式计算得到每个相似评论簇中每条评论子句sj与所述每个簇的中心特征向量c的余弦相似度sim(sj,c):
[0026]
[0027] 其中,sji表示评论子句sj的第i维度值,ci表示中心特征向量c的第i维度值,n表示向量维度;
[0028] S503、选取所述余弦相似度中最大的评论子句作为该评论簇的中心评论子句,从而确定每个簇的中心对应的中心评论子句。
[0029] 再进一步地,所述步骤S501中中心特征向量c的表达式如下:
[0030]
[0031] 其中,ci表示中心特征向量c的第i维度值,|C|表示对应簇C包含的评论子句数量,sji表示簇中评论子句sj第i维度值,n表示向量维度。
[0032] 再进一步地,所述步骤S6包括如下步骤:
[0033] S601、利用中文依存分析方法对每个所述中心评论子句进行依存分析,得到每个中心评论子句的依存图;
[0034] S602、根据所述每个中心评论子句的依存图利用依存关系规则提取中心评论子句的属性描述,从而完成对旅店评论文本的属性描述的提取。
[0035] 本发明的有益效果:
[0036] 本发明提供了一种旅店评论文本的属性描述提取方法,获取评论数据集,对评论文本进行预处理;利用向量组合方法得到评论子句的向量表示;计算评论子句间的余弦相似度;利用无参聚类方法对评论子句数据集进行文本聚类,得到相似评论簇;计算每个评论簇的中心特征向量,选取中心评论子句;对每个中心评论子句进行依存分析,并根据依存分析关系规则提取属于描述,得到属性评论短语集合。本发明采用无监督的机器学习和自然语言处理技术自动生成产品或服务的属性评论描述,联合属性词和评论词的提取,无需单独构造属性词候选集合和评论词候选集合,利用语义依存分析技术自动解决属性词和评论词的搭配问题,无需人工知识的引入,简单有效地自动实现属性评论描述的生成,且属性评论描述的数量可以通过聚簇数目来调节,属性评论数量直接由簇内评论数目来确定,实现了利用无监督的机器学习方法自动发现不同的属性评论簇,并为每个簇提取对应的属性评论描述,有效地提高了提取旅店评论文本属性描述的精度。
附图说明
[0037] 图1为本发明的方法流程图。
具体实施方式
[0038] 下面对本发明的具体实施方式进行描述,以便于本技术领域的技术人员理解本发明,但应该清楚,本发明不限于具体实施方式的范围,对本技术领域的普通技术人员来讲,只要各种变化在所附的权利要求限定和确定的本发明的精神和范围内,这些变化是显而易见的,一切利用本发明构思的发明创造均在保护之列。
[0039] 实施例
[0040] 海量的评论文本中存在着一部分形态不同,但语义相同或相似的评论。这些评论同时关注着产品或服务的某一个方面或属性,同时也有着相似的情感倾向,如“房间很宽敞”和“房间挺大”。对消费者而言,无需过多地关注每条评论文本中的属性评论描述,而更聚焦于现有所有评论文本对相关产品或服务的各个属性或方面的总体评论(属性评论描述和占比情况)。因此,我们提供了一种针对评论文本的属性描述提取方法,采用无监督的机器学习方法自动发现不同的属性评论簇,并为每个簇提取对应的属性评论描述。该技术有如下特点:
[0041] (1)评论文本的自动聚类:以主流的分布式语义表示对评论子句建模,采用无参文本聚类技术实现评论子句的自动聚簇;
[0042] (2)提取评论簇的代表描述:计算评论簇的聚类中心以提取代表性评论描述;
[0043] (3)利用语义分析技术提取属性评论描述:利用语义依存工具对代表性评论描述进行语义分析,提取属性评论描述。
[0044] 该技术的优势主要体现在:联合实现属性词提取和评论词提取,利用语义依存关系有效地解决属性词和评论词的语义搭配问题。在旅店评论文本上的实施例表明该技术简单有效,具备一定的可调节性。无监督的学习方式使得技术实施无需过多的人工干预。如图1所示,包括如下步骤:
[0045] S1、获取旅店评论文本的数据集,并利用分词工具对所述数据集中的每条评论进行预处理,其实现方法如下:
[0046] S101、获取旅店评论文本的数据集,并去除旅店评论文本数据集中每条评论的空格、HTML和特殊字符;
[0047] S102、将每条评论的长句切分成评论子句得到评论子句集合;
[0048] S103、根据所述评论子句集合,利用中文分词工具对每条评论子句进行分词处理,从而完成对每条评论的预处理;
[0049] S2、根据所述预处理结果利用Word2Vec模型得到词嵌入向量,并利用向量组合方法得到评论子句的向量表示。
[0050] 本实施例中,利用Word2Vec习得词嵌入向量表示,训练语料以旅店评论文本为主,每个词条w的表示为n维,如“酒店”:[‑0.02146593,‑0.01235346,……,0.09233567];采用向量组合计算的方式,表示每条评论子句。给定评论子句s,其词序列为{w1,w2,…,wk},则该子句的表示向量可按下式计算:
[0051]
[0052] 其中,si表示向量s的第i维度值,wji表示评论子句第j个词的第i维度值,k表示评论子句的文本长度,n表示向量s的维度。如有评论子句“酒店/位置/地铁/门口”,其向量表示即是四个词向量在各个维度下的均值。
[0053] S3、根据所述评论子句的向量表示计算得到评论子句间的余弦相似度,余弦相似度sim(sj,c),
[0054]
[0055] 其中,sji表示评论子句sj的第i维度值,ci表示中心特征向量c的第i维度值,n表示向量维度;
[0056] S4、根据所述评论子句间的余弦相似度利用无参聚类方法DBSCAN对评论子句的集合进行文本聚类处理,得到相似评论簇,其实现方法如下:
[0057] S401、根据所述评论子句间的余弦相似度构建评论子句数据集的相似度矩阵;
[0058] S402、根据所述相似度矩阵利用无参聚类方法DBSCAN对评论子句的集合进行文本聚类处理,得到相似评论簇;
[0059] S5、根据所述相似评论簇计算得到每个簇的中心特征向量,并根据所述中心特征向量得到中心评论子句,其实现方法如下:
[0060] S501、根据每个所述相似评论簇中所有评论子句的每一维特征向量的平均值计算得到每个簇的中心特征向量,所述中心特征向量c的表达式如下:
[0061]
[0062] 其中,ci表示中心特征向量c的第i维度值,|C|表示对应簇C包含的评论子句数量,sji表示簇中评论子句sj第i维度值,n表示向量维度;
[0063] S502、根据以下公式计算得到每个相似评论簇中每条评论子句sj与所述每个簇的中心特征向量c的余弦相似度sim(sj,c):
[0064]
[0065] 其中,sji表示评论子句sj的第i维度值,ci表示中心特征向量c的第i维度值,n表示向量维度;
[0066] S503、选取所述余弦相似度中最大的评论子句作为该评论簇的中心评论子句,从而确定每个簇的中心对应的中心评论子句;
[0067] S6、利用中文依存分析方法对每个所述中心评论子句进行依存分析,并根据依存关系规则提取中心评论子句的属性描述,从而完成对旅店评论文本属性描述的提取,其实现方法如下:
[0068] S601、利用中文依存分析方法对每个所述中心评论子句进行依存分析,得到每个中心评论子句的依存图,如“酒店/早餐/较/丰富/多样”,依存分析后结果为:NN(酒店,早餐),NSUBJ(丰富,早餐),ADVMOD(较,丰富),VC(丰富,多样);
[0069] S602、根据所述每个中心评论子句的依存图利用依存关系规则提取中心评论子句的属性描述,从而完成对旅店评论文本的属性描述的提取,如依存关系“NSUBJ”多表示“主谓关系”,故可提取NSUBJ关系对“早餐丰富”作为属性评论描述,其中“早餐”为属性词,“丰富”为评论词。
[0070] 本发明通过以上设计,采用无监督的机器学习和自然语言处理技术自动生成产品或服务的属性评论描述,联合属性词和评论词的提取,无需单独构造属性词候选和评论词候选,利用语义依存分析技术自动解决属性词和评论词的搭配问题,无需人工知识的引入,简单有效地自动实现属性评论描述的生成,且属性评论描述的数量可以通过聚簇数目来调节,属性评论数量直接由簇内评论数目来确定,实现了利用无监督的机器学习方法自动发现不同的属性评论簇,并为每个簇提取对应的属性评论描述,有效地提高了提取旅店评论文本属性描述的精度。
专利地区:四川
专利申请日期:2019-10-16
专利公开日期:2022-12-06
专利公告号:CN110750646B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




