 产学研创新服务平台(全国)


降噪方法、终端设备及计算机可读存储介质发明专利
更新时间:2026-11-01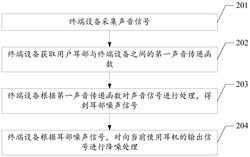 专利申请类型:发明专利;
地区:广东-东莞;
源自:东莞高价值专利检索信息库;
降噪方法、终端设备及计算机可读存储介质
摘要:本发明实施例公开了一种降噪方法、终端设备及计算机可读存储介质,用于将降噪处理过程放到终端设备上来进行,用户不需要额外的花费,就可以体验到一定程度的降噪效果。本发明实施例方法包括:终端设备采集声音信号;所述终端设备获取用户耳部与所述终端设备之间的第一声音传递函数;所述终端设备根据所述第一声音传递函数对所述声音信号进行处理,得到耳部噪声信号;所述终端设备根据所述耳部噪声信号,对向当前使用耳机的输出信号进行降噪处理。
专利类型:发明专利
专利申请号:CN202010981457.0
专利申请(专利权)人:OPPO广东移动通信有限公司
权利人地址:广东省东莞市长安镇乌沙海滨路18号
专利发明(设计)人:王文东
主权利要求:降噪方法、终端设备及计算机可读存储介质
技术领域
[0001] 本发明涉及音频领域,尤其涉及一种降噪方法、终端设备及计算机可读存储介质。
背景技术
[0002] 在使用耳机欣赏音乐或电影时,如何提升嘈杂环境下的听觉体验一直是用户很关心的一个问题。目前,主动降噪(ActiveNoiseCancellation,ANC)功能已经在耳机上得到了很广泛的应用。要实现主动降噪,需要在耳机上设置麦克风和处理电路,通常在耳机外壳上安装麦克风采集环境噪声,有一些主动降噪耳机还会在耳机内部贴近喇叭的地方安装另外一个麦克风来采集耳机和人耳之间的声音。通过算法处理麦克风所采集到的信号,来估计到达耳内的环境噪声,然后通过往耳机输出信号上叠加所估计耳内环境噪声的反相信号来达到降噪效果。
[0003] 但是,耳机上的处理器性能有限,无法采用复杂度较高的算法,很多复杂情况下的降噪效果并不理想。耳机上的麦克风做声源定位的误差较大,因此对移动噪声源的降噪效果也不理想。而且降噪耳机相对来说成本高昂,售价较高。
发明内容
[0004] 本发明实施例提供了一种降噪方法、终端设备及计算机可读存储介质,用于在终端设备上进行耳机的降噪处理。
[0005] 有鉴于此,本发明第一方面提供一种降噪方法,可以包括:
[0006] 终端设备采集声音信号;
[0007] 所述终端设备获取用户耳部与所述终端设备之间的第一声音传递函数;
[0008] 所述终端设备根据所述第一声音传递函数对所述声音信号进行处理,得到耳部噪声信号;
[0009] 所述终端设备根据所述耳部噪声信号,对向当前使用耳机的输出信号进行降噪处理。
[0010] 本发明第二方面提供一种终端设备,可以包括:
[0011] 采集模块,用于采集声音信号;
[0012] 处理模块,用于获取用户耳部与所述终端设备之间的第一声音传递函数;根据所述第一声音传递函数对所述声音信号进行处理,得到耳部噪声信号;根据所述耳部噪声信号,对向当前使用耳机的输出信号进行降噪处理。
[0013] 本发明第三方面提供一种终端设备,可以包括:
[0014] 存储有可执行程序代码的存储器;
[0015] 与所述存储器耦合的处理器;
[0016] 所述处理器调用所述存储器中存储的所述可执行程序代码,用于执行如本发明实施例第一方面所述的方法。
[0017] 本发明实施例第四方面提供一种计算机可读存储介质,其上存储有计算机程序,所述计算机程序被处理器执行时实现如本发明实施例第一方面所述的方法。
[0018] 本发明实施例第五方面公开一种计算机程序产品,当所述计算机程序产品在计算机上运行时,使得所述计算机执行本发明实施例第一方面所述的方法。
[0019] 本发明实施例第六方面公开一种应用发布平台,所述应用发布平台用于发布计算机程序产品,其中,当所述计算机程序产品在计算机上运行时,使得所述计算机执行本发明实施例第一方面所述的方法。
[0020] 从以上技术方案可以看出,本发明实施例具有以下优点:
[0021] 在本发明实施例中,终端设备采集声音信号;所述终端设备获取用户耳部与所述终端设备之间的第一声音传递函数;所述终端设备根据所述第一声音传递函数对所述声音信号进行处理,得到耳部噪声信号;所述终端设备根据所述耳部噪声信号,对向当前使用耳机的输出信号进行降噪处理。将降噪处理过程放到终端设备上来进行,用户不需要额外的花费,就可以体验到一定程度的降噪效果。即将终端设备上收到的声音信号通过第一声音传递函数后得到耳部噪声信号的估计,再通过往耳机输出信号上叠加耳部噪声信号的反相信号来达到降噪效果。而且,终端设备的处理性能优于耳机,降噪效果更佳。
附图说明
[0022] 为了更清楚地说明本发明实施例技术方案,下面将对实施例和现有技术描述中所需要使用的附图作简单地介绍,显而易见地,下面描述中的附图仅仅是本发明的一些实施例,还可以根据这些附图获得其它的附图。
[0023] 图1A为本发明实施例中终端设备的一个实施例示意图;
[0024] 图1B为本发明实施例中终端设备的另一个实施例示意图;
[0025] 图2为本发明实施例中降噪方法的一个实施例示意图;
[0026] 图3为本发明实施例中降噪方法的另一个实施例示意图;
[0027] 图4A为本发明实施例中终端设备进行注册的一个流程示意图;
[0028] 图4B为本发明实施例中人脸3D模型的一个示意图;
[0029] 图4C为本发明实施例中人脸3D模型的另一个示意图;
[0030] 图4D为本发明实施例中终端设备获取耳机型号的一个示意图;
[0031] 图4E为本发明实施例中终端设备获取耳机型号的另一个示意图;
[0032] 图4F为本发明实施例中终端设备获取耳机型号的另一个示意图;
[0033] 图4G为本发明实施例中终端设备处于第二播放模式的一个示意图;
[0034] 图5为本发明实施例中降噪方法的另一个实施例示意图;
[0035] 图6A为本发明实施例中终端设备的另一个实施例示意图;
[0036] 图6B为本发明实施例中终端设备的另一个实施例示意图。
具体实施方式
[0037] 本发明实施例提供了一种降噪方法、终端设备及计算机可读存储介质,用于在终端设备上进行耳机的降噪处理。
[0038] 为了使本技术领域的人员更好地理解本发明方案,下面将结合本发明实施例中的附图,对本发明实施例中的技术方案进行描述,显然,所描述的实施例仅仅是本发明一部分的实施例,而不是全部的实施例。基于本发明中的实施例,都应当属于本发明保护的范围。
[0039] 可以理解的是,本发明实施例中所涉及的终端设备可以包括一般的手持电子终端,具有连接有线耳机的功能。诸如手机、智能电话、便携式终端、终端、个人数字助理(PersonalDigitalAssistant,PDA)、便携式多媒体播放器(PersonalMediaPlayer,PMP)装置、笔记本电脑、笔记本(NotePad)、无线宽带(WirelessBroadband,Wibro)终端、平板电脑(personalcomputer,PC)、智能PC、POS(PointofSales,销售终端)和车载电脑等。
[0040] 终端设备也可以包括可穿戴设备。可穿戴设备即可以直接穿戴在用户身上,或是整合到用户的衣服或配件的一种便携式电子设备。可穿戴设备不仅仅是一种硬件设备,更可以通过软件支持以及数据交互、云端交互来实现强大的智能功能,比如:计算功能、定位功能、报警功能,同时还可以连接手机及各类终端。可穿戴设备可以包括但不限于以手腕为支撑的watch类(比如手表、手腕等产品),以脚为支撑的shoes类(比如鞋、袜子或者其他腿上佩戴产品),以头部为支撑的Glass类(比如眼镜、头盔、头带等)以及智能服装,书包、拐杖、配饰等各类非主流产品形态。
[0041] 如图1A所示,为本发明实施例中终端设备的一个实施例示意图。可以包括多于或少于以下示出的功能模块:
[0042] 人脸识别、人脸3D建模、脸部和双耳特征、耳机型号识别、耳机型号选择、耳机隔音特性、距离估计、声源定位、双耳滤波和下混、惯性测量单元、碰撞检测、耳机特性滤波、混音。
[0043] 可选的,图1A所示的距离估计模块也可以通过超声测距模块实现,如图1B所示,为本发明实施例中终端设备的另一个实施例示意图。需要说明的是,关于图1A和图1B中所示的各个功能模块的作用,将结合下述方法实施例进行说明。
[0044] 下面以实施例的方式,结合上述图1A或图1B所示的终端设备,对本发明技术方案做进一步的说明。如图2所示,为本发明实施例中降噪方法的一个实施例示意图,可以包括:
[0045] 201、终端设备采集声音信号。
[0046] 可选的,终端设备通过麦克风采集声音信号。
[0047] 可选的,终端设备通过麦克风阵列(即多个麦克风)采集多个声音信号。其中,该声音信号可以理解为环境噪声信号。
[0048] 202、终端设备获取用户耳部与终端设备之间的第一声音传递函数。
[0049] 可选的,终端设备获取用户耳部与终端设备之间的第一声音传递函数,可以包括但不限于以下的实现方式:
[0050] 方式1:终端设备在检测到当前处于第一播放模式的情况下,获取用户面部中的特征点相对于终端设备的第一坐标,第一播放模式为用户面部面向终端设备的播放模式;终端设备根据声音信号,得到噪声源位置;终端设备根据第一坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0051] 方式2:终端设备在检测到当前处于第二播放模式的情况下,接收用户输入的用户使用姿态和终端设备放置的位置,第二播放模式为用户面部不面向终端设备的播放模式;终端设备根据用户使用姿态和终端设备放置的位置,确定用户面部中的特征点相对于终端设备的第一坐标;终端设备根据声音信号,得到噪声源位置;终端设备根据第一坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0052] 需要说明的是,在方式1和方式2中,这里用户面部中的特征点相对于终端设备的第一坐标,可以理解为用户面部中的特征点相对于终端设备中心点的第一坐标,或者理解为用户面部中的特征点相对于终端设备中每个麦克风的第一坐标,具体此处不做限定。用户耳部与终端设备之间的第一声音传递函数,可以是用户单耳与终端设备之间的第一声音传递函数,也可以是用户双耳与终端设备之间的第一声音传递函数。
[0053] 可选的,在方式1和方式2中,还可以包括:终端设备通过惯性测量单元,得到终端设备的当前倾角;其中,终端设备根据第一坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数,可以包括:终端设备根据第一坐标,以及噪声源位置和终端设备的当前倾角,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0054] 示例性的,惯性测量单元(InertialMeasurementUnit,IMU)可以包括但不限于:重力传感器、加速度传感器和陀螺仪。终端设备可以持续采集惯性测量单元的读数,得到自身的当前倾角。可以理解的是,终端设备的当前倾角是一个估计值。
[0055] 203、终端设备根据第一声音传递函数对声音信号进行处理,得到耳部噪声信号。
[0056] 可选的,还可以包括:终端设备获取当前使用耳机外壳到用户耳内之间的第二声音传递函数;终端设备根据第一声音传递函数对声音信号进行处理,得到耳部噪声信号,可以包括:终端设备根据第一声音传递函数和第二声音传递函数对声音信号进行处理,得到耳部噪声信号。
[0057] 204、终端设备根据耳部噪声信号,对向当前使用耳机的输出信号进行降噪处理。
[0058] 终端设备根据耳部噪声信号,对向当前使用耳机的输出信号进行降噪处理,可以包括:终端设备对耳部噪声信号进行反相处理,得到反相处理的耳部噪声信号;终端设备将反相处理的耳部噪声信号叠加在向当前使用耳机的输出信号上。可以理解的是,耳部噪声信号可以是单耳噪声信号,也可以是双耳噪声信号。
[0059] 可选的,终端设备根据第一声音传递函数和第二声音传递函数对声音信号进行处理,得到耳部噪声信号,可以包括:终端设备根据第一声音传递函数对声音信号进行第一滤波和下混处理,得到耳外噪声信号;终端设备根据第二声音传递函数对耳外噪声信号进行第二滤波处理,得到耳内噪声信号;终端设备根据耳部噪声信号,对向当前使用耳机的输出信号进行降噪处理,可以包括:终端设备根据耳内噪声信号,对向当前使用耳机的输出信号进行降噪处理。
[0060] 可以理解的是,如果是单耳的话,每个声音信号对应有一个第一声音传递函数,如果是双耳的话,每个声音信号会对应就会有两个第一声音传递函数;这里以单耳为例进行说明,根据第一声音传递函数,对多个声音信号进行滤波处理,得到多个滤波的声音信号,再对多个滤波的声音信号进行下混处理,得到耳外噪声信号。
[0061] 可选的,第一声音传递函数也可以理解为第一映射关系,所述第一映射关系表征所述用户耳部与所述终端设备之间的声音传递特征;第二声音传递函数也可以理解为第二映射关系,所述第一映射关系表征所述用户当前使用耳机外壳与用户耳内之间的声音传递特征。
[0062] 在本发明实施例中,将降噪处理过程放到终端设备上来进行,即在终端设备上可以对耳机进行降噪处理。将终端设备上收到的声音信号通过第一声音传递函数后得到耳部噪声信号的估计,再通过往耳机输出信号上叠加耳部噪声信号的反相信号来达到降噪效果。用户不需要额外的花费,就可以体验到一定程度的降噪效果。而且终端设备的处理性能优于耳机,降噪效果更佳。
[0063] 下面针对终端设备处于第一播放模式和第二播放模式分别进行说明,如图3所示,为本发明实施例中降噪方法的另一个实施例示意图,可以包括:
[0064] 301、终端设备采集声音信号。
[0065] 可以理解的是,在终端设备执行步骤301之前,还可以进行注册流程,如图4A所示,为本发明实施例中终端设备进行注册的一个流程示意图,可以包括:401、终端设备采集用户的正面图像;402、终端设备根据用户的正面图像,调用人脸识别库,得到用户的身份标识;403、终端设备采集用户的头部转动图像;404、终端设备根据用户的头部转动图像,进行用户的人脸3D模型的建模。可选的,终端设备可以建立多个用户的人脸3D模型。如图4B所示,为本发明实施例中人脸3D模型的一个示意图。如图4C所示,为本发明实施例中人脸3D模型的另一个示意图。
[0066] 可选的,405、终端设备输出第一提示信息;终端设备响应用户对该第一提示信息的操作,获取用户使用的耳机型号列表。可选的,终端设备可以获取多个用户使用的耳机型号列表。
[0067] 可选的,406、终端设备将用户的身份标识、人脸3D模型和用户使用的耳机型号列表进行存储。
[0068] 可选的,该第一提示信息可以提示用户输入自己当前使用的各个耳机的型号,如图4D所示,为本发明实施例中终端设备获取耳机型号的一个示意图。也可以提示用户从预设的耳机型号列表中选择自己当前使用的各个耳机的型号,如图4E所示,为本发明实施例中终端设备获取耳机型号的另一个示意图。也可以提示用户通过图像分析的方法,确定自己当前使用耳机的型号,如图4F所示,为本发明实施例中终端设备获取耳机型号的另一个示意图。
[0069] 可以理解的是,通过图像分析的方法,该第一提示信息可以是“是否开启摄像头,进行拍照识别手机型号?”,如果用户选择“是”,那么,终端设备响应用户的选择“是”的操作,开启拍照或者摄像模式,再响应用户进行拍照或摄像的操作,得到关于用户使用耳机的图片或录像,终端设备经过图像分析的处理,得到用户使用耳机的型号。
[0070] 示例性的,在图4A所示的注册流程中,首先,终端设备可以采集用户的正面图像,并进行人脸识别得到用户的身份标识。随后,用户可以将头转向一侧,然后缓慢转动180度至另一侧,终端设备可以实时采集用户图像、检测特征点,并进行人脸3D模型的建模。然后,终端设备可以提醒用户从预设的耳机型号列表中选择自己所使用的所有耳机的型号。如果用户使用的耳机型号不在预设的耳机型号列表中,则终端设备可以采集耳机图像,并从在线的耳机图像数据库中选择与耳机图像的耳机外观最接近的耳机型号,或者,终端设备提醒用户手动输入耳机型号。最后,终端设备可以将建立的人脸3D模型和用户使用的耳机型号列表以及用户的身份标识一起被保存在终端设备的存储区内。
[0071] 可选的,终端设备通过麦克风阵列采集声音信号。即终端设备通过多个麦克风采集多个声音信号。可选的,终端设备检测到当前用户使用耳机连接终端设备时,采集声音信号。
[0072] 可选的,终端设备检测到当前用户使用耳机连接终端设备时,还可以采集当前用户的正面人脸图像,并调用系统的人脸识别模块得到当前用户的当前身份标识;终端设备根据当前身份标识从存储区中读取当前用户的人脸3D模型。
[0073] 可以理解的是,终端设备中的人脸识别模块:用于识别用户的身份标识并读取对应的人脸3D模型和耳机的型号。
[0074] 终端设备中的人脸3D建模模块:主要功能是在用户正面180度的连续图像采集过程中进行特征点检测和深度信息的估计,并建立人脸3D模型。在人脸3D建模的过程中,本发明实施例主要关心用户耳部相对于用户面部其他特征点(例如:鼻尖、眼角、嘴角等)的坐标,因此,在保存的人脸3D模型中,也可以只保留这些特征点而忽略其他特征点以减小模型尺寸,节省存储空间。
[0075] 在本发明实施例中,能够利用终端设备上的摄像头对每个用户面部中的特征点和耳部特征进行建模,并且在用户手持终端设备使用时实时检测用户面部相对于终端设备的第一坐标,使降噪效果与用户的特征和行为高度适配。
[0076] 302、终端设备在检测到当前处于第一播放模式的情况下,获取用户面部中的特征点相对于终端设备的第一坐标,第一播放模式为用户面部面向终端设备的播放模式。
[0077] 示例性的,第一播放模式可以是用户面向终端设备的屏幕,使用终端设备播放视频、打游戏,或,听歌的同时在刷网页,或,听广播的同时在刷网页等场景。可选的,在第一播放模式下,用户可以手持该终端设备。
[0078] 可选的,终端设备获取用户面部中的特征点相对于终端设备的第一坐标,可以包括:终端设备通过摄像头采集用户面部图像进行视觉分析,或,通过超声测距方法,获取用户面部中的特征点相对于终端设备的第一坐标。
[0079] 可选的,用户面部中的特征点相对于终端设备的第一坐标,可以通过用户面部中的特征点相对于终端设备的第一距离确定。
[0080] 可以理解的是,终端设备中的距离估计模块:用于在用户使用耳机的时候实时估计用户面部中特征点(例如鼻尖、眼角、嘴角等)距离终端设备的第一距离。示例性的,在只有简单摄像头时,可以通过相机的焦距信息,结合人脸检测来大致获取用户面部中特征点与终端设备的第一距离。可选的,现在的终端设备有很大一部分配置有结构光摄像头、双目摄像头或飞行时间法(Timeofflight,ToF)摄像头等,可以很方便地进行景深的测量,并得到更准确的第一距离。
[0081] 可以理解的是,终端设备中的距离估计模块,可以替换为超声测距模块。即在用户使用耳机时,利用摄像头和视觉分析来进行距离估计的部分,也可被替换为超声测距方法。和视觉分析方法相比,超声测距的算力需求更低、功耗更低,对各种光照环境的适应性更强,并且对用户的隐私保护更加友好。
[0082] 可选的,终端设备根据第一坐标,以及噪声源位置,计算得到用户面部与终端设备之间的第一声音传递函数,可以包括:根据第一坐标,以及预设的用户耳部与用户面部中的特征点的第二坐标,得到用户耳部相对于终端设备的第三坐标;根据第三坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。可以理解的是,这里的用户耳部与用户面部中的特征点的第二坐标,是根据经验值得到的,例如:通过大量成年人的用户耳部相对于用户面部中的特征点的坐标,混合处理得到的经验值。
[0083] 可选的,第二坐标可以通过预设的用户耳部与用户面部中的特征点的第二距离得到;第三坐标可以通过用户耳部相对于终端设备的第三距离得到。
[0084] 可选的,还可以包括:终端设备根据用户面部图像和用户预设的人脸3D模型,得到用户耳部相对于用户面部中的特征点的第四坐标;终端设备根据第一坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数,可以包括:根据第一坐标和第四坐标,得到用户耳部相对于终端设备的第五坐标;终端设备根据第五坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。可以理解的是,这里的用户面部图像可以是用户的正面人脸图像。
[0085] 可选的,第四坐标可以通过用户耳部与用户面部中的特征点的第四距离得到;第五坐标可以通过用户耳部相对于终端设备的第五距离得到。
[0086] 可以理解的是,终端设备中的人脸3D模型模块:还用于估计用户耳部与用户面部中的特征点的第二距离。
[0087] 终端设备中的人脸3D模型模块和距离估计模块相结合,根据用户面部中特征点与终端设备的第一距离,以及用户耳部与用户面部中特征点的第二距离,得到用户耳部与终端设备的第三距离。
[0088] 可选的,在精度要求不高的场景下,3D人脸建模模块也可以被替换为简单的视觉分析模块。例如,首先对所采集的用户正面图像进行视觉分析,估计用户面部中的特征点相对于终端设备的第一坐标,以及用户耳部相对于用户面部中的其他特征点(例如眼角、鼻尖和嘴角等)的第四坐标的估计。随后,采集用户面部两个侧面的图像并进行视觉分析,再得到用户面部中的特征点相对于终端设备的第一坐标,以及用户耳部相对于用户面部中的其他特征点(例如眼角、鼻尖和嘴角等)的第四坐标的估计。利用这些坐标的估计,可以得到距离的估计,在用户使用耳机时就可以进行第一声音传递函数的估计。可选的,视觉分析模块也可以是对其他面部特征点之间距离的估计和组合。
[0089] 303、终端设备根据声音信号,得到噪声源位置。
[0090] 可选的,终端设备采集声音信号,可以包括:终端设备根据多个麦克风采集的多个声音信号,终端设备根据声音信号,得到噪声源位置,可以包括:终端设备对多个声音信号使用相位加权的互相关方法,计算得到到达时间差;终端设备根据到达时间差,得到噪声源位置。
[0091] 可选的,噪声源位置可以包括:噪声源的到达角(DirectionofArrival,DOA),或者,噪声源的到达角和噪声源的距离。
[0092] 可以理解的是,终端设备中的声源定位模块:利用终端设备上的麦克风阵列所采集的多通道声音信号,即多个噪声信号,对噪声源进行定位。根据麦克风的个数和实际的降噪需求,可以只进行噪声源的到达角(DOA,DirectionofArrival)估计,也可以进一步进行噪声源的距离估计。在进行噪声源定位时,可以首先使用相位加权(PhaseTransform,PHAT)的广义互相关(GeneralizedCrossCorrelation,GCC)方法来进行到达时间差(TimeDelayofArrival,TDOA)估计,然后结合麦克风阵列的阵型信息来得到噪声源的到达角DOA和噪声源的距离。需要说明的是,噪声源的DOA是相对于终端设备平面的方向,需要结合终端设备中IMU的读数,得到终端设备自身的当前倾角,来得到噪声源的绝对DOA。在这种机制下,当用户使用不同的方式握持终端设备时,例如横握或纵握情况下,根据IMU的读数,绝对DOA的检测结果可能不同。
[0093] 需要说明的是,步骤302和303的时序不做限定。
[0094] 304、终端设备根据第一坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0095] 可选的,还可以包括:终端设备通过惯性测量单元,得到终端设备的当前倾角;终端设备根据第一坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数,可以包括:终端设备根据第一坐标,以及噪声源位置和终端设备的当前倾角,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0096] 可选的,终端设备获取第一加速度;终端设备根据声音信号、当前倾角和第一加速度中的至少一项,判断是否发生碰撞。示例性的,终端设备可以通过惯性测量单元直接读取第一加速度。
[0097] 可选的,终端设备根据声音信号、当前倾角和第一加速度中的至少一项,判断是否发生碰撞,包括但不限于以下的实现方式:
[0098] (1)终端设备根据声音信号,通过基于短时能量分析和频谱特征分析的方法,或,通过基于深度神经网络的方法,确定终端设备是否发生碰撞;和/或,
[0099] (2)终端设备根据第一加速度确定终端设备是否发生碰撞;和/或,
[0100] (3)终端设备根据当前倾角,确定第二加速度;根据第二加速度确定终端设备是否发生碰撞。
[0101] 可选的,终端设备根据第一加速度确定终端设备是否发生碰撞,可以包括:终端设备确定第一加速度与前一周期的第一加速度的第一差值绝对值,若第一差值绝对值小于第一预设阈值,则确定终端设备未发生碰撞,第一加速度是当前周期的加速度。
[0102] 可选的,终端设备根据当前倾角,确定第二加速度;根据第二加速度确定终端设备是否发生碰撞,可以包括:终端设备根据当前倾角,确定第二加速度,第二加速度是当前周期的加速度;确定第二加速度与前一周期第二加速度的第二差值绝对值;若第二差值绝对值小于第一预设阈值,则确定终端设备未发生碰撞,前一周期第二加速度是根据前一周期的倾角确定的。
[0103] 可以理解的是,终端设备中的碰撞检测模块:利用IMU的读数和/或音频分析,来判断终端设备是否发生碰撞。在发生碰撞时,终端设备中的麦克风阵列有可能采集到异常冲击,而这将对算法处理造成严重影响,甚至有可能在用户的耳机中产生更大音量的冲击噪声。因此,在检测到碰撞时,可以暂时禁用后续的主动降噪处理,因为在本发明实施例中,终端设备主要进行降噪处理,如果终端设备自己变成一个噪声源的话,进行降噪处理的效果较差。例如:可以利用IMU的读数进行碰撞检测时,可以通过检测其输出的加速度值的突变来完成。而基于音频分析进行碰撞检测时,可以通过基于短时能量分析和频谱特征分析的方法,也可以通过基于DNN的方法来进行检测。其中,通过基于DNN的方法,具体可以是通过大量碰撞的录音数据训练出一个神经网络分类器来进行检测,也可以是通过大量普通的噪声数据训练出一个神经网络分类器来进行检测。可选的,IMU的读数和音频分析两种方法的检测结果可以一起进行平滑处理,以提升检测的鲁棒性。
[0104] 可选的,终端设备计算得到用户耳部与终端设备之间的第一声音传递函数,可以包括但不限于以下的实现方式:
[0105] (1)根据第一坐标以及噪声源位置,与匹配条件下预先测量的多个传递函数进行插值计算,得到用户耳部与终端设备之间的第一声音传递函数;或,
[0106] (2)根据第一坐标以及噪声源位置,通过基于深度神经网络的方法,得到用户耳部与终端设备之间的第一声音传递函数;或,
[0107] (3)根据第一坐标,以及噪声源位置和终端设备的当前倾角,与匹配条件下预先测量的多个传递函数进行插值计算,得到用户耳部与终端设备之间的第一声音传递函数;或,[0108] (4)根据第一坐标,以及噪声源位置和终端设备的当前倾角,通过基于深度神经网络的方法,得到用户耳部与终端设备之间的第一声音传递函数;或,
[0109] (5)根据第三坐标以及噪声源位置,与匹配条件下预先测量的多个传递函数进行插值计算,得到用户耳部与终端设备之间的第一声音传递函数;或,
[0110] (6)根据第三坐标以及噪声源位置,通过基于深度神经网络的方法,得到用户耳部与终端设备之间的第一声音传递函数。
[0111] (7)根据第三坐标,以及噪声源位置和终端设备的当前倾角,与匹配条件下预先测量的多个传递函数进行插值计算,得到用户耳部与终端设备之间的第一声音传递函数;或,[0112] (8)根据第三坐标,以及噪声源位置和终端设备的当前倾角,通过基于深度神经网络的方法,得到用户耳部与终端设备之间的第一声音传递函数。
[0113] 可以理解的是,第一声音传递函数的估计可以根据第三坐标、噪声源位置和终端设备的当前倾角,对一组在近似条件下事先测量的声音传递函数进行插值得到;也可以通过基于DNN的方法,即通过大量事先测量的声音传递函数和对应的第三坐标、噪声源位置和终端设备的当前倾角,训练出一个神经网络传递函数生成器,来生成对应的第一声音传递函数。
[0114] 可选的,第一声音传递函数的估计也可以被近似为估计从麦克风阵列到用户耳部的相位差和幅度差,这样滤波处理也可以被简化为平移和缩放处理。要估计相位差和幅度差,只需要分别获得用户耳部和麦克风阵列相对于噪声方向的距离差。在算力受限的系统中,使用近似算法可以提高双耳滤波的运算速度。
[0115] 可选的,用户面部图像包括用户耳部轮廓特征,还可以包括:终端设备根据用户耳部轮廓特征,对第一声音传递函数进行修正,得到修正后的第一声音传递函数。
[0116] 可以理解的是,终端设备中的人脸3D建模模块:还可以检测用户耳廓的形状特征,根据这些特征对第一声音传递函数进行一定程度的修正。
[0117] 305、终端设备获取当前使用耳机外壳到用户耳内之间的第二声音传递函数。
[0118] 可选的,终端设备获取当前使用耳机外壳到用户耳内的第二传递函数,可以包括:终端设备获取当前使用耳机的型号;终端设备根据当前使用耳机的型号在耳机型号数据库中,查找得到当前使用耳机外壳到用户耳内的第二传递函数,耳机型号数据库中保存有不同型号的耳机与对应传递函数的关系。
[0119] 可选的,终端设备获取当前使用耳机的型号,可以包括但不限于以下的实现方式:
[0120] (1)终端设备显示预设耳机型号列表;终端设备响应用户对预设耳机型号列表的选择,获取当前使用耳机的型号,可参考图4C所示;或,
[0121] (2)终端设备采集当前使用耳机的图像;终端设备根据当前使用耳机的图像与预设耳机图像进行匹配,得到当前使用耳机的型号,可参考图4D所示;或,
[0122] (3)终端设备响应用户对当前使用耳机的型号的输入操作,得到当前使用耳机的型号,可参考图4E所示;或,
[0123] (4)终端设备检测到当前用户使用耳机连接终端设备时,采集当前用户的正面人脸图像,并调用系统的人脸识别模块得到当前用户的当前身份标识;终端设备根据当前身份标识从存储区中读取当前用户的耳机型号列表,并提示当前用户选择当前所使用耳机的型号。
[0124] 可以理解的是,终端设备中的耳机型号识别模块:主要功能是在用户不知道自己耳机型号时,通过采集当前使用耳机的图像从互联网上的耳机图像数据库中进行搜索匹配,并从已知耳机型号中找到外观与其最接近的型号。随后可以以最接近的耳机型号的耳机传递函数,近似地作为用户使用耳机的特性,并在主动降噪算法过程中使用。可选的,可以通过大量的已知耳机型号的耳机图片,训练一个深度神经网络(DeepNeuralNetwork,DNN)来完成耳机型号的识别。
[0125] 在本发明实施例中,使用耳机型号数据库来获得耳机自身的传递函数,在用户不知道自己的耳机型号时,利用终端设备上的摄像头和视觉分析可以大致估计耳机的类型,来提升降噪效果,使降噪效果与耳机特征高度适配。
[0126] 需要说明的是,步骤305与步骤302‑304的时序不做限定。
[0127] 306、终端设备根据第一声音传递函数对声音信号进行第一滤波和下混处理,得到耳外噪声信号。
[0128] 可以理解的是,终端设备中的双耳滤波和下混模块,用于对麦克风阵列所采集到的多通道声音信号进行双耳滤波和下混,以模拟用户双耳所在位置应该收到的耳外噪声信号。
[0129] 307、终端设备根据第二声音传递函数对耳外噪声信号进行第二滤波处理,得到耳内噪声信号。
[0130] 可以理解的是,终端设备中的耳机特性滤波模块,使用当前用户所使用的耳机所对应的从外壳到耳内的第二声音传递函数,对耳外噪声信号进行滤波处理,以得到估计的耳内噪声信号。其中,所使用的第二声音传递函数是从耳机型号数据库中根据耳机的型号查找得到的。可以通过事先测量常见耳机型号的传递函数,来建立这样的耳机型号数据库。当用户所使用的耳机不在耳机型号数据库中时,也可以通过耳机型号识别模块从耳机型号数据库中匹配与用户耳机外观最接近的耳机型号并使用相应的声音传递函数。
[0131] 308、终端设备根据耳内噪声信号,对向当前使用耳机的输出信号进行降噪处理。
[0132] 可选的,终端设备根据耳内噪声信号,对向当前使用耳机的输出信号进行降噪处理,可以包括:终端设备对耳内噪声信号进行反相处理,得到反相处理的耳内噪声信号;终端设备将反相处理的耳内噪声信号叠加在向当前使用耳机的输出信号上。
[0133] 可以理解的是,终端设备中的混音模块,简单地将耳内噪声的估计进行反相处理然后叠加到耳机的原始输出信号上,以抑制原始输出信号中的耳部噪声信号。
[0134] 可选的,噪声源是移动的噪声源。即利用终端设备上的麦克风阵列和更强的处理能力,结合IMU,对移动的噪声源可以实现更准确的定位和跟踪,从而达到更好的降噪效果。
[0135] 可选的,声音信号的频率小于第二预设阈值。可以理解的是,受到噪声源定位精度以及终端设备到用户耳部之间距离估计精度的影响,对于频率较高的声音信号可能存在比较大的相位误差,从而影响降噪效果甚至反而放大高频噪声的能量。因此本发明实施例可以关注低频噪声的处理,例如当截止频率为200Hz时,只处理耳部噪声信号中200Hz以下的部分,而对于200Hz以上的部分可以不做处理。这里的200Hz只是示例说明,并不构成对本发明保护范围的限定。可选的,具体的截止频率可以根据终端设备的麦克风阵列阵型、噪声源定位算法精度、视觉定位算法精度等共同决定。
[0136] 可选的,本发明实施例所应用的使用场景可以是低频噪声为主的场景,或,有移动噪声源的场景等。例如:公共交通工具、马路、有空调或风扇的室内环境等。
[0137] 在本发明实施例中,将传统主动降噪的过程从耳机放到终端设备上来进行,并结合终端设备上的麦克风阵列、摄像头、IMU等多模态信息和音频、视觉算法来优化降噪效果。用户不需要额外的花费,使用普通耳机即可在看视频(例如电影、电视剧、综艺节目等)或打游戏等时进行降噪,体验到更佳的音效。在第一播放模式下,可以利用终端设备上的摄像头和视觉测距手段,得到更准确的声音传递函数估计,从而获得更好的降噪效果。
[0138] 这里的声音传递函数包括用户耳部与终端设备之间的第一声音传递函数,以及用户当前使用耳机外壳到耳内的第二声音传递函数,终端设备对声音信号经过第一声音传递函数的第一滤波和下混处理,得到耳外噪声信号;再对耳外噪声信号经过第二声音传递函数的第二滤波处理,得到耳内噪声信号;这时,得到的耳内噪声信号更接近用户实际收到的耳部噪声信号,再对耳内噪声信号进行反相处理,叠加在往当前使用耳机的输出信号上,降噪效果更佳。
[0139] 如图5所示,为本发明实施例中降噪方法的另一个实施例示意图,可以包括:
[0140] 501、终端设备采集声音信号。
[0141] 需要说明的是,本发明实施例中的步骤501,可以参考图3所示实施例中的步骤301,此处不再赘述。
[0142] 502、终端设备在检测到当前处于第二播放模式的情况下,接收用户输入的用户使用姿态和终端设备放置的位置,第二播放模式为用户面部不面向终端设备的播放模式。
[0143] 可选的,如果终端设备自动检测当前处于第二播放模式的情况下,那么终端设备可以输出第二提示信息,第二提示信息用于提示用户输入自己的使用姿态以及终端设备放置的位置;终端设备响应用户的输入操作,获取用户使用姿态和终端设备放置的位置。
[0144] 示例性的,第二播放模式为用户不面向终端设备的屏幕,使用终端设备听歌,听广播等场景。用户使用姿态可以是站姿、坐姿、躺着、趴着等使用姿态;用户可以在终端设备的交互式界面上选择终端设备放置的大致位置,可以是将终端设备放置于用户耳部相对固定的位置,如桌面上、口袋、裤兜、包包、背包内,且不面向屏幕,如听音乐等。如图4G所示,为本发明实施例中终端设备处于第二播放模式的一个示意图。
[0145] 503、终端设备根据用户使用姿态和终端设备放置的位置,确定用户面部中的特征点相对于终端设备的第一坐标。
[0146] 在第二播放模式下,终端设备根据用户所选择的用户使用姿态以及终端设备放置的大致位置,计算得到用户面部中的特征点相对于终端设备的第一坐标。
[0147] 可选的,终端设备根据用户面部中的特征点相对于终端设备的第一坐标,可以通过用户面部中的特征点与终端设备的第一距离得到。
[0148] 504、终端设备根据声音信号,得到噪声源位置。
[0149] 505、终端设备根据第一坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0150] 506、终端设备获取当前使用耳机外壳到用户耳内之间的第二声音传递函数。
[0151] 507、终端设备根据第一声音传递函数对声音信号进行第一滤波和下混处理,得到耳外噪声信号。
[0152] 508、终端设备根据第二声音传递函数对耳外噪声信号进行第二滤波处理,得到耳内噪声信号。
[0153] 509、终端设备根据耳内噪声信号,对向当前使用耳机的输出信号进行降噪处理。
[0154] 需要说明的是,本发明实施例中的步骤504‑509,可以参考图3所示实施例中的步骤303‑308,此处不再赘述。
[0155] 在本发明实施例中,将传统主动降噪的过程从耳机放到终端设备上来进行,用户不需要额外的花费,使用普通耳机即可在听音乐等进行降噪处理后,体验更佳的音效。在第二播放模式下,可以根据用户所选择的用户使用姿态以及终端设备放置的大致位置,计算得到用户面部中的特征点相对于终端设备的第一坐标,结合噪声源位置和智能终端的自身倾角来获得用户耳部与终端设备之间的第一声音传递函数,再结合用户当前使用耳机外壳到耳内的第二声音传递函数;即终端设备对声音信号经过第一声音传递函数的第一滤波和下混处理,得到耳外噪声信号;再对耳外噪声信号经过第二声音传递函数的第二滤波处理,得到耳内噪声信号;这时,得到的耳内噪声信号更接近用户实际收到的耳部噪声信号,再对耳内噪声信号进行反相处理,叠加在往当前使用耳机的输出信号上,降噪效果更佳。
[0156] 在第二播放模式下,终端设备根据用户所选择的用户使用姿态以及终端设备放置的大致位置,计算得到用户面部中的特征点相对于终端设备的第一坐标,依赖于大致估计,降噪效果可能会劣于第一播放模式下的降噪效果。
[0157] 需要说明的是,在终端设备上配合普通耳机进行的降噪,测试使用普通耳机连接终端设备时有一定的降噪效果可以作为举证的一种方式。在IMU和躁声源定位的结合中,可以禁用IMU,然后测试对噪声源的降噪效果是否变差,更换手机握持方式(例如横握、纵握等方式)时降噪效果是否变差,也可以作为举证的一种方式。利用摄像头进行人脸3D建模的特性通过产品实际的注册和使用流程也可以举证。在使用时实时距离测量的部分可以通过禁用摄像头,在使用过程中前后移动终端设备,测试降噪效果是否变差来进行举证。利用耳机型号数据库来获得耳机自身的传递函数,通过产品实际的注册和使用流程也可以举证。
[0158] 如图6A所示,为本发明实施例中终端设备的另一个实施例示意图,可以包括:
[0159] 采集模块601,用于采集声音信号;
[0160] 处理模块602,用于获取用户耳部与所述终端设备之间的第一声音传递函数;根据所述第一声音传递函数对所述声音信号进行处理,得到耳部噪声信号;根据所述耳部噪声信号,对向当前使用耳机的输出信号进行降噪处理。
[0161] 需要说明的是,图6A所示的终端设备可以对应执行上述方法实施例,此处不再赘述。
[0162] 如图6B所示,为本发明实施例中终端设备的另一个实施例示意图,可以包括:
[0163] 图6B示出的是与本发明实施例提供的终端设备相关的手机的部分结构的框图。参考图6B,手机包括:射频(RadioFrequency,RF)电路610、存储器620、输入单元630、显示单元640、传感器650、音频电路660、无线保真(wirelessfidelity,WiFi)模块670、处理器680、以及电源690等部件。本领域技术人员可以理解,图6B中示出的手机结构并不构成对手机的限定,可以包括比图示更多或更少的部件,或者组合某些部件,或者不同的部件布置。
[0164] 下面结合图6B对手机的各个构成部件进行具体的介绍:
[0165] RF电路610可用于收发信息或通话过程中,信号的接收和发送,特别地,将基站的下行信息接收后,给处理器680处理;另外,将设计上行的数据发送给基站。通常,RF电路610包括但不限于天线、至少一个放大器、收发信机、耦合器、低噪声放大器(LowNoiseAmplifier,LNA)、双工器等。此外,RF电路610还可以通过无线通信与网络和其他设备通信。上述无线通信可以使用任一通信标准或协议,包括但不限于全球移动通讯系统(GlobalSystemofMobilecommunication,GSM)、通用分组无线服务(GeneralPacketRadioService,GPRS)、码分多址(CodeDivisionMultipleAccess,CDMA)、宽带码分多址(WidebandCodeDivisionMultipleAccess,WCDMA)、长期演进(LongTermEvolution,LTE)、电子邮件、短消息服务(ShortMessagingService,SMS)等。
[0166] 存储器620可用于存储软件程序以及模块,处理器680通过运行存储在存储器620的软件程序以及模块,从而执行手机的各种功能应用以及数据处理。存储器620可主要包括存储程序区和存储数据区,其中,存储程序区可存储操作系统、至少一个功能所需的应用程序(比如声音播放功能、图像播放功能等)等;存储数据区可存储根据手机的使用所创建的数据(比如音频数据、电话本等)等。此外,存储器620可以包括高速随机存取存储器,还可以包括非易失性存储器,例如至少一个磁盘存储器件、闪存器件、或其他易失性固态存储器件。
[0167] 输入单元630可用于接收输入的数字或字符信息,以及产生与手机的用户设置以及功能控制有关的键信号输入。具体地,输入单元630可包括触控面板631以及其他输入设备632。触控面板631,也称为触摸屏,可收集用户在其上或附近的触摸操作(比如用户使用手指、触笔等任何适合的物体或附件在触控面板631上或在触控面板631附近的操作),并根据预先设定的程式驱动相应的连接装置。可选的,触控面板631可包括触摸检测装置和触摸控制器两个部分。其中,触摸检测装置检测用户的触摸方位,并检测触摸操作带来的信号,将信号传送给触摸控制器;触摸控制器从触摸检测装置上接收触摸信息,并将它转换成触点坐标,再送给处理器680,并能接收处理器680发来的命令并加以执行。此外,可以采用电阻式、电容式、红外线以及表面声波等多种类型实现触控面板631。除了触控面板631,输入单元630还可以包括其他输入设备632。具体地,其他输入设备632可以包括但不限于物理键盘、功能键(比如音量控制按键、开关按键等)、轨迹球、鼠标、操作杆等中的一种或多种。
[0168] 显示单元640可用于显示由用户输入的信息或提供给用户的信息以及手机的各种菜单。显示单元640可包括显示面板641,可选的,可以采用液晶显示器(LiquidCrystalDisplay,LCD)、有机发光二极管(OrganicLight‑EmittingDiode,OLED)等形式来配置显示面板641。进一步的,触控面板631可覆盖显示面板641,当触控面板631检测到在其上或附近的触摸操作后,传送给处理器680以确定触摸事件的类型,随后处理器680根据触摸事件的类型在显示面板641上提供相应的视觉输出。虽然在图6B中,触控面板631与显示面板641是作为两个独立的部件来实现手机的输入和输入功能,但是在某些实施例中,可以将触控面板631与显示面板641集成而实现手机的输入和输出功能。
[0169] 手机还可包括至少一种传感器650,比如光传感器、运动传感器以及其他传感器。具体地,光传感器可包括环境光传感器及接近传感器,其中,环境光传感器可根据环境光线的明暗来调节显示面板641的亮度,接近传感器可在手机移动到耳边时,关闭显示面板641和/或背光。作为运动传感器的一种,加速计传感器可检测各个方向上(一般为三轴)加速度的大小,静止时可检测出重力的大小及方向,可用于识别手机姿态的应用(比如横竖屏切换、相关游戏、磁力计姿态校准)、振动识别相关功能(比如计步器、敲击)等;至于手机还可配置的陀螺仪、气压计、湿度计、温度计、红外线传感器等其他传感器,在此不再赘述。
[0170] 音频电路660、扬声器661,传声器662可提供用户与手机之间的音频接口。音频电路660可将接收到的音频数据转换后的电信号,传输到扬声器661,由扬声器661转换为声音信号输出;另一方面,传声器662将收集的声音信号转换为电信号,由音频电路660接收后转换为音频数据,再将音频数据输出处理器680处理后,经RF电路610以发送给比如另一手机,或者将音频数据输出至存储器620以便进一步处理。
[0171] WiFi属于短距离无线传输技术,手机通过WiFi模块670可以帮助用户收发电子邮件、浏览网页和访问流式媒体等,它为用户提供了无线的宽带互联网访问。虽然图6B示出了WiFi模块670,但是可以理解的是,其并不属于手机的必须构成,完全可以根据需要在不改变发明的本质的范围内而省略。
[0172] 处理器680是手机的控制中心,利用各种接口和线路连接整个手机的各个部分,通过运行或执行存储在存储器620内的软件程序和/或模块,以及调用存储在存储器620内的数据,执行手机的各种功能和处理数据,从而对手机进行整体监控。可选的,处理器680可包括一个或多个处理单元;优选的,处理器680可集成应用处理器和调制解调处理器,其中,应用处理器主要处理操作系统、用户界面和应用程序等,调制解调处理器主要处理无线通信。可以理解的是,上述调制解调处理器也可以不集成到处理器680中。
[0173] 手机还包括给各个部件供电的电源690(比如电池),优选的,电源可以通过电源管理系统与处理器680逻辑相连,从而通过电源管理系统实现管理充电、放电、以及功耗管理等功能。
[0174] 尽管未示出,手机还可以包括摄像头、蓝牙模块等,在此不再赘述。
[0175] 在本发明实施例中,传声器662,用于采集声音信号;
[0176] 处理器680,用于获取用户耳部与终端设备之间的第一声音传递函数;根据第一声音传递函数对声音信号进行处理,得到耳部噪声信号;以及根据耳部噪声信号,对向当前使用耳机的输出信号进行降噪处理。
[0177] 可选的,处理器680,还用于获取当前使用耳机外壳到用户耳内之间的第二声音传递函数。
[0178] 可选的,处理器680,具体用于根据第一声音传递函数和第二声音传递函数对声音信号进行处理,得到耳部噪声信号。
[0179] 可选的,处理器680,具体用于根据第一声音传递函数对声音信号进行第一滤波和下混处理,得到耳外噪声信号;根据第二声音传递函数对耳外噪声信号进行第二滤波处理,得到耳内噪声信号;根据耳内噪声信号,对向当前使用耳机的输出信号进行降噪处理。
[0180] 可选的,处理器680,具体用于在检测到当前处于第一播放模式的情况下,获取用户面部中的特征点相对于终端设备的第一坐标,第一播放模式为用户面部面向终端设备的播放模式;根据声音信号,得到噪声源位置;根据第一坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0181] 可选的,处理器680,具体用于根据第一坐标,以及预设的用户耳部与用户面部中的特征点的第二坐标,得到用户耳部相对于终端设备的第三坐标;根据第三坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0182] 可选的,处理器680,具体用于在检测到当前处于第二播放模式的情况下,接收用户输入的用户使用姿态和终端设备放置的位置,第二播放模式为用户面部不面向终端设备的播放模式;根据用户使用姿态和终端设备放置的位置,确定用户面部中的特征点相对于终端设备的第一坐标;根据声音信号,得到噪声源位置;根据第一坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0183] 可选的,处理器680,还用于备通过惯性测量单元,得到终端设备的当前倾角;根据第一坐标,以及噪声源位置和终端设备的当前倾角,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0184] 可选的,处理器680,具体用于通过摄像头采集用户面部图像进行视觉分析,或,通过超声测距方法,获取用户面部中的特征点相对于终端设备的第一坐标。
[0185] 可选的,处理器680,还用于根据用户面部图像和用户预设的人脸3D模型,得到用户耳部相对于用户面部中的特征点的第四坐标;根据第一坐标和第四坐标,得到用户耳部相对于终端设备的第五坐标;根据第五坐标,以及噪声源位置,计算得到用户耳部与终端设备之间的第一声音传递函数。
[0186] 可选的,处理器680,还用于根据用户耳部轮廓特征,对第一声音传递函数进行修正,得到修正后的第一声音传递函数。
[0187] 可选的,处理器680,还用于根据第一坐标,以及噪声源位置和终端设备的当前倾角,与匹配条件下预先测量的多个传递函数进行插值计算,得到用户耳部与终端设备之间的第一声音传递函数;或,根据第一坐标,以及噪声源位置和终端设备的当前倾角,通过基于深度神经网络的方法,得到用户耳部与终端设备之间的第一声音传递函数。
[0188] 可选的,传声器662,具体用于终端设备通过多个麦克风采集多个声音信号;
[0189] 处理器680,具体用于对多个声音信号使用相位加权的互相关方法,计算得到到达时间差;根据到达时间差,得到噪声源位置。
[0190] 可选的,处理器680,具体用于获取当前使用耳机的型号;根据当前使用耳机的型号在耳机型号数据库中,查找得到当前使用耳机外壳到用户耳内的第二传递函数,耳机型号数据库中保存有不同型号的耳机与对应传递函数的关系。
[0191] 可选的,显示单元640,用于显示预设耳机型号列表;处理器680,具体用于响应用户对预设耳机型号列表的选择,获取当前使用耳机的型号;或,
[0192] 摄像头,用于采集当前使用耳机的图像;处理器680,具体用于根据当前使用耳机的图像与预设耳机图像进行匹配,得到当前使用耳机的型号;或,
[0193] 处理器680,具体用于响应用户对当前使用耳机的型号的输入操作,得到当前使用耳机的型号。
[0194] 可选的,处理器680,还用于获取第一加速度;根据声音信号、当前倾角和第一加速度中的至少一项,判断是否发生碰撞。
[0195] 可选的,处理器680,还用于根据声音信号,通过基于短时能量分析和频谱特征分析的方法,或,通过基于深度神经网络的方法,确定终端设备是否发生碰撞;和/或,[0196] 处理器680,还用于根据第一加速度确定终端设备是否发生碰撞;和/或,[0197] 处理器680,还用于根据当前倾角,确定第二加速度;根据第二加速度确定终端设备是否发生碰撞。
[0198] 可选的,声音信号的频率小于第二预设阈值。
[0199] 在上述实施例中,可以全部或部分地通过软件、硬件、固件或者其任意组合来实现。当使用软件实现时,可以全部或部分地以计算机程序产品的形式实现。
[0200] 所述计算机程序产品包括一个或多个计算机指令。在计算机上加载和执行所述计算机程序指令时,全部或部分地产生按照本发明实施例所述的流程或功能。所述计算机可以是通用计算机、专用计算机、计算机网络、或者其他可编程装置。所述计算机指令可以存储在计算机可读存储介质中,或者从一个计算机可读存储介质向另一计算机可读存储介质传输,例如,所述计算机指令可以从一个网站站点、计算机、服务器或数据中心通过有线(例如同轴电缆、光纤、数字用户线(DSL))或无线(例如红外、无线、微波等)方式向另一个网站站点、计算机、服务器或数据中心进行传输。所述计算机可读存储介质可以是计算机能够存储的任何可用介质或者是包含一个或多个可用介质集成的服务器、数据中心等数据存储设备。所述可用介质可以是磁性介质,(例如,软盘、硬盘、磁带)、光介质(例如,DVD)、或者半导体介质(例如固态硬盘SolidStateDisk(SSD))等。
[0201] 所属领域的技术人员可以清楚地了解到,为描述的方便和简洁,上述描述的系统,装置和单元的具体工作过程,可以参考前述方法实施例中的对应过程,在此不再赘述。
[0202] 在本发明所提供的几个实施例中,应该理解到,所揭露的系统,装置和方法,可以通过其它的方式实现。例如,以上所描述的装置实施例仅仅是示意性的,例如,所述单元的划分,仅仅为一种逻辑功能划分,实际实现时可以有另外的划分方式,例如多个单元或组件可以结合或者可以集成到另一个系统,或一些特征可以忽略,或不执行。另一点,所显示或讨论的相互之间的耦合或直接耦合或通信连接可以是通过一些接口,装置或单元的间接耦合或通信连接,可以是电性,机械或其它的形式。
[0203] 所述作为分离部件说明的单元可以是或者也可以不是物理上分开的,作为单元显示的部件可以是或者也可以不是物理单元,即可以位于一个地方,或者也可以分布到多个网络单元上。可以根据实际的需要选择其中的部分或者全部单元来实现本实施例方案的目的。
[0204] 另外,在本发明各个实施例中的各功能单元可以集成在一个处理单元中,也可以是各个单元单独物理存在,也可以两个或两个以上单元集成在一个单元中。上述集成的单元既可以采用硬件的形式实现,也可以采用软件功能单元的形式实现。
[0205] 所述集成的单元如果以软件功能单元的形式实现并作为独立的产品销售或使用时,可以存储在一个计算机可读取存储介质中。基于这样的理解,本发明的技术方案本质上或者说对现有技术做出贡献的部分或者该技术方案的全部或部分可以以软件产品的形式体现出来,该计算机软件产品存储在一个存储介质中,包括若干指令用以使得一台计算机设备(可以是个人计算机,服务器,或者网络设备等)执行本发明各个实施例所述方法的全部或部分步骤。而前述的存储介质包括:U盘、移动硬盘、只读存储器(ROM,Read‑OnlyMemory)、随机存取存储器(RAM,RandomAccessMemory)、磁碟或者光盘等各种可以存储程序代码的介质。
[0206] 以上所述,以上实施例仅用以说明本发明的技术方案,而非对其限制;尽管参照前述实施例对本发明进行了详细的说明,本领域的普通技术人员应当理解:其依然可以对前述各实施例所记载的技术方案进行修改,或者对其中部分技术特征进行等同替换;而这些修改或者替换,并不使相应技术方案的本质脱离本发明各实施例技术方案的精神和范围。
专利地区:广东
专利申请日期:2020-09-17
专利公开日期:2023-01-03
专利公告号:CN114205701B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




