 产学研创新服务平台(全国)


一种歌单多标签推荐方法、系统、设备和存储介质
更新时间:2026-11-01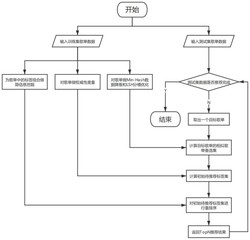 专利申请类型:发明专利;
地区:陕西-西安;
源自:西安高价值专利检索信息库;
一种歌单多标签推荐方法、系统、设备和存储介质
摘要:一种歌单多标签推荐方法、系统、设备和存储介质,将歌单数据分为测试集和训练集,将训练集中的歌曲信息、歌手信息和用户信息分别采用局部敏感哈希算法计算歌曲信息哈希桶、歌手信息哈希桶和用户信息哈希桶;对测试集中的歌曲、歌手和用户信息分别根据相应哈希桶映射,得出相似歌单备选集,计算初始待推荐标签集;对根据训练集中的歌单标签集挖掘,得到标签的关联规则集合,再进行标签重排序,选择排序靠前的前A个标签进行推荐,实现歌单推荐。本发明具有更高的推荐准确性和更低的时间消耗。本发明与当前在线音乐平台所采用的基于协同过滤算法的推荐模型具有更好的兼容性,升级系统推荐算法的成本和风险更低,方法简单高效。
专利类型:发明专利
专利申请号:CN202110316152.2
专利申请(专利权)人:西安交通大学
权利人地址:陕西省西安市咸宁西路28号
专利发明(设计)人:王晨旭,郭晨野,杨煜,索凯强,管晓宏
主权利要求:一种歌单多标签推荐方法、系统、设备和存储介质
技术领域
[0001] 本发明涉及音乐推荐系统领域,具体涉及一种歌单多标签推荐方法、系统、设备和存储介质。
背景技术
[0002] 歌单标签对于改善在线音乐用户的听歌体验,鼓励用户制作个性化歌单方面具有重要作用。受益于大数据技术的发展,人们可以从大量带有专家标签的歌单中隐含地推断出歌单中歌曲的特征。协同过滤算法作为经典的推荐算法,可以帮助人们从大量数据中得出歌单的隐含信息,进而根据目标歌单获取与其相似的其他歌单,然后通过相似歌单集合计算目标歌单可能适用的标签。然而,在大数据时代下的协同过滤算法虽然应用较为广泛,但由于歌单数据的高维稀疏性,传统的协同过滤算法在进行歌单标签推荐时依然存在推荐准确度低,计算复杂度高且无法对新创作歌单进行实时在线推荐标签等问题,使得这种方法很难在实践中得以应用。
发明内容
[0003] 本发明目的在于提供一种歌单多标签推荐方法、系统、设备和存储介质。
[0004] 为实现上述目的,本发明采用如下的技术方案实现:
[0005] 一种歌单多标签推荐方法,其特征在于,
[0006] 将歌单数据分为测试集和训练集,将训练集中的歌曲信息、歌手信息和用户信息分别采用局部敏感哈希算法计算歌曲信息哈希桶、歌手信息哈希桶和用户信息哈希桶;
[0007] 采用局部敏感哈希算法对测试集中的歌曲、歌手和用户信息分别根据歌曲信息哈希桶、歌手信息哈希桶和用户信息哈希桶进行哈希映射,得出相似歌单备选集;
[0008] 根据相似歌单备选集和每个歌单的标签相关度权值计算初始待推荐标签集;
[0009] 通过FP‑Growth算法对根据训练集中的歌单标签集挖掘,得到标签的关联规则集合,根据标签的关联规则集合对初始待推荐标签集进行标签重排序,选择排序靠前的前A个标签进行推荐,实现歌单推荐,A为设置值。
[0010] 本发明进一步的改进在于,具体包括以下步骤:
[0011] 步骤1:采集歌单数据,将歌单数据分为测试集Ltest和训练集Ltrain,使用Min‑Hash算法分别将训练集Ltrain中的歌曲信息、歌手信息和用户信息歌单样本降维至N*K维,生成用户‑歌单签名矩阵、歌单‑歌手签名矩阵和歌单‑歌曲签名矩阵;其中,N为歌单集的数量,K为Min‑Hash算法中随机置换哈希函数的个数;
[0012] 步骤2:将用户‑歌单签名矩阵、歌单‑歌手签名矩阵和歌单‑歌曲签名矩阵进行LSH分桶优化,使相似样本分到同一个哈希桶中,并且对训练集Ltrain中的歌曲信息、歌手信息和用户信息的签名矩阵分别进行LSH分桶优化,得到歌单‑歌曲哈希桶、歌单‑歌手哈希桶与用户‑歌单哈希桶;
[0013] 步骤3:将测试集Ltest中目标歌单的歌曲信息、歌手信息和用户信息分别经过Min‑Hash降维后的签名向量输入到对应的歌单‑歌曲哈希桶、歌单‑歌手哈希桶与用户‑歌单哈希桶中进行相似歌单快速检索,得到目标歌单的相似歌单备选集Simset;
[0014] 步骤4:根据相似歌单备选集Simset以及标签相关度权值歌单标签相关度权值计算前z个推荐指标 最大的待推荐标签集合RecT;
[0015] 步骤5:通过FP‑Growth算法,将训练集Ltrain中的歌单标签组合LTag进行标签关联规则挖掘,得到标签的关联规则集合rulesT;
[0016] 步骤6:根据满足阈值的标签关联规则集合rulesT,对前z个推荐指标 最大的待推荐标签集合RecT中的标签进行重排序,然后选择前A个标签作为目标歌单最终的推荐结果。
[0017] 本发明进一步的改进在于,步骤1中,歌单‑歌曲签名矩阵SM通过以下过程生成:
[0018] 步骤1):将训练集中歌曲列表的歌曲下标值映射到歌单Li中的歌曲,生成歌单Li对应的歌曲下标列表 表示如下:
[0019]
[0020] 其中, 表示第j个歌曲在训练集歌曲列表中的下标值,j表示歌单Li的歌曲数;
[0021] 步骤2):初始化k,生成k个不同的随机置换函数hi(x),每个置换函数hi(x)的表示如下:
[0022]
[0023] 其中,HASH_PRIME是一个大素数,ai和bi都是[1,HASHPRIME‑1]之间的随机数, 表示输入的参数;
[0024] 步 骤3) :初始 化歌 单 Li 对应的 歌 曲下 标 列表 的 签 名向 量更新策略是将歌单Li对应的歌曲下标列表 中的每个歌曲下标分别代入第k个置换函数hk中,将签名向量 中的第k个参数 更新为最小值,表示如下:
[0025]
[0026] 步骤4):重复步骤3),将歌单Li对应的歌曲下标列表 的签名向量 更新完成,更新训练集Ltrain中剩下的N‑1个歌单,最终计算映射完成的用户‑歌单签名矩阵表示如下:
[0027]
[0028] 本发明进一步的改进在于,步骤2中,歌单‑歌曲哈希桶具体通过以下过程得到:
[0029] 步骤1):将歌单‑歌曲签名矩阵SM分为b段,每段由r行组成,其中b*r=k;
[0030] 步骤2):对歌单‑歌曲签名矩阵SM的每一列在每段上分别进行哈希分桶,得到若干哈希桶;在任意一段上被分到同一个哈希桶内的歌单认为是相似歌单;
[0031] 步骤3):计算测试集中的目标歌单所能映射到的哈希桶,则此哈希桶中的歌单作为与目标歌单相似的歌单集,从而得到歌单‑歌曲哈希桶;
[0032] 歌单‑歌曲哈希桶SimLM:
[0033] SimLM={Li→mj|i∈L,j∈M}
[0034] 歌单‑歌手哈希桶SimLS:
[0035] SimLS={Li→sk|i∈L,j∈S}
[0036] 用户‑歌单哈希桶SimLU:
[0037] SimLU={uj→Li|i∈L,j∈U}
[0038] 其中,M表示训练集Ltrain中歌曲集,S表示训练集Ltrain中歌手集,U表示训练集Ltrain中用户集。
[0039] 本发明进一步的改进在于,步骤4的具体过程如下:
[0040] 步骤5.1:初始化全量标签 其中c=73,每个标签的推荐指标 都初始化为1;
[0041] 步骤5.2:根据歌单标签相关度权值 更新标签Tag中的推荐指标 计算公式如下:
[0042]
[0043] 步骤5.3:计算目标歌单的相似歌单备选集Simset中的推荐指标 后,按推荐指标从高到低对标签进行排序,得到前z个推荐指标 最大的标签集合RecT,其中
[0044] 其中,歌单相关度权值 通过下式计算:
[0045]
[0046] 其中, 为训练集Ltrain的每一个歌单Li的标签组合在训练集Ltrain中出现的频率,Li为歌单,ti为歌单Li中的标签。
[0047] 本发明进一步的改进在于,步骤5的具体过程如下:
[0048] 步骤6.1:构建项头表,构建空FP树,并扫描训练集Ltrain中的歌单标签组合,对每种标签组合进行计数,根据计数结果,删除支持度低于最小支持度min_supp的标签组合得出第一项频繁项集,将其存入项头表,然后按支持度降序排序;
[0049] 步骤6.2:二次扫描训练集Ltrain中的歌单标签组合,去除非频繁一项集,按支持度降序排序,得到排好序的频繁项集;
[0050] 步骤6.3:将步骤6.2中的频繁项集依次插入FP树中;
[0051] 步骤6.4:通过项头表,递归挖掘频繁项集,并过滤掉不满足最小置信度min_conf的频繁项集,得出关联规则集合:
[0052]
[0053] 其中,rulesT表示标签关联规则集合,d表示挖掘到的关联规则总数,Ri表示第i个关联规则;
[0054] 支持度通过下式计算:
[0055]
[0056] 式中,δ(ti,tj)表示歌单标签组合[ti,tj]在Ltrain中标签组合出现的次数,δ(LTag)表示Ltrain中标签组合的总数;supp(ti→tj)表示这个组合的支持度;
[0057] 置信度通过下式计算:
[0058]
[0059] 式中,δ(ti)表示标签ti的总数,Conf(ti→tj)表示在标签ti出现的前提下,tj标签会出现的概率。
[0060] 本发明进一步的改进在于,步骤6的具体过程如下:
[0061] 步骤7.1:根据关联规则所表现出的标签之间隐性联系,对待推荐标签集RecT做标签推荐指标 重排序,计算公式如下:
[0062]
[0063] 步骤7.2:最后根据标签推荐指标 的结果对待推荐标签集RecT再次进行从高到低排序,选择前A个标签作为目标歌单最终的标签推荐结果。
[0064] 一种歌单多标签推荐系统,包括:
[0065] 哈希桶计算模块,用于将歌单数据分为测试集和训练集,将训练集中的歌曲信息、歌手信息和用户信息分别采用局部敏感哈希算法计算歌曲信息哈希桶、歌手信息哈希桶和用户信息哈希桶;
[0066] 哈希映射模块,用于采用局部敏感哈希算法对测试集中的歌曲、歌手和用户信息分别根据歌曲信息哈希桶、歌手信息哈希桶和用户信息哈希桶进行哈希映射,得出相似歌单备选集;
[0067] 初始待推荐标签集计算模块,用于根据相似歌单备选集和每个歌单的标签相关度权值计算初始待推荐标签集;
[0068] 标签重排序模块,用于通过FP‑Growth算法对根据训练集中的歌单标签集挖掘,得到标签的关联规则集合,根据标签的关联规则集合对初始待推荐标签集进行标签重排序,选择排序靠前的前A个标签进行推荐,实现歌单推荐,A为设置值。
[0069] 一种计算机设备,所述计算机设备包括存储器和处理器,所述存储器上存储有能在所述处理器上运行的计算机程序,所述计算机程序被所述处理器执行时实现如上述的歌单多标签推荐方法。
[0070] 一种计算机可读存储介质,所述计算机可读存储介质存储有计算机程序,所述计算机程序当被处理器执行时使所述处理器执行如权利要求上所述的歌单多标签推荐方法。
[0071] 本发明和现有技术相比较,具有如下有益效果:
[0072] 针对传统协同过滤算法在网易云歌单数据中推荐效率低下且推荐准确率不高等问题,提出了引入FP‑Growth的基于LSH/Min‑Hash的歌单标签推荐方法,其歌单标签推荐过程主要分为三步:首先,使用“标签频率决定权重”的思想对训练集歌单中歌单标签组合属性的权威性进行度量,通过歌单标签组合频率和逆标签频率来体现某一类标签对歌单类别的表达能力,从而解决标签推荐结果由于标签样本分布不均衡而导致的倾向与推荐热门标签的现象。其次,为了能快速的检索出测试集目标歌单的相似歌单备选集,通过Min‑Hash算法对歌单数据矩阵做k次哈希运算,将歌单数据映射为N*K维的歌单签名矩阵,达到矩阵压缩与降维的效果。在得到压缩后的签名矩阵基础上,利用LSH算法进行b重哈希,将局部相似的歌单映射到同一个哈希桶中,然后将至少有一次被映射到同一个哈希桶中的歌单作为候选相似对进行相似度计算,从而生成目标歌单的最近邻居集,也即是目标歌单的相似歌单备选集,解决了由于数据规模大而导致的检索相似歌单集效率低的问题。最后,在使用此备选集中的歌单形成标签的初始推荐结果的基础上,再利用FP‑Growth的标签隐信息挖掘技术,获取标签高质量的深层隐含关系对初始推荐结果进行重排序,然后选择前A个标签作为目标歌单最终的标签推荐结果,使得此推荐方法的准确性得到提升。本发明能够适应大规模歌单数据的标签推荐任务,具有结构简单,推荐高效的特点。相比于传统的协同过滤方法,本方法还能够为新创建的歌单数据作标签实时推荐的任务,且准确率高、推荐速度快。
附图说明
[0073] 图1为不同标签及标签组合所含歌单数量的幂律分布图。其中,(a)为标签排名,(b)为标签组合排名。
[0074] 图2为Top15标签和Top15标签组合所含歌单数量分布图。其中,(a)为单个标签分布,(b)为标签组合分布。
[0075] 图3为基于改进协同过滤算法的歌单多标签推荐方法的流程图。
[0076] 图4为使用LSH算法进行分桶优化的歌单签名矩阵示意图。
[0077] 图5为在不同数据集规模下的推荐用时与推荐准确性的对比图。
[0078] 图6为本方法(LSH)和传统协同过滤方法(TRAD)在不同优化方式下的对比图。
[0079] 图7为在两种数据集规模下不同优化方式的对比图。
具体实施方式
[0080] 下面结合附图对本发明做详细描述。
[0081] 一种基于改进协同过滤算法的歌单多标签推荐方法,使用抓取到的十万规模网易云音乐歌单数据,将其按照1∶9的比例分为测试集歌单数据Ltest和训练集歌单数据Ltrain。
[0082] 首先通过Ltrain计算出每个歌单的标签相关度权值,然后将Ltrain中的歌曲信息、歌手信息和用户信息分别使用局部敏感哈希算法计算出歌曲信息哈希桶SimLM、歌手信息哈希桶SimLS和用户信息哈希桶SimLU;
[0083] 接着使用局部敏感哈希算法对Ltest中的歌曲、歌手和用户信息分别根据哈希桶进行哈希映射,得出相似歌单备选集;
[0084] 然后根据相似歌单备选集计算出初始待推荐标签集RecT;
[0085] 最后通过FP‑Growth算法对根据训练集中的歌单标签集挖掘,得到标签的关联规则集合,根据标签的关联规则集合对初始待推荐标签集进行标签重排序,选择排序靠前的前A个标签进行推荐,从而实现歌单数据的快速、精准推荐效果。其中,A为设置值,0<A≤73。
[0086] 具体包括以下步骤:
[0087] 步骤1:通过歌单标签组合频率和逆标签频率计算歌单相关度权值
[0088] 具体的,歌单相关度权值 的具体计算过程如下:
[0089] 步骤1.1:首先歌单数据按1∶9分为测试集Ltest和训练集Ltrain,计算出Ltrain的每一个歌单Li的标签组合在整个Ltrain中出现的频率 并且计算出歌单Li中的标签ti单独出现在Ltrain中的频率
[0090] 步骤1.2:歌单相关度权值 计算公式如下:
[0091]
[0092] 步骤2:使用Min‑Hash算法分别将Ltrain中的歌曲信息、歌手信息和用户信息歌单样本降维至N*K维,生成三种签名矩阵,且N为歌单集的数量,K为Min‑Hash算法中随机置换哈希函数的个数;Ltrain中每个歌单Li包含3种类型的数据对象,分别为歌单Li的歌曲集LMi、歌手集LSi和其创建者LUi。
[0093] 生成歌单‑歌曲签名矩阵SM的具体过程如下:
[0094] 步骤2.1:将训练集中歌曲列表的歌曲下标值映射到歌单Li中的歌曲,生成歌单Li对应的歌曲下标列表 其表示如下:
[0095]
[0096] 其中, 表示第j个歌曲在训练集歌曲列表中的下标值,j表示歌单Li的歌曲数。
[0097] 步骤2.2:初始化k,生成k个不同的随机置换函数hi(x),每个置换函数hi(x)的表示如下:
[0098]
[0099] 其中,HASH_PRIME是一个大素数,ai和bi都是[1,HASHPRIME‑1]之间的随机数, 表示输入的参数。
[0100] 步骤2.3:初始化 的签名向量 更新策略是将 中的每个歌曲下标 分别代入第k个置换函数hk中,将签名向量 中的第k个参数 更新为其最小值,其表示如下:
[0101]
[0102] 步骤2.4:重复步骤2.3,将 的签名向量 更新完成,更新Ltrain中剩下的N‑1个歌单,最终会计算出映射完成的歌单‑歌曲签名矩阵 其表示如下:
[0103]
[0104] 训练集Ltrain中的歌单数据会以与歌单‑歌曲签名矩阵相同的方式分别生成歌单‑歌手签名矩阵和用户‑歌单签名矩阵。
[0105] 步骤3:将经过降维处理的Ltrain歌单签名矩阵进行LSH分桶优化,使相似样本分到同一个哈希桶(Hash‑bucket)中,而不具有相似性的样本能较大概率不被分到同一个哈希桶中,并且对Ltrain中的歌曲信息、歌手信息和用户信息的签名矩阵分别进行LSH分桶优化得到三种不同的哈希桶(Hash‑bucket),哈希桶的概念如下:
[0106] 哈希桶是指在哈希表中具有标识的用于存储经过哈希运算后的对象中的一块区域,若多个对象经过哈希运算后落入同一个桶中,则表明发生了冲突,而此哈希桶中的对象都具有较高的相似性;
[0107] 具体过程为:
[0108] 步骤3.1:将歌单‑歌曲签名矩阵SM分为b段,每段由r行组成,其中b*r=k;
[0109] 步骤3.2:对歌单‑歌曲签名矩阵SM的每一列即每个歌单的签名向量,在每段上分别进行哈希分桶,得到若干哈希桶;在任意一段上被分到同一个哈希桶内的歌单就认为是相似歌单。
[0110] 步骤3.3:最终,只需要计算测试集中的目标歌单所能映射到的哈希桶,那么此哈希桶中的歌单就作为与目标歌单相似的歌单集。
[0111] 步骤3.4:使用步骤3.1至步骤3.3的方式上述生成的歌单‑歌曲、歌单‑歌手与用户‑歌单签名矩阵分别生成对应歌单‑歌曲哈希桶、歌单‑歌手哈希桶与用户‑歌单哈希桶,具体如下:
[0112] 歌单‑歌曲Hash‑bucket:
[0113] SimLM={Li→mj|i∈L,j∈M}
[0114] 歌单‑歌手Hash‑bucket:
[0115] SimLS={Li→sk|i∈L,j∈S}
[0116] 用户‑歌单Hash‑bucket:
[0117] SimLU={uj→Li|i∈L,j∈U}
[0118] 其中,M表示Ltrain中歌曲集,S表示Ltrain中歌手集,U表示Ltrain中用户集。
[0119] 步骤4:将Ltest中目标歌单的歌曲信息、歌手信息和用户信息分别经过Min‑Hash降维后的签名向量输入到对应的歌单‑歌曲哈希桶、歌单‑歌手哈希桶与用户‑歌单哈希桶中进行相似歌单快速检索,得到目标歌单的相似歌单备选集Simset;
[0120] 步骤5:通过相似歌单备选集Simset以及歌单标签相关度权值 计算出前z个推荐指标 最大的待推荐标签集合RecT;具体过程为:
[0121] 步骤5.1:初始化全量标签 其中c=73,表示共有73种不同的标签,每个标签的推荐指标 都初始化为1;
[0122] 步骤5.2:结合歌单标签相关度权值 来更新标签Tag中的推荐指标 其计算公式如下:
[0123]
[0124] 步骤5.3:计算目标歌单的相似歌单备选集Simset中的推荐指标 后,按推荐指标从高到低对标签进行排序,得到前z个推荐指标 最大的标签集合RecT,其中
[0125] 步骤6:通过FP‑Growth算法,将训练集Ltrain中的歌单标签组合LTag进行标签关联规则挖掘,得到标签的关联规则集合rulesT;具体过程如下:
[0126] 通过FP‑Growth算法,根据经验设置最小支持度min_supp和最小置信度min_conf阈值,将Ltrain中的歌单标签组合进行标签关联规则挖掘时,删除支持度小于最小支持度的标签组合,再过滤掉置信度小于最小置信度的关联规则集合,最终得到满足阈值的标签关联规则集合rulesT;其中支持度和置信度的计算公式如下;
[0127] 支持度:
[0128]
[0129] 式中,δ(ti,tj)表示歌单标签组合[ti,tj]在Ltrain中标签组合出现的次数,δ(LTag)表示Ltrain中标签组合的总数。supp(ti→tj)表示这个组合的支持度,值越大表示这个组合出现的频率越大,两个标签越相关。
[0130] 置信度:
[0131]
[0132] 式中,δ(ti)表示标签ti的总数,conf(ti→tj)表示在标签ti出现的前提下,tj标签会出现的概率,若置信度为1,表示标签ti出现时,标签tj一定会出现。
[0133] 步骤6的具体过程如下:
[0134] 步骤1:构建项头表,构建空FP树,并扫描Ltrain中的歌单标签组合,对每种标签组合进行计数,根据计数结果,删除支持度低于最小支持度min_supp的标签组合得出第一项频繁项集,将其存入项头表,然后按支持度降序排序;
[0135] 步骤2:二次扫描Ltrain中的歌单标签组合,去除非频繁一项集,按支持度降序排序,得到排好序的频繁项集;
[0136] 步骤3:将步骤2中的频繁项集依次插入FP树中(FP树的祖先节点为排名在前的节点,子孙节点是排名靠后的节点。如果项集有公共祖先,公共节点的计数加一,如果有新节点插入FP树,在项头表对应的节点也与新节点进行连接);
[0137] 步骤4:通过项头表,递归挖掘频繁项集,并过滤掉不满足最小置信度min_conf的频繁项集,得出关联规则集合:
[0138]
[0139] 其中,rulesT表示挖掘出的标签关联规则集合,d表示挖掘到的关联规则总数,Ri表示第i个关联规则和该规则的置信度;
[0140] 步骤7:根据从Ltrain中挖掘出来的标签关联规则集合rulesT,对前z个推荐指标最大的待推荐标签集合RecT中的标签进行重排序,然后选择前A个标签作为目标歌单最终的推荐结果。
[0141] 具体过程如下:
[0142] 步骤7.1:根据关联规则所表现出的标签之间隐性联系,对待推荐标签集RecT做标签推荐指标 重排序,计算公式如下:
[0143]
[0144] 步骤7.2:最后根据标签推荐指标 的结果对待推荐标签集RecT再次进行从高到低排序,选择前A个标签作为目标歌单最终的标签推荐结果。
[0145] 本发明首先将抓取到的网易云音乐歌单数据按1∶9的比例分为测试集歌单Ltest和训练集歌单Ltrain。使用Ltrain中的歌单集计算出Ltrain每个歌单的标签相关度权值,然后将Ltrain歌单数据进行降维,并进行分桶优化。对Ltest中的目标歌单进行初始标签推荐,最后使用标签的关联规则对标签初始推荐结果进行重排,得到更准确的标签推荐结果,从而实现大规模歌单数据的快速、精准标签推荐。
[0146] 本发明从歌单数据的规模庞大,高维稀疏且标签分布不均匀等特点出发,将数据的多维信息以及歌单标签组合的分布信息结合起来,通过引入FP‑Growth关联规则算法以及基于歌单标签组合频率和逆标签频率的歌单相关度权值计算,以此来提升标签推荐的准确性。通过在协同过滤算法中引入基于Min‑Hash的局部敏感哈希算法,极大地提高了相似歌单的检索效率,降低模型的推荐用时。因此,相较于基于传统协同过滤方法的歌单标签推荐模型,本文提出的标签推荐模型的推荐准确性有较大的提升,且得益于推荐模型较低的计算复杂度,使其实现了歌单标签推荐实时性目标。值得注意的是,相比于基于深度学习算法的推荐模型,本发明所提方法与当前在线音乐平台所采用的基于协同过滤算法的推荐模型具有更好的兼容性,升级系统推荐算法的成本和风险更低。
[0147] 下面为具体实施例。
[0148] 实施例1
[0149] 表1实验数据集
[0150]
[0151] 参见图1中(a)与(b)以及图2中的(a)和(b),本发明首先从网易云音乐平台上抓取了10万歌单数据,共有73种不同的标签Tag,有16449种不同的歌单标签组合LTag,并如表1所示,将全量歌单数据按照1∶9的比例分为测试集歌单Ltest和训练集歌单Ltrain。通过对歌单数据集中的标签进行探索发现欧美、流行等标签在整个数据集中具有极大的使用率,而游戏、粤语等这类标签使用率却很低,表现出每种标签在歌单中出现的数量占比具有较大的倾斜性,而不同歌单标签组合所拥有的歌单数量也呈现出很大的倾斜性。在这种情况下,若直接采用传统的协同过滤歌单标签推荐模型,会造成其推荐结果倾向于推荐热门标签的现象,出现即使在目标歌单与其他歌单的相似度就散的比较准确的情况下,其模型的推荐准确性反而不高。因此本发明考虑借鉴“标签频率决定权重”的思想对歌单中的标签组合权威性进行相关度量,通过歌单标签组合频率和逆标签频率来体现某一类标签对歌单类别的表达能力。
[0152] 具体包括以下步骤:
[0153] 步骤1:计算训练集Ltrain中每个歌单Li的标签组合在训练集Ltrain中出现的频率并且计算歌单Li中的标签ti单独出现在训练集Ltrain中的频率
[0154] 步骤2:通过歌单标签组合频率和逆标签频率来体现某一类标签对歌单类别的表达能力,其计算公式如下:
[0155]
[0156] 式中 表示歌单Li的初始权重,分子加1的目的是防止权重为负。具体的,假设对于两个拥有不同标签组合的歌单L1和L2,其歌单标签组合频率为 但L1中的标签相对热门,有 通过歌单初始权重计算公式可得 这样做的合理性在于,L1因为拥有热门标签的积极影响,才使得其歌单标签组合频率 与 相等,因此需要对热门标签的影响做一定的惩罚,得出较真实的歌单标签组合权重权威值。
[0157] 图3为本发明的歌单多标签推荐方法流程图,使用歌单权重初始化方式降低热门标签的影响;使用基于FP‑Growth的标签关联规则挖掘技术,获取标签高质量的深层隐含关系;通过Min‑Hash算法,将高维稀疏的歌单数据映射为低维稠密的歌单签名矩阵,然后在使用LSH算法对歌单进行相似度聚类,并且将其与协同过滤方法结合,从而使其更迅速、更准确的进行歌单标签推荐任务,具体包括以下步骤:
[0158] 步骤1:首先,通过歌单标签组合频率和逆标签频率对歌单标签权重做初始化,将歌单标签相关度权值 引入歌单相似度计算中,用标签‑歌单的相关度来反映标签的概率分布。 越大,表示歌单Li中的标签组合权威性越高,反之, 越小,则歌单Li中的标签组合权威性越低。其计算公式如下:
[0159]
[0160] 步骤2:通过训练集Ltrain歌单数据集,使用Min‑Hash算法分别计算歌单‑歌曲、歌单‑歌手和用户‑歌单的签名矩阵,然后再使用LSH算法将每种签名矩阵中相似度高的歌单映射到对应的哈希桶中,根据这三种哈希桶实现快速检索出测试集Ltest中目标歌单的相似歌单备选集。其具体检索过程如下:
[0161] 1)首先采用Min‑Hash算法生成训练集Ltrain下三种数据集的签名矩阵,每种签名矩阵的计算方式相同,举例其歌单‑歌曲签名矩阵的计算过程如下:
[0162] 1.1将歌单Li中的歌曲ID映射为在歌曲总列表中的下标值,则歌单Li中的歌曲列表可表示为如下形式:
[0163]
[0164] 1.2产生k个不同的随机置换函数hi(x),置换函数中的参数ai和bi都是随机数,其值在[1,HASH_PRIME]之间,HASH_PRIME是一个大素数,其置换函数的表示如下:
[0165]
[0166] 1.3对歌单Li的歌曲列表 进行签名向量初始化,其签名向量的初始化形式为签名向量的更新策略是通过置换函数hk将签名向量中的每个参数更新为其最小值,更新完成的签名向量表示形式如下:
[0167]
[0168] 1.4重复步骤1.2、1.3,直至映射完所有歌单的签名向量,生成签名矩阵SM,其表示如下:
[0169]
[0170] 2)然后,如图4再对计算完成的签名矩阵SM做LSH分桶优化,具体过程可分三步:
[0171] 2.1将签名矩阵SM分为b段,每段由r行组成,其中b*r=k;
[0172] 2.2、将矩阵中每个签名向量的每段上都进行哈希分桶,能映射到同一个桶中的任意段都作为相似段,则这些段所对应的歌单认为是相似歌单;
[0173] 2.3、进行目标歌单的相似歌单集检索时,只需计算目标歌单的签名向量所能映射到的哈希桶,那么此桶中的歌单就作为目标歌单的相似歌单备选集。
[0174] 步骤3:通过测试集Ltest中目标歌单的相似歌单备选集Simset和歌单初始权重信息计算每个待推荐标签的推荐指标 其简化计算公式如下:
[0175]
[0176] 步骤4:选取前z个最大推荐指标的标签作为目标歌单的初始推荐推荐结果RecT,其表示如下:
[0177]
[0178] 步骤5:使用初始推荐结果RecT和通过FP‑Growth挖掘出的标签关联规则rulesT对待推荐标签作重排序,其重排序的计算方式为:
[0179]
[0180] 步骤6:最终,根据计算出的待推荐标签集RecT选择推荐指标 最大的前A个作为目标歌单的标签推荐结果。
[0181] 相比于传统的协同过滤推荐方法,本发明推荐准确率高,推荐速度快,并且可进行在线实时推荐,方法简单有效。
[0182] 图5所示为本发明提出的改进协同过滤多标签推荐方法(LSH)和传统协同过滤推荐方法(TRAD)在推荐准确率和推荐效率方面的比较。其推荐方法的效果评估是通过精确率precision和召回率recall计算F1值,使用F1值作为推荐结果的评价指标,以下是其定义:
[0183] 精确率:
[0184]
[0185] 其中,rec_true_num表示推荐正确的标签数,rec_tags_num表示推荐的标签数.精确率越高,则表示推荐正确的标签数占推荐的总标签数的比例越大。
[0186] 召回率:
[0187]
[0188] 其中,test_tags_num表示实际正确的标签数。召回率越高,则表示推荐正确的标签数占实际正确的总标签数的比例越大。
[0189] F1值:
[0190]
[0191] F1值作为对精确率precision和召回率recall的加权调和,其综合考虑了两者对模型准确性评价的影响,F1值越高,表示推荐模型的整体准确性越稳定,反之亦然。
[0192] 表2歌单在线推荐准确性对比结果
[0193]
[0194] 表3本发明在歌单在线实时推荐场景下的结果
[0195]
[0196] 表4为消融实验具体描述信息
[0197]
[0198] 表2和表3所示为本发明和传统协同过滤推荐方法在歌单在线实时推荐场景下的对比结果。表4以及图6‑图7所示是为了验证本发明的各项改进方法是否有效,在真实歌单数据上本发明与传统协同过滤方法在未使用或部分使用某项改进方式后的歌单多标签推荐的对比结果。参见表2‑表4以及图6‑图7,比较的结果说明了本发明所提出的各项改进方式都能极好的提升歌单标签推荐任务的效果,具有更好的推荐准确性和推荐实时性。
[0199] 在该发明中提出了:1)基于标签组合频率和逆标签频率的歌单相关度权值计算,2)基于LSH/Min‑Hash的协同过滤推荐方法,3)基于FP‑Growth的标签重排方法。主要解决了传统协同过滤方法在进行歌单标签推荐是存在推荐准确度低、计算复杂度高且无法对新创作的歌单进行实时在线推荐标签的问题。针对推荐效率和在线实时推荐问题,本发明提出了使用基于LSH/Min‑Hash的协同过滤歌单推荐方法,使其能根据目标歌单能快速检索出相似歌单备选集,实现了相似歌单的快速查询,在降低算法计算复杂度的同时也支持对新制作歌单的标签在线推荐。针对推荐的准确度提升问题,本发明通过歌单标签组合频率和逆标签频率计算歌单相关度权值,然后使用加权融合策略计算标签待推荐指数,最后再利用计算出的标签关联规则对候选标签组合进行标签重排得到最终的推荐标签。基于网易云音乐真实歌单数据的实验结果表明,该发明在经过权重及关联规则优化后的推荐结果,其推荐评价指标F1值比传统的协同过滤方法有较大幅度提升,且平均运行时间相较于传统协同过滤方法有了极大的改善。
[0200] 一种歌单多标签推荐系统,包括:
[0201] 哈希桶计算模块,用于将歌单数据分为测试集和训练集,将训练集中的歌曲信息、歌手信息和用户信息分别采用局部敏感哈希算法计算歌曲信息哈希桶、歌手信息哈希桶和用户信息哈希桶;
[0202] 哈希映射模块,用于采用局部敏感哈希算法对测试集中的歌曲、歌手和用户信息分别根据歌曲信息哈希桶、歌手信息哈希桶和用户信息哈希桶进行哈希映射,得出相似歌单备选集;
[0203] 初始待推荐标签集计算模块,用于根据相似歌单备选集和每个歌单的标签相关度权值计算初始待推荐标签集;
[0204] 标签重排序模块,用于通过FP‑Growth算法对根据训练集中的歌单标签集挖掘,得到标签的关联规则集合,根据标签的关联规则集合对初始待推荐标签集进行标签重排序,选择排序靠前的前A个标签进行推荐,实现歌单推荐。
[0205] 一种计算机设备,所述计算机设备包括存储器和处理器,所述存储器上存储有能在所述处理器上运行的计算机程序,所述计算机程序被所述处理器执行时实现如权利要求1至7中任一项所述的歌单多标签推荐方法。
[0206] 一种计算机可读存储介质,所述计算机可读存储介质存储有计算机程序,所述计算机程序当被处理器执行时使所述处理器执行如权利要求1至7中任一项所述的歌单多标签推荐方法。
[0207] 为使本发明实施例的目的、技术方案和优点更加清楚,下面将结合本发明实施例中的附图,对本发明实施例中的技术方案进行清楚、完整地描述,显然,所描述的实施例是本发明一部分实施例,而不是全部的实施例。基于本发明中的实施例,本领域普通技术人员在没有做出创造性劳动前提下所获得的所有其他实施例,都属于本发明保护的范围。
[0208] 需要说明的是,在不冲突的情况下,本申请中的实施例及实施例中的特征可以相互组合。
[0209] 本发明可以在由计算机执行的计算机可执行指令的一般上下文中描述,例如程序模块。一般地,程序模块包括执行特定任务或实现特定抽象数据类型的例程、程序、对象、元件、数据结构等等。也可以在分布式计算环境中实践本发明,在这些分布式计算环境中,由通过通信网络而被连接的远程处理设备来执行任务。在分布式计算环境中,程序模块可以位于包括存储设备在内的本地和远程计算机存储介质中。
[0210] 在本发明中,“模块”、“装置”、“系统”等指应用于计算机的相关实体,如硬件、硬件和软件的组合、软件或执行中的软件等。详细地说,例如,元件可以、但不限于是运行于处理器的过程、处理器、对象、可执行元件、执行线程、程序和/或计算机。还有,运行于服务器上的应用程序或脚本程序、服务器都可以是元件。一个或多个元件可在执行的过程和/或线程中,并且元件可以在一台计算机上本地化和/或分布在两台或多台计算机之间,并可以由各种计算机可读介质运行。元件还可以根据具有一个或多个数据包的信号,例如,来自一个与本地系统、分布式系统中另一元件交互的,和/或在因特网的网络通过信号与其它系统交互的数据的信号通过本地和/或远程过程来进行通信。
[0211] 最后,还需要说明的是,在本文中,诸如第一和第二等之类的关系术语仅仅用来将一个实体或者操作与另一个实体或操作区分开来,而不一定要求或者暗示这些实体或操作之间存在任何这种实际的关系或者顺序。而且,术语“包括”、“包含”,不仅包括那些要素,而且还包括没有明确列出的其他要素,或者是还包括为这种过程、方法、物品或者设备所固有的要素。在没有更多限制的情况下,由语句“包括……”限定的要素,并不排除在包括所述要素的过程、方法、物品或者设备中还存在另外的相同要素。
[0212] 本领域内的技术人员应明白,本发明的实施例可提供为方法、系统、或计算机程序产品。因此,本发明可采用完全硬件实施例、完全软件实施例、或结合软件和硬件方面的实施例的形式。而且,本发明可采用在一个或多个其中包含有计算机可用程序代码的计算机可用存储介质(包括但不限于磁盘存储器、CD‑ROM、光学存储器等)上实施的计算机程序产品的形式。
[0213] 本发明是参照根据本发明实施例的方法、设备(系统)、和计算机程序产品的流程图和/或方框图来描述的。应理解可由计算机程序指令实现流程图和/或方框图中的每一流程和/或方框、以及流程图和/或方框图中的流程和/或方框的结合。可提供这些计算机程序指令到通用计算机、专用计算机、嵌入式处理机或其他可编程数据处理设备的处理器以产生一个机器,使得通过计算机或其他可编程数据处理设备的处理器执行的指令产生用于实现在流程图一个流程或多个流程和/或方框图一个方框或多个方框中指定的功能的装置。
[0214] 这些计算机程序指令也可存储在能引导计算机或其他可编程数据处理设备以特定方式工作的计算机可读存储器中,使得存储在该计算机可读存储器中的指令产生包括指令装置的制造品,该指令装置实现在流程图一个流程或多个流程和/或方框图一个方框或多个方框中指定的功能。
[0215] 这些计算机程序指令也可装载到计算机或其他可编程数据处理设备上,使得在计算机或其他可编程设备上执行一系列操作步骤以产生计算机实现的处理,从而在计算机或其他可编程设备上执行的指令提供用于实现在流程图一个流程或多个流程和/或方框图一个方框或多个方框中指定的功能的步骤。
[0216] 最后应当说明的是:以上实施例仅用以说明本发明的技术方案而非对其限制,尽管参照上述实施例对本发明进行了详细的说明,所属领域的普通技术人员应当理解:依然可以对本发明的具体实施方式进行修改或者等同替换,而未脱离本发明精神和范围的任何修改或者等同替换,其均应涵盖在本发明的权利要求保护范围之内。
专利地区:陕西
专利申请日期:2021-03-24
专利公开日期:2023-01-03
专利公告号:CN113220931B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




