 产学研创新服务平台(全国)


一种基于动态进化计算的侵入式脑机接口自适应解码方法
更新时间:2026-10-28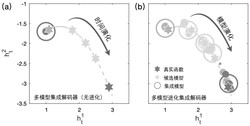 专利申请类型:发明专利;
地区:浙江-杭州;
源自:杭州高价值专利检索信息库;
专利名称:一种基于动态进化计算的侵入式脑机接口自适应解码方法
专利类型:发明专利
专利申请号:CN202211301943.9
专利申请(专利权)人:浙江大学
权利人地址:浙江省杭州市西湖区余杭塘路866号
专利发明(设计)人:祁玉,祝歆韵,王跃明
专利摘要:本发明公开了一种基于动态进化计算的侵入式脑机接口自适应解码方法,在训练过程中首先初始化一系列线性模型,并在脑机接口系统测试解码过程中,根据数据情况自动切换线性模型,在适当时刻根据近期神经信号自主进化模型,实现模型池的权重和参数自适应变化,进而完成脑信号动态解码。通过上述自主进化多模型,并分时集成的策略,能够融合刻画不同特征线性解码器的能力,提高运动脑机接口系统的准确性和稳定性,在一定程度上解决了脑机接口系统因神经信号非稳态性造成的解码性能不稳定问题。
主权利要求:一种基于动态进化计算的侵入式脑机接口自适应解码方法
技术领域
[0001] 本发明涉及脑机接口、神经信号解码领域,尤其是涉及一种基于动态进化计算的侵入式脑机接口自适应解码方法。
背景技术
[0002] 脑机接口横跨神经科学、认知科学、计算机科学、控制及信息科学与技术、医学等众多学科领域,现已逐步成为具有变革性影响的前沿交叉研究方向,对于人类与社会具有重大研究意义。
[0003] 侵入式运动脑机接口,借助植入在大脑运动皮层中的微电极阵列采集神经信号,并将其解码成运动信号,旨在于大脑和外部设备之间建立一条直接的神经信息交流与控制通道。该技术有望通过神经信号控制外骨骼与电脑光标等设备,恢复瘫痪病人的部分运动功能。
[0004] 在侵入式运动脑机接口系统中,神经解码算法至关重要。研究人员提出了许多从神经信号中解码运动信息的算法,包括集群向量法、最佳线性估计法、递归贝叶斯解码器和深度神经网络等。
[0005] 在这些方法中,卡尔曼滤波器结合了轨迹的变化过程,将其作为先验知识,以获得更准确的预测,因此被广泛应用于在线光标解码和外骨骼控制中,达到最优在线控制性能。
[0006] 当前的侵入式运动脑机接口使用的解码器大多假设神经信号和运动之间有稳定的函数关系,因此使用一个固定的解码模型。然而,在线解码过程中,采集的神经信号偶尔会引入噪声或者干脆消失;同时,由于神经元具有可塑性,大脑活动模式会随时间或不同行为状态发生改变。上述噪声和改变的存在,使得神经信号到运动信号的映射函数不稳定并且随时间持续变化。固定的解码函数会导致不稳定、不准确的解码结果,因此需要每隔一段时间重新训练以维持一定的性能。
[0007] 针对神经信号不稳定性问题提出的解码器可以被分为两类。第一类仍然使用固定模型,依赖于周期性地重新训练或在线逐步更新模型参数维持性能。第二类使用动态模型追踪神经信号的变化,这可以避免重新训练的代价,更适合长期解码任务。但是,这一类方法中,很少有研究直接对神经信号的不稳定性进行建模。有研究使用多模型动态集成的方式,尝试直接建模神经信号的非稳态性,但是其候选模型池一旦生成之后即固定,模型本身无法在测试阶段随神经信号的变化而变化。
[0008] 因此,如何构建一个有效的可进化的候选模型池,并通过多模型集成建模神经信号的动态性,以得到稳定鲁棒的解码性能,是当前运动神经解码领域亟待解决的重要问题。
发明内容
[0009] 本发明提供了一种基于动态进化计算的侵入式脑机接口自适应解码方法,可以大大降低神经信号不稳定性对解码性能的影响,提高了解码器的鲁棒性。
[0010] 一种基于动态进化计算的侵入式脑机接口自适应解码方法,包括如下步骤:
[0011] (1)获取原始运动神经信号,进行预处理后按比例分成训练集、验证集和测试集;
[0012] (2)初始化模型池,具体包括:设定模型池中模型的个数以及每个模型分配数据占全部数据的比例;根据设定分配数据的比例,按顺序切割训练集后依次分配给各个模型;对于每个模型,使用被分配到的训练样本学习线性模型,并用验证集进行评估,训练完的模型作为模型池中的候选模型;
[0013] (3)使用上述构建的多个候选模型动态表征状态变量与观测变量之间的关系;其中,状态变量为运动信号,观测变量为神经信号;
[0014] (4)根据贝叶斯模型平均法则动态组合模型池中的候选模型,作为状态空间模型的观测函数;
[0015] (5)应用过程中,利用构建的状态空间模型对待解码的神经信号进行状态估计,估计不同候选模型对应的状态并进行集成,得到解码后的运动信号;
[0016] 其中,解码过程中,当某一时刻达到模型池更新条件时,使用进化计算更新模型池,具体如下:
[0017] (5‑1)根据贝叶斯多模型集成框架中的模型似然确定进化计算中每个模型的适应度值;
[0018] (5‑2)根据适应度值选出最佳模型,对于模型池中的每个模型使用差分进化算法,通过变异、交叉、选择迭代操作,向最佳模型进化,直到适应度值变化小于一个阈值,模型池更新结束。
[0019] 本发明通过数据驱动的方式,使用差分进化算法,自主更新模型池中模型的参数,并使用这些模型替换卡尔曼滤波器中的观测函数,以实现在线动态集成解码器,来更好地适应神经信号的变化。在解码过程中,根据贝叶斯更新机制,自动选择和结合这些模型,从而大大降低了神经信号不稳定性对解码性能的影响,提高了解码器的鲁棒性。
[0020] 步骤(1)中,预处理过程为:从硬件设备中获取原始运动神经信号,选择适合的窗口大小计算神经信号发放率,依据状态标签截取有效数据段,对数据进行标准化和平滑操作,得到经过预处理的运动神经信号。
[0021] 作为优选,可去除范式准备与返回阶段的数据,选择实际操作阶段进行分析。
[0022] 作为优选,标准化和平滑操作,可采用Matlab中z‑score函数和movmean函数,对运动信号的每一个维度进行标准化和平滑操作,对神经信号的每一个神经元的发放频率进行平滑,具体平滑窗口大小可根据实际需求选择。
[0023] 作为优选,步骤(1)中数据的划分,可以按照6:2:2的比例分为训练集、验证集和测试集。
[0024] 步骤(2)中,模型池初始设定如下:
[0025] 设定模型池中模型的个数为M,则模型池内任意一个模型表示为
[0026] 设定每个模型分配数据占全部训练数据的比例为rseg,训练集的时间长度是lall;按顺序切割训练集为训练子集,依次分配给各模型,则每个模型被分配到的训练数据子集的时间长度为lseg=lall·rseg;每个训练子集的切割窗口均匀分布在训练时间点上,前后窗口的间隔为 因此,第i个训练子集的下标范围从(i‑1)·lstride+
1到min{lall,(i‑1)·lstride+lseg}。
[0027] 根据下标切割训练数据子集,得到每个模型对应的神经信号和运动信号其中 , 表 示模 型 所分 配到的 运 动数据 ;表示模型 所分配到的神经数据,dx和dy分别表示运动数据和神经数
据的特征维度; 表示模型 所分配到的运动数据的时间长度。
[0028] 根据分配的数据,使用最小二乘法拟合出线性模型:
[0029]
[0030] 其中, 为运动数据矩阵,比 多出一维代表偏置项; 为线性映射矩阵,此处即代表第m个线性模型, 表示独立同
分布的观测噪声。
[0031] 步骤(3)中,构建的多个候选模型动态表征状态变量与观测变量之间的关系如下:
[0032] xk=f(xk‑1)+vk‑1
[0033] yk=hk(xk)+nk
[0034] 其中,k表示离散的时间步长; 表示运动数据,即状态变量; 表示神经数据,即观测变量;vk、nk表示独立同分布的状态转移噪声和观测噪声;
表示k时刻的观测函数由模型池中的模型集成得到,αk,m表示
每个模型的集成权重。
[0035] 步骤(4)中,所述贝叶斯模型平均法则的状态估计如下:
[0036]
[0037] 式中, 是第k时刻选择第m个模型时,状态的后验概率;是第k时刻选择第m个模型的后验概率,计算公式如下:
[0038]
[0039] 其中, 为第k时刻选择第m个模型的先验概率;pm(yk|y0:k‑1)为第k时刻选择第m个模型的边缘似然。
[0040] 第k时刻选择第m个模型的先验概率计算公式如下:
[0041]
[0042] 其中, 为第k‑1时刻选择第m个模型的概率;α为遗忘因子,0<α<1。
[0043] 第k时刻选择第m个模型的边缘似然计算公式如下:
[0044] pm(yk|y0:k‑1)=∫pm(yk|xk)p(xk|y0:k‑1)dxk
[0045] 其中,pm(yk|xk)是第m个模型关于运动参数xk的似然函数。
[0046] 步骤 (5)中 ,所述状态估 计采用粒子滤波 算法,基于粒子计 算和
[0047] 基 于 粒 子 滤 波 的 首 先 ,从 状 态 转 移 先 验中获得 然后根据重要性采样原则,可得:
[0048]
[0049] 其中, 代表当选择第m个模型时,第i个粒子归一化后的重要性权重。
[0050] 基于粒子滤波的 给定 首先使用遗忘因子计算 的先验概率。在似然pm(yk|y0:k‑1),m=1,...,M已知的情况下,可计算的后验概率 在所述步骤(3)中,状态转移先验被用作重要性
函数,即q(xk|xk‑1,y0:k)=p(xk|xk‑1)。因此,xk的分布可由粒子近似得到,即进而可得:
[0051]
[0052] 值得注意的是,粒子滤波通常有粒子退化问题,经过几次迭代后,只有少量粒子具有较高的权重。因此,采用重采样方法去除权重过小或过大的粒子来减轻粒子退化问题。
[0053] 步骤(5‑1)的具体过程为:
[0054] 各模型的似然由粒子滤波中各粒子 的似然 加和得到:
[0055]
[0056] 其中,pm(yk|y0:k‑1)为各模型的似然, 为粒子,Ns为粒子个数, 为第m个模型的第i个粒子的似然;
[0057] 在模型池进化中,将模型池作为种群,将各模型(即线性映射矩阵)拉成一维向量 作为个体,则第k时刻种群中第m个个体
的适应度值为:
[0058]
[0059] 其中,lpre是最近时间窗口的长度。注意,神经解码是一个时序问题,我们不会在每一个时刻更新模型池。因此,我们通常积累最近时刻的一些数据来更新进化模型。
[0060] 步骤(5‑2)的具体过程为:
[0061] 现已 有初 始 化 种群其中G代表差分进化的迭代轮次;
[0062] 第G轮变异操作后的种群 由父种群 根据特定变异策略得到:
[0063]
[0064] 其中, 是从种群前100*p%的个体中随机选择的,p∈[0.05,0.2]; 和是从[1,M]中随机选择的模型下标,它们互不相等且不与当前模型下标m相等;F是一个变异因子列表, 是从外部存储模型池中随机选择的。
[0065] 作为优选,在每一个差分进化迭代轮次G中的选择过程中,每一个经过变异和较差的个体如果适应度值小于原始个体,将不会被选入下一轮迭代,将这些不好的个体加入外部存储模型池A中作为后续变异过程的候选模型,假设当前种群为P,则 是从集合A∪P中随机选择的。
[0066] 作为优选,在每一个差分进化迭代轮次G中,变异因子列表F将从一个柯西分布中产生:F=randc(μF,0.1),其中μF是初始变异因子,0.1是缩放参数。当产生的数值大于1时设为1,小于0时设为0。当这一轮迭代结束后,该列表将根据成功的变异因子SF更新:μF=(1‑c)·μF+c·meanL(SF),其中,c∈(0,1]是一个比例参数用来控制当前迭代轮次的效应,meanL(SF)代表Lehmer均值:
[0067] 交叉操作通过从父种群或者变异后种群的每一维随机选择一个分量产生交叉后种群;交叉后的个体是一个D维向量 该向量的每一个分量为:
[0068]
[0069] 其中,jrand是从[1,D]中选择的随机数,CR是一个交叉因子列表。
[0070] 作为优选,在每一个差分进化迭代轮次G中,交叉因子列表F将从一个高斯分布中产生:CR=rand(μCR,0.1),其中μCR是初始交叉因子,0.1是缩放参数。当产生的数值大于1时设为1,小于0时设为0。当这一轮迭代结束后,该列表将根据成功的交叉因子SCR更新:μCR=(1‑c)·μCR+c·meanA(SCR),其中,c∈(0,1]是一个比例参数用来控制当前迭代轮次的效应,meanA(SCR)代表算术均值。
[0071] 在选择操作阶段,由适应度函数f(·)决定一个个体是否留在新的种群中:
[0072]
[0073] 一次模型池进化过程将会迭代几十到几百轮,模型池中的每个模型通过变异、交叉、选择的迭代操作,直到最大迭代次数Gmax或者适应度值变化小于一个阈值,模型池更新结束。
[0074] 模型池更新过程中,采用变则进化和历史模型池的策略来决定何时更新及如何更新模型池,具体如下:
[0075] 默认设置是固定时间间隔tup更新模型池,然而,过大的时间间隔可能会导致更新不及时,过小的时间间隔可能会产生很多不必要的更新。因此,变则进化策略根据模型似然自适应选择更新时间,该策略将维护一个对数似然列表Lmax‑ever,其中存放了每个时刻所有候选模型中的最大对数似然;每当一个新的神经信号进入解码器,将会平均该列表中最后三个对数似然,作为当前时刻的对数似然lcur,同时平均最后三个对数似然前的三个对数似然,作为前一时刻的对数似然lpre;因此,模型池将会在lcur<rup·lpre时更新,其中,rup∈[0,1]是引入的更新系数。
[0076] 默认设置是用差分进化后的全部个体更新模型池。但是,差分进化倾向于将所有模型往最佳模型进化,使得模型池缺乏多样性,不足以刻画神经信号的时变性。因此,历史模型池策略建立一个历史模型池 来存储每一时刻的最优模型,该历史模型池大小与主模型池大小相等;当差分进化的迭代结束,该方法将在历史模型池中随机选择模型,替换进化后模型池中的部分模型;保留比例参数rpre用来控制多少历史模型会被保留在主模型池中:Mpre=rpre·M;因此,最后更新后的模型池为:其中,his
代表该模型源自历史模型池, 代表Mpre个随机下标,用于选择哪些历史模型
池会被保留在主模型池中。
[0077] 本发明基于传统状态空间模型以及粒子滤波,提出了一种基于多模型进化集成的动态自适应脑机接口解码方法应用于神经信号解码,在一定程度上减少了因神经信号不稳定性带来的影响。在测试中优于卡尔曼滤波算法,证明了该方法的有效性。
附图说明
[0078] 图1为本发明采用的方法在仿真数据上的函数追踪轨迹与多模型集成方法(无进化)的对比;
[0079] 图2为本发明采用的方法中“变则更新”策略的有效性结果图;
[0080] 图3为本发明采用的方法在猴子数据集和临床数据集上的解码性能与其他方法的对比图。
具体实施方式
[0081] 下面结合附图和实施例对本发明做进一步详细描述,需要指出的是,以下所述实施例旨在便于对本发明的理解,而对其不起任何限定作用。
[0082] 本研究采用多个数据集,包括一个仿真数据集,一个猴子数据集及一个临床数据集。本研究中所有临床和实验程序均经过浙江大学第二附属医院医学伦理委员会批准(伦理审查号2019‑158)。知情同意书由参与者及其直系亲属口头获得,并由其法定代表人签署。志愿者是一名72岁的男性,三年前发生车祸,在C4级颈椎外伤后四肢瘫痪。志愿者只能移动自己脖子以上的部位,并且具有正常的语言能力和对所有任务的理解能力。对于肢体运动行为,患者的骨骼肌力量得分为0/5,完全丧失了肢体运动控制能力。
[0083] 志愿者的左侧初级运动皮层中植入了两个96通道的Utah皮质内微电极阵列(4毫米×4毫米,长1.4毫米的Utah阵列,BlackrockMicrosystems,盐湖城,美国犹他州),其中一个位于中央手结区,另一个位于2毫米之外。植入使用电子计算机断层扫描和功能性核磁共振图来指导植入。在植入过程中,参与者被要求进行手肘和肘部的屈曲、伸展运动,通过功能性核磁共振扫描确认运动皮层的激活区域。手术过程中使用机械臂辅助植入电极。在开始神经信号记录和BCI训练任务之前,参与者有一个星期的康复时间。
[0084] 参与者在每个工作日进行BCI训练任务,周末休息。每天的训练时间大约3个小时,包括准备信号记录,阻抗测试,锋电位分类和范式任务。一旦参与者感到疲倦或出现身体异常状况(例如发烧或尿路感染),实验停止。整个实验持续了半年,记录了12周的神经信号。
[0085] 2D光标控制任务在志愿者前方1.5米的计算机显示器上进行。该任务在屏幕的顶部,底部,左侧,右侧和四个角包含八个目标。目标可以按顺时针顺序或伪随机方式顺序显示。任务的相关参数可以在任务设置中配置,包括目标到屏幕中心的距离,目标球的直径,最大试验时间,到达阈值,最小停留时间和失败后的重复次数。对于每个实验trial,要求志愿者从屏幕中心控制一个蓝色光标球到达一个红色目标球。在一次成功的trial中,蓝色和红色球的中心之间的距离应小于预设的到达阈值,并且停留时间不得短于预设的停留时间。每个trial的最大时长设置为2到5秒。在试验结束时会给出听觉提示,以指示其成功与否。每个trial失败后最多进行4次尝试。默认设置是在距屏幕中心15厘米处显示目标球,直径为5厘米。
[0086] 本发明提供了一种基于动态进化计算的侵入式脑机接口自适应解码方法,通过数据驱动的方式,使用差分进化算法,自主更新模型池中模型的参数,并使用这些模型替换卡尔曼滤波器中的观测函数,以实现在线动态集成解码器,来更好地适应神经信号的变化。在解码过程中,根据贝叶斯更新机制,自动选择和结合这些模型,从而大大降低了神经信号不稳定性对解码性能的影响,提高了解码器的鲁棒性。
[0087] 一种基于动态进化计算的侵入式脑机接口自适应解码方法,包括以下步骤:
[0088] (1)运动神经信号预处理:从硬件设备中获取原始运动神经信号,选择适合的窗口大小计算神经信号发放率,依据状态标签截取有效数据段,对数据进行标准化和平滑操作,得到经过预处理的运动和神经信号;将数据按照合理的比例分成训练集、验证集、测试集。
[0089] 具体而言,实验使用Neuroport系统(NSP,BlackrockMicrosystems)记录神经信号。神经活动经过放大、数字化后,以30KHz的频率进行记录。使用Central软件包(BlackrockMicrosystem)将每个经过高通滤波(250Hz截止频率)的电极的神经动作电位检测的阈值分别设置为‑6.5RMS到‑5.5RMS。在每项日常任务开始时,研究人员会手动对锋电位进行分类,这大约需要25到35分钟。峰值活动被转换为20ms中的发放率,并使用具有450ms窗口的指数平滑函数进行低通滤波。
[0090] (2)模型池初始设定,具体包括:
[0091] 设定模型池中模型的个数为M,则模型池内任意一个模型表示为
[0092]
[0093] 设定每个模型分配数据占全部训练数据的比例为rseg,训练数据集的时间长度是lall。现按顺序切割训练集为训练子集,依次分配给各模型,则每个模型被分配到的训练数据子集的时间长度为lseg=lall·rseg。每个训练子集的切割窗口均匀分布在训练时间点上,前后窗口的间隔为 因此,第i个训练子集的下标范围从(i‑1)·lstride+1到min{lall,(i‑1)·lstride+lseg}。
[0094] 根据下标切割训练数据子集,得到每个模型对应的神经信号和运动信号其 中 , 表示 模型 所 分配到 的运 动数据 ,表示模型 所分配到的神经数据,dx和dy分别表示运动数据和神经数
据的特征维度。
[0095] 根据分配的数据,使用最小二乘法拟合出线性模型:
[0096]
[0097] 其中, 为运动数据矩阵,比 多出一维代表偏置项。 为线性映射矩阵(此处即代表第m个线性模型), 表示独立
同分布的观测噪声。
[0098] 在本实例仿真数据中,模型的个数为M设置为50,每个模型分配数据占全部训练数据比例rseg设置为0.1,运动数据维度dx为1,神经数据维度dy为2,训练集时间长度lall为650。
[0099] 在本实例猴子数据中,模型的个数为M设置为20,每个模型分配数据占全部训练数据比例rseg设置为0.5,运动数据维度dx为2,神经数据维度dy为20,训练集时间长度lall为650。
[0100] 在本实例临床数据中,模型的个数为M设置为20,每个模型分配数据占全部训练数据比例rseg设置为0.5,运动数据维度dx为2,神经数据维度dy为20,训练集时间长度lall为600。
[0101] (3)基于动态集成的状态空间模型:
[0102] (3‑1)构建的多个候选模型动态表征状态变量与观测变量之间的关系如下:
[0103] xk=f(xk‑1)+vk‑1
[0104] yk=hk(xk)+nk
[0105] 其中,k表示离散的时间步长; 表示运动数据,即状态变量; 表示神经数据,即观测变量;vk、nk表示独立同分布的状态转移噪声和观测噪声;
表示k时刻的观测函数由模型池中的模型集成得到,αk,m表示
每个模型的集成权重。
[0106] (3‑2)贝叶斯模型平均法则的状态估计如下:
[0107]
[0108] 式中, 是第k时刻选择第m个模型时,状态的后验概率;是第k时刻选择第m个模型的后验概率,计算公式如下:
[0109]
[0110] 其中, 为第k时刻选择第m个模型的先验概率;pm(yk|y0:k‑1)为第k时刻选择第m个模型的边缘似然。
[0111] 第k时刻选择第m个模型的先验概率计算公式如下:
[0112]
[0113] 其中, 为第k‑1时刻选择第m个模型的概率;α为遗忘因子,0<α<1。
[0114] 在本实例中,遗忘因子设置从0.1~0.9不等。当遗忘因子设为0.9时,极大程度上考虑了前向时刻运动状态的影响,因此使得解码出的运动状态更加平滑。
[0115] 第k时刻选择第m个模型的边缘似然计算公式如下:
[0116] pm(yk|yo:k‑1)=∫pm(yk|xk)p(xk|y0:k‑1)dxk
[0117] 其中,pm(yk|xk)是第m个模型关于运动参数xk的似然函数。
[0118] (3‑3)所述状态估计采用粒子滤波算法,基于粒子计算 和
[0119] (3‑3‑1)基于粒子滤波的 首先,从状态转移先验中获得 然后根据重要性采样原则,可得:
[0120]
[0121] 其中, 代表当选择第m个模型时,第i个粒子归一化后的重要性权重。
[0122] 本实例中,采用训练集作为粒子集,避免了随机撒粒子带来的不稳定性。
[0123] (3‑3‑2)基于粒子滤波的 给定 首先使用步骤(6‑2)中遗忘因子计算 的先验概率。在似然pm(yk|y0:k‑1),m=1,...,M已知的情况下,可计算 的后验概率 在所述步骤(3‑1)中,状态
转移先验被用作重要性函数,即q(xk|xk‑1,y0:k)=p(xk|xk‑1)。因此,xk的分布可由粒子近似得到,即 进而可得:
[0124]
[0125] 值得注意的是,粒子滤波通常有粒子退化问题,经过几次迭代后,只有少量粒子具有较高的权重。因此,采用重采样方法去除权重过小或过大的粒子来减轻粒子退化问题。
[0126] (4‑1)根据贝叶斯多模型集成框架中的模型似然确定进化计算中每个模型的适应度值,方法如下:
[0127] 各模型的似然由粒子滤波中各粒子 的似然 加和得到:
[0128]
[0129] 其中,pm(yk|y0:k‑1)为各模型的似然, 为粒子,Ns为粒子个数, 为第m个模型的第i个粒子的似然。
[0130] 在模型池进化中,将模型池作为种群,将各模型(即线性映射矩阵)拉成一维向量 作为个体。则第k时刻种群中第m个个体
的适应度值为:
[0131]
[0132] 其中,lpre是最近时间窗口的长度。注意,神经解码是一个时序问题,我们不会在每一个时刻更新模型池。因此,我们通常积累最近时刻的一些数据来更新进化模型。
[0133] (4‑2)根据适应度值选出最佳模型,对于模型池中的每个模型使用差分进化算法更新,方法如下:
[0134] 现已 有初 始 化 种群其中G代表差分进化的迭代轮次。
[0135] 第G轮“变异”操作后的种群 由父种群根据某一特定变异策略得到。为了避免差分进化中种群过早收敛问题,同时使种群更加多样化,此处采用带有外部存储的“DE/current‑to‑pbest/1”变异策略:
[0136]
[0137] 其中, 是从种群前100*p%的个体中随机选择的,通常p∈[0.05,0.2]。 和是从[1,M]中随机选择的模型下标,它们互不相等且不与当前模型下标m相等。F是一个变异因子列表, 是从外部存储模型池中随机选择的。
[0138] 在每一个差分进化迭代轮次G中的选择过程中,每一个经过变异和较差的个体如果适应度值小于原始个体,将不会被选入下一轮迭代,将这些不好的个体加入外部存储模型池A中作为后续变异过程的候选模型,假设当前种群为P,则 是从集合A∪P中随机选择的。
[0139] 在每一个差分进化迭代轮次G中,变异因子列表F将从一个柯西分布中产生:F=randc(μF,0.1),其中μF是初始变异因子,0.1是缩放参数。当产生的数值大于1时设为1,小于0时设为0。当这一轮迭代结束后,该列表将根据成功的变异因子SF更新:μF=(1‑c)·μF+c·meanL(SF),其中,c∈(0,1]是一个比例参数用来控制当前迭代轮次的效应,meanL(SF)代表Lehmer均值:
[0140] “交叉”操作通过从父种群或者变异后种群的每一维随机选择一个分量产生交叉后种群。交叉后的个体是一个D维向量 该向量的每一个分量为:
[0141]
[0142] 其中,jrand是从[1,D]中选择的随机数,CR是一个交叉因子列表。
[0143] 在每一个差分进化迭代轮次G中,交叉因子列表F将从一个高斯分布中产生:CR=rand(μCR,0.1),其中μCR是初始交叉因子,0.1是缩放参数。当产生的数值大于1时设为1,小于0时设为0。当这一轮迭代结束后,该列表将根据成功的交叉因子ScR更新:μCR=(1‑c)·μCR+c·meanA(SCR),其中,c∈(0,1]是一个比例参数用来控制当前迭代轮次的效应,meanA(SCR)代表算术均值。
[0144] 在“选择”操作阶段,由适应度函数f(·)决定一个个体是否留在新的种群中:
[0145]
[0146] 一次模型池进化过程将会迭代几十到几百轮,终止条件为达到最大迭代次数Gmax或者当适应度值连续若干轮下降不超过某个。
[0147] (4‑3)所述“变则进化”和“历史模型池”策略,方法如下:
[0148] 默认设置是固定时间间隔tup更新模型池,然而,过大的时间间隔可能会导致更新不及时,过小的时间间隔可能会产生很多不必要的更新。因此,“变则进化”策略根据模型似然自适应选择更新时间。该方法将维护一个对数似然列表Lmax‑ever,其中存放了每个时刻所有候选模型中的最大对数似然。每当一个新的神经信号进入解码器,该方法将会平均该列表中最后三个对数似然,作为当前时刻的对数似然lcur,同时平均最后三个对数似然前的三个对数似然,作为前一时刻的对数似然lpre。因此,模型池将会在lcur<rup·lpre时更新,其中,rup∈[0,1]是引入的更新系数。
[0149] 默认设置是用差分进化后的全部个体更新模型池。但是,差分进化倾向于将所有模型往最佳模型进化,使得模型池缺乏多样性,不足以刻画神经信号的时变性。因此,“历史模型池”策略建立一个历史模型池 来存储每一时刻的最优模型,该模型池大小与主模型池大小相等。当差分进化的迭代结束,该方法将在历史模型池中随机选择模型,替换进化后模型池中的部分模型。保留比例参数rpre用来控制多少历史模型会被保留在主模型池中:Mpre=rpre·M。因此,最后更新后的模型池为:
[0150] 在本实例仿真数据中,种群前100*p%中的p设置为0.1,用来控制当前迭代轮次效应的比例参数c设置为0.05,初始变异因子μF设置为0.1,初始交叉因子μCR设置为0.1。固定更新时间间隔tup设置为15,最大迭代次数Gmax设置为100,提前终止操作的间隔轮次设置为10轮。每次更新使用的历史数据长度lpre为30。“历史模型池”策略的保留比例rpre设置为
0.8。
[0151] 在本实例猴子数据中,种群前100*p%中的p设置为0.2,用来控制当前迭代轮次效应的比例参数c设置为0.05,初始变异因子μF设置为0.2,初始交叉因子μcR设置为0.1。固定更新时间间隔tup设置为15,最大迭代次数Gmax设置为300,提前终止操作的间隔轮次设置为20轮。每次更新使用的历史数据长度lpre为15。“历史模型池”策略的保留比例rpre设置为
0.5。
[0152] 在本实例临床数据中,种群前100*p%中的p设置为0.2,用来控制当前迭代轮次效应的比例参数c设置为0.05,初始变异因子μF设置为0.3,初始交叉因子μCR设置为0.1。固定更新时间间隔tup设置为15,“变则更新”策略的更新参数rup设置为0.4,最大迭代次数Gmax设置为300,提前终止操作的间隔轮次设置为20轮。每次更新使用的历史数据长度lpre为15。“历史模型池”策略的保留比例rpre设置为0.3。
[0153] (5)多模型进化集成方法的性能评估:在测试集数据中使用本方法与其他方法对比,评估本方法性能与有效性。
[0154] 本实例采用多个数据集,包括一个仿真数据集,一个猴子数据集及一个临床数据集。
[0155] 如图1所示,展示了在仿真数据集上,多模型进化集成解码器追踪真实函数变化的过程。相比与无进化的多模型集成解码器,本发明的多模型进化集成方法的函数拟合轨迹可以追踪得上真实函数的变化,证明了本方法的有效性。
[0156] 如图2所示,展示了在仿真数据集的四种场景下,使用与不使用“变则更新”策略的解码性能对比。四种场景分别为真实函数缓慢单调变化、快速单调变化、缓慢非单调变化、快速非单调变化。结果表明,四种情况下使用“变则更新策略”均可带来解码性能的提升,证明了“变则更新”策略的有效性。
[0157] 如图3所示,展示了在猴子数据集和临床数据集上,本发明的多模型进化集成方法解码性能与其他方法的对比图。可以看到在各个数据集上,本方法的解码性能均优于其他方法,如粒子滤波、卡尔曼滤波、重新练的卡尔曼滤波、无进化的多模型动态集成方法。证明了本方法的有效性。
[0158] 以上所述的实施例对本发明的技术方案和有益效果进行了详细说明,应理解的是以上所述仅为本发明的具体实施例,并不用于限制本发明,凡在本发明的原则范围内所做的任何修改、补充和等同替换,均应包含在本发明的保护范围之内。
专利地区:浙江
专利申请日期:2022-10-24
专利公开日期:2023-08-25
专利公告号:CN116187152B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




