产学研创新服务平台(全国)


一种基于生成对抗网络的主动声浪生成方法发明专利
更新时间:2026-11-01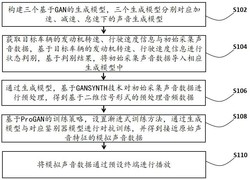 专利申请类型:发明专利;
地区:广东-广州;
源自:广州高价值专利检索信息库;
专利名称:一种基于生成对抗网络的主动声浪生成方法
专利类型:发明专利
专利申请号:CN202410078721.8
专利申请(专利权)人:广州市车厘子电子科技有限公司
权利人地址:广东省广州市花都区迎宾大道173号之十一501
专利发明(设计)人:秦先清,翟雁秋,何志辉
专利摘要:本发明公开了一种基于生成对抗网络的主动声浪生成方法,通过对抗训练的方式生成与真实声浪数据分布尽可能接近的声浪数据,本发明使用GANsynth来进行音频数据预处理,并结合了ProGAN和DCGAN的架构和训练策略,使其能够稳定的生成高质量声浪音频文件。
主权利要求:
1.一种基于生成对抗网络的主动声浪生成方法,其特征在于,包括:构建三个基于GAN的生成模型,三个生成模型分别对应加速、减速、怠速下的声音生成模型;
获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,基于判别结果,将初始采集声音数据导入相应生成模型中;
通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据;
基于ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据;
将模拟声音数据通过预设终端进行播放;
其中,所述获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,具体为:基于发动机转速、行驶速度信息与预设车辆行驶标准数据进行对比,并得到判别结果,判别结果为加速、减速、怠速中的其中一种;
其中,所述ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据,具体为:基于ProGAN训练策略,采用渐进式训练方法,在生成模型中设置7层,每层通道数设定为[(128,112),(112,96),(96,80),(80,64),(64,48),(48,32),(32,16)],对应的鉴别器模型每层通道数与生成模型相反;
将预处理音频数据导入生成模型,以类图像模式进行数据生成,通过对应的鉴别器对生成的数据进行鉴别,循环进行对抗训练,并基于渐进式训练方法逐步提高生成数据的分辨率;
通过训练后的生成模型进行数据生成与转化,得到模拟声音数据。
2.根据权利要求1所述的一种基于生成对抗网络的主动声浪生成方法,其特征在于,所述通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据,具体为:将初始采集声音数据进行分帧加窗处理,形成多个中间数据;
对所述中间数据进行短时傅里叶变换,得到变换声音数据;
将变换声音数据沿预设维度进行堆叠,并形成基于二维信号形式的预处理音频数据。
3.根据权利要求1所述的一种基于生成对抗网络的主动声浪生成方法,其特征在于,所述基于GAN的生成模型中,为采用DCGAN的方法构建,生成模型与对应的鉴别器模型均运用了深度卷积神经网络。
4.一种基于生成对抗网络的主动声浪生成系统,其特征在于,该系统包括:存储器、处理器,所述存储器中包括基于生成对抗网络的主动声浪生成程序,所述基于生成对抗网络的主动声浪生成程序被所述处理器执行时实现如下步骤:构建三个基于GAN的生成模型,三个生成模型分别对应加速、减速、怠速下的声音生成模型;
获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,基于判别结果,将初始采集声音数据导入相应生成模型中;
通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据;
基于ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据;
将模拟声音数据通过预设终端进行播放;
其中,所述获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,具体为:基于发动机转速、行驶速度信息与预设车辆行驶标准数据进行对比,并得到判别结果,判别结果为加速、减速、怠速中的其中一种;
其中,所述ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据,具体为:基于ProGAN训练策略,采用渐进式训练方法,在生成模型中设置7层,每层通道数设定为[(128,112),(112,96),(96,80),(80,64),(64,48),(48,32),(32,16)],对应的鉴别器模型每层通道数与生成模型相反;
将预处理音频数据导入生成模型,以类图像模式进行数据生成,通过对应的鉴别器对生成的数据进行鉴别,循环进行对抗训练,并基于渐进式训练方法逐步提高生成数据的分辨率;
通过训练后的生成模型进行数据生成与转化,得到模拟声音数据。 说明书 : 一种基于生成对抗网络的主动声浪生成方法技术领域[0001] 本发明涉及人工智能分析领域,更具体的,涉及一种基于生成对抗网络的主动声浪生成方法。背景技术[0002] 主动声浪技术正是解决电动汽车所面临问题的有效手段,它不仅能够提高电动汽车的安全性,还能增强驾驶体验,并帮助汽车厂商满足国家的相关标准和要求。[0003] 目前应用于主动声浪的实现方法主要是围绕着基于样本的方法和参数化的方法,但是基于样本的方法需要对真实汽车的引擎声样本进行录制、处理和合成。这种方法首先采集汽车在不同工况下的引擎声样本,在合成引擎声时,取出当前汽车的工况所对应的样本,再进行适当的调音处理,最后使用重叠相加法进行拼接。这种方法主要用于赛车游戏和高保真驾驶模拟器。它实现起来相对简单,但需要大量的汽车声音样本,而且声音设计受到真实汽车样本音色的限制。[0004] 而参数化的方法通常使用数学模型和算法来分析音频信号,并提取出关键的特征参数。然后,根据目标声浪风格的要求,调整这些参数来合成新的音频信号。如果参数设置不准确,那么结果可能会受到影响。此外,如果实际情况与预设参数不符,那么基于参数化的方法可能无法很好地适应这种变化。发明内容[0005] 本发明克服了现有技术的缺陷,提出了一种基于生成对抗网络的主动声浪生成方法。[0006] 相比较与传统的参数化方法和基于样本的方法,本文提出基于生成对抗网络的主动声浪生成方法具有明显的创新性,该方法能够学习到数据中的复杂分布和模式,从而生成更加自然和真实的声音;另外模型不需要在进行手动的调整大量的声学参数来模拟真实的声音,使得声音生成过程更加自动化和高效;最后模型通过学习真实数据的分布来生成新的数据,从而克服了样本数量上的限制;显然,本文提出的基于生成对抗网络的主动声浪生成方法,不仅突破了传统方法的局限,以更自然真实的方式生成声音,同时大大提高了声音生成过程的自动化和效率。[0007] 本发明第一方面提供了一种基于生成对抗网络的主动声浪生成方法,包括:[0008] 构建三个基于GAN的生成模型,三个生成模型分别对应加速、减速、怠速下的声音生成模型;[0009] 获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,基于判别结果,将初始采集声音数据导入相应生成模型中;[0010] 通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据;[0011] 基于ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据;[0012] 将模拟声音数据通过预设终端进行播放。[0013] 本方案中,所述获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,具体为:[0014] 基于发动机转速、行驶速度信息与预设车辆行驶标准数据进行对比,并得到判别结果,判别结果为加速、减速、怠速中的其中一种。[0015] 本方案中,所述通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据,具体为:[0016] 将初始采集声音数据进行分帧加窗处理,形成多个中间数据;[0017] 对所述中间数据进行短时傅里叶变换,得到变换声音数据;[0018] 将变换声音数据沿预设维度进行堆叠,并形成基于二维信号形式的预处理音频数据。[0019] 本方案中,所述ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据,具体为:[0020] 基于ProGAN训练策略,采用渐进式训练方法,在生成模型中设置7层,每层通道数设定为[(128,112),(112,96),(96,80),(80,64),(64,48),(48,32),(32,16)],对应的鉴别器模型每层通道数与生成模型相反;[0021] 将预处理音频数据导入生成模型,以类图像模式进行数据生成,通过对应的鉴别器对生成的数据进行鉴别,循环进行对抗训练,并基于渐进式训练方法逐步提高生成数据的分辨率;[0022] 通过训练后的生成模型进行数据生成与转化,得到模拟声音数据。[0023] 本方案中,所述基于GAN的生成模型中,为采用DCGAN的方法构建,生成模型与对应的鉴别器模型均运用了深度卷积神经网络。[0024] 本发明第二方面还提供了一种基于生成对抗网络的主动声浪生成系统,该系统包括:存储器、处理器,所述存储器中包括基于生成对抗网络的主动声浪生成程序,所述基于生成对抗网络的主动声浪生成程序被所述处理器执行时实现如下步骤:[0025] 构建三个基于GAN的生成模型,三个生成模型分别对应加速、减速、怠速下的声音生成模型;[0026] 获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,基于判别结果,将初始采集声音数据导入相应生成模型中;[0027] 通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据;[0028] 基于ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据;[0029] 将模拟声音数据通过预设终端进行播放。[0030] 本发明公开了一种基于生成对抗网络的主动声浪生成方法,通过对抗训练的方式生成与真实声浪数据分布尽可能接近的声浪数据,本发明使用GANsynth来进行音频数据预处理,并结合了ProGAN和DCGAN的架构和训练策略,使其能够稳定的生成高质量声浪音频文件。附图说明[0031] 图1示出了本发明一种基于生成对抗网络的主动声浪生成方法的流程图;[0032] 图2示出了本发明音频数据预处理流程图;[0033] 图3示出了本发明一种基于生成对抗网络的主动声浪生成系统的框图。具体实施方式[0034] 为了能够更清楚地理解本发明的上述目的、特征和优点,下面结合附图和具体实施方式对本发明进行进一步的详细描述。需要说明的是,在不冲突的情况下,本申请的实施例及实施例中的特征可以相互组合。[0035] 在下面的描述中阐述了很多具体细节以便于充分理解本发明,但是,本发明还可以采用其他不同于在此描述的其他方式来实施,因此,本发明的保护范围并不受下面公开的具体实施例的限制。[0036] 主动声浪,是一种先进的音频处理技术,专注于实时改变音频信号的风格,以适应不同的听音环境和用户偏好。与风格迁移在音乐、图像和视频等领域的应用相似,主动声浪技术旨在提供个性化的音频体验,满足用户多样化的需求。传统上实现主动声浪的方法主要是基于样本的方法和参数化方法:基于样本的方法依赖录制和处理真实的发动机声,对声音进行切片保存形成数据库,在实际行驶过程中在把声音片段进行拼接形成真实的发动机声音;基于参数化的方法则是分析音频信号的参数并调整参数来合成新的音频信号,但是这种方式需要靠预设的参数来进行调整音频信号,如果预设参数不准确将直接影响最后的声音结果。本文提出一种基于生成对抗网络的主动声浪算法,通过对抗训练的方式生成与真是声浪数据分布尽可能接近的声浪数据,这种方法使用GANsynth来进行音频数据预处理,并结合了ProGAN和DCGAN的架构和训练策略,使其能够稳定的生成高质量声浪音频文件。[0037] 相比较与传统的参数化方法和基于样本的方法,本文提出基于生成对抗网络的主动声浪生成方法具有明显的创新性,该方法能够学习到数据中的复杂分布和模式,从而生成更加自然和真实的声音;另外模型不需要在进行手动的调整大量的声学参数来模拟真实的声音,使得声音生成过程更加自动化和高效;最后模型通过学习真实数据的分布来生成新的数据,从而克服了样本数量上的限制;显然,本文提出的基于生成对抗网络的主动声浪生成方法,不仅突破了传统方法的局限,以更自然真实的方式生成声音,同时大大提高了声音生成过程的自动化和效率,以下是对该方法的详细介绍。[0038] 图1示出了本发明一种基于生成对抗网络的主动声浪生成方法的流程图。[0039] 如图1所示,本发明第一方面提供了一种基于生成对抗网络的主动声浪生成方法,包括:[0040] S102,构建三个基于GAN的生成模型,三个生成模型分别对应加速、减速、怠速下的声音生成模型;[0041] S104,获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,基于判别结果,将初始采集声音数据导入相应生成模型中;[0042] S106,通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据;[0043] S108,基于ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据;[0044] S110,将模拟声音数据通过预设终端进行播放。[0045] 需要说明的是,本发明通过对抗训练的方式生成与真实声浪数据分布尽可能接近的声浪数据。该算法根据车辆的发动机转速和行驶速度信息进行判别,并根据判别结果将初始化声音送入对应行驶状态(加速、减速、怠速)下的模型中,生成与行驶状态匹配的音频数据。生成的音频数据可用于直接播放,并向前反馈替换掉初始化声音。此外,本发明还可以根据下一状态下的判别器判别结果将音频数据送入对应的模型中继续生成声音。[0046] 根据本发明实施例,所述获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,具体为:[0047] 基于发动机转速、行驶速度信息与预设车辆行驶标准数据进行对比,并得到判别结果,判别结果为加速、减速、怠速中的其中一种。[0048] 需要说明的是,所述预设车辆行驶标准数据为用户设定数据,可以根据车辆型号进行更改。[0049] 根据本发明实施例,所述通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据,具体为:[0050] 将初始采集声音数据进行分帧加窗处理,形成多个中间数据;[0051] 对所述中间数据进行短时傅里叶变换,得到变换声音数据;[0052] 将变换声音数据沿预设维度进行堆叠,并形成基于二维信号形式的预处理音频数据。[0053] 需要说明的是,本发明中,GAN模型使用GANsynth来进行音频数据预处理,并结合了ProGAN和DCGAN的架构和训练策略,使其能够稳定的生成高质量声浪音频文件(即模拟声音数据)。[0054] 图2示出了本发明音频数据预处理流程图。[0055] 发动机声浪作为一种无条件声音,没有像语言声音一样的说话内容作为文本提示,也没有像音乐歌曲一样有音符或者节拍这样明显的特征可以直接进行学习,所以在对数据进行抓取的时候必须要进行针对性的预处理;本方法借鉴了图像处理方面的技术,将声音分帧加窗,再通过短时傅里叶变换(STFT),把每一帧的结果沿着一个维度堆叠起来,得到一个类似图片的二维信号形式数据。如图2所示,初始声音文件经过分帧形成多个中间数据,并进一步通过加窗与变换(做FT,傅里叶变换)形成下一处理操作后数据,将得到的数据进行堆叠则得到相应的图像形式数据。[0056] 根据本发明实施例,所述基于ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据,具体为:[0057] 基于ProGAN训练策略,采用渐进式训练方法,在生成模型中设置7层,每层通道数设定为[(128,112),(112,96),(96,80),(80,64),(64,48),(48,32),(32,16)],对应的鉴别器模型每层通道数与生成模型相反;[0058] 将预处理音频数据导入生成模型,以类图像模式进行数据生成,通过对应的鉴别器对生成的数据进行鉴别,循环进行对抗训练,并基于渐进式训练方法逐步提高生成数据的分辨率;[0059] 通过训练后的生成模型进行数据生成与转化,得到模拟声音数据。[0060] 需要说明的是,发动机声浪一类的无条件声音,因为其特征复杂和高纬度,使得模型在训练的时候很难适应,特征学习的情况会直接影响最终生成声音的质量,所以这里引入了ProGAN的训练策略。[0061] ProGAN的创新主要体现在渐进式增长的训练策略上,这种方法使模型从低分辨率的图像开始学习基础特征,随着训练的进程,逐步增加网络的深度和复杂性,以处理更高分辨率的图像。这种方法的引入有助于模型的稳定训练,避免了训练初期就面临大量的、难以区分的高维特征。[0062] 本发明渐进式训练共设立7层,生成器模型的每层通道数设定为[(128,112),(112,96),(96,80),(80,64),(64,48),(48,32),(32,16)],而鉴别器模型每层通道数与之相反。生成器通道数递减的设计可以提供更有效的训练和生成策略,特别是在需要生成高分辨率图像并采用渐进式增长的情况下。这种设计有助于平衡计算资源、多尺度特征表示和模型复杂性。而鉴别器通道数递增的设计主要有助于提高鉴别器的感知能力和适应性,尤其是在高分辨率图像鉴别任务中。这可以帮助鉴别器更好地执行其任务,从而提高生成对抗网络的性能和稳定性。[0063] 随着模型训练的进行,图像逐渐提高分辨率,这个过程被称为上采样。这意味着逐步增加图像的像素数量,以使其更加清晰和细致,尽可能地接近原始声音特征。[0064] 所述类图像模式即本发明通过将音频文件转化为图像数据文件(即基于二维信号形式的预处理音频数据),以图像数据形式,进行基于GAN的数据训练与对抗生成,从而得到较为精准的音频文件。训练后的生成模型生成的高分辨率图像数据通过音频格式转换,能够得到相应的声浪音频数据,即模拟声音数据。[0065] 根据本发明实施例,所述基于GAN的生成模型中,为采用DCGAN的方法构建,生成模型与对应的鉴别器模型均运用了深度卷积神经网络。[0066] 需要说明的是,DCGAN就是将CNN与GAN结合在一起,即生成器模型和判别器模型(即鉴别器模型)都运用了深度卷积神经网络的生成对抗网络,本发明所提出方法因为需要嵌入渐进式训练策略,所以与传统的DCGAN仍有不同:1、逐层增强的图像分辨率:本方法在生成器模型中引入逐层增强图像分辨率的设计,通过多次的上采样和反卷积操作,使生成的图像更加逼真和高分辨率;2、音频文件经过预处理后,使用复数表示幅值和相位信息来处理图片,以便生成的图像更加接近原始图像的特征;3、渐进式训练策略使模型在不同分辨率层次上逐渐学习图像特征,提高了生成质量。[0067] 通过本发明的主动声浪技术可以为电动汽车提供类似于传统燃油车的发动机声浪,增强驾驶的乐趣和真实感。在驾驶模拟器或赛车游戏中,为了提供更加真实的驾驶体验,本发明主动声浪技术可以被用于模拟各种车辆的发动机声音,增加玩家的沉浸感。[0068] 图3示出了本发明一种基于生成对抗网络的主动声浪生成系统的框图。[0069] 本发明第二方面还提供了一种基于生成对抗网络的主动声浪生成系统3,该系统包括:存储器31、处理器32,所述存储器中包括基于生成对抗网络的主动声浪生成程序,所述基于生成对抗网络的主动声浪生成程序被所述处理器执行时实现如下步骤:[0070] 构建三个基于GAN的生成模型,三个生成模型分别对应加速、减速、怠速下的声音生成模型;[0071] 获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,基于判别结果,将初始采集声音数据导入相应生成模型中;[0072] 通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据;[0073] 基于ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据;[0074] 将模拟声音数据通过预设终端进行播放。[0075] 需要说明的是,本发明通过对抗训练的方式生成与真实声浪数据分布尽可能接近的声浪数据。该算法根据车辆的发动机转速和行驶速度信息进行判别,并根据判别结果将初始化声音送入对应行驶状态(加速、减速、怠速)下的模型中,生成与行驶状态匹配的音频数据。生成的音频数据可用于直接播放,并向前反馈替换掉初始化声音。此外,本发明还可以根据下一状态下的判别器判别结果将音频数据送入对应的模型中继续生成声音。[0076] 根据本发明实施例,所述获取目标车辆的发动机转速、行驶速度信息与初始采集声音数据,基于目标车辆的发动机转速、行驶速度信息进行状态判别,具体为:[0077] 基于发动机转速、行驶速度信息与预设车辆行驶标准数据进行对比,并得到判别结果,判别结果为加速、减速、怠速中的其中一种。[0078] 需要说明的是,所述预设车辆行驶标准数据为用户设定数据,可以根据车辆型号进行更改。[0079] 根据本发明实施例,所述通过生成模型,基于GANSYNTH技术对初始采集声音数据进行预处理,得到基于二维信号形式的预处理音频数据,具体为:[0080] 将初始采集声音数据进行分帧加窗处理,形成多个中间数据;[0081] 对所述中间数据进行短时傅里叶变换,得到变换声音数据;[0082] 将变换声音数据沿预设维度进行堆叠,并形成基于二维信号形式的预处理音频数据。[0083] 需要说明的是,本发明中,GAN模型使用GANsynth来进行音频数据预处理,并结合了ProGAN和DCGAN的架构和训练策略,使其能够稳定的生成高质量声浪音频文件(即模拟声音数据)。[0084] 发动机声浪作为一种无条件声音,没有像语言声音一样的说话内容作为文本提示,也没有像音乐歌曲一样有音符或者节拍这样明显的特征可以直接进行学习,所以在对数据进行抓取的时候必须要进行针对性的预处理;本方法借鉴了图像处理方面的技术,将声音分帧加窗,再通过短时傅里叶变换(STFT),把每一帧的结果沿着一个维度堆叠起来,得到一个类似图片的二维信号形式数据。[0085] 根据本发明实施例,所述基于ProGAN的训练策略,设置渐进式训练方法,通过生成模型与对应鉴别器模型进行对抗训练,并得到接近原始声音特征的模拟声音数据,具体为:[0086] 基于ProGAN训练策略,采用渐进式训练方法,在生成模型中设置7层,每层通道数设定为[(128,112),(112,96),(96,80),(80,64),(64,48),(48,32),(32,16)],对应的鉴别器模型每层通道数与生成模型相反;[0087] 将预处理音频数据导入生成模型,以类图像模式进行数据生成,通过对应的鉴别器对生成的数据进行鉴别,循环进行对抗训练,并基于渐进式训练方法逐步提高生成数据的分辨率;[0088] 通过训练后的生成模型进行数据生成与转化,得到模拟声音数据。[0089] 需要说明的是,发动机声浪一类的无条件声音,因为其特征复杂和高纬度,使得模型在训练的时候很难适应,特征学习的情况会直接影响最终生成声音的质量,所以这里引入了ProGAN的训练策略。[0090] ProGAN的创新主要体现在渐进式增长的训练策略上,这种方法使模型从低分辨率的图像开始学习基础特征,随着训练的进程,逐步增加网络的深度和复杂性,以处理更高分辨率的图像。这种方法的引入有助于模型的稳定训练,避免了训练初期就面临大量的、难以区分的高维特征。[0091] 本发明渐进式训练共设立7层,生成器模型的每层通道数设定为[(128,112),(112,96),(96,80),(80,64),(64,48),(48,32),(32,16)],而鉴别器模型每层通道数与之相反。生成器通道数递减的设计可以提供更有效的训练和生成策略,特别是在需要生成高分辨率图像并采用渐进式增长的情况下。这种设计有助于平衡计算资源、多尺度特征表示和模型复杂性。而鉴别器通道数递增的设计主要有助于提高鉴别器的感知能力和适应性,尤其是在高分辨率图像鉴别任务中。这可以帮助鉴别器更好地执行其任务,从而提高生成对抗网络的性能和稳定性。[0092] 随着模型训练的进行,图像逐渐提高分辨率,这个过程被称为上采样。这意味着逐步增加图像的像素数量,以使其更加清晰和细致,尽可能地接近原始声音特征。[0093] 所述类图像模式即本发明通过将音频文件转化为图像数据文件(即基于二维信号形式的预处理音频数据),以图像数据形式,进行基于GAN的数据训练与对抗生成,从而得到较为精准的音频文件。训练后的生成模型生成的高分辨率图像数据通过音频格式转换,能够得到相应的声浪音频数据,即模拟声音数据。[0094] 根据本发明实施例,所述基于GAN的生成模型中,为采用DCGAN的方法构建,生成模型与对应的鉴别器模型均运用了深度卷积神经网络。[0095] 需要说明的是,DCGAN就是将CNN与GAN结合在一起,即生成器模型和判别器模型(即鉴别器模型)都运用了深度卷积神经网络的生成对抗网络,本发明所提出方法因为需要嵌入渐进式训练策略,所以与传统的DCGAN仍有不同:1、逐层增强的图像分辨率:本方法在生成器模型中引入逐层增强图像分辨率的设计,通过多次的上采样和反卷积操作,使生成的图像更加逼真和高分辨率;2、音频文件经过预处理后,使用复数表示幅值和相位信息来处理图片,以便生成的图像更加接近原始图像的特征;3、渐进式训练策略使模型在不同分辨率层次上逐渐学习图像特征,提高了生成质量。[0096] 通过本发明的主动声浪技术可以为电动汽车提供类似于传统燃油车的发动机声浪,增强驾驶的乐趣和真实感。在驾驶模拟器或赛车游戏中,为了提供更加真实的驾驶体验,本发明主动声浪技术可以被用于模拟各种车辆的发动机声音,增加玩家的沉浸感。[0097] 在本申请所提供的几个实施例中,应该理解到,所揭露的设备和方法,可以通过其它的方式实现。以上所描述的设备实施例仅仅是示意性的,例如,所述单元的划分,仅仅为一种逻辑功能划分,实际实现时可以有另外的划分方式,如:多个单元或组件可以结合,或可以集成到另一个系统,或一些特征可以忽略,或不执行。另外,所显示或讨论的各组成部分相互之间的耦合、或直接耦合、或通信连接可以是通过一些接口,设备或单元的间接耦合或通信连接,可以是电性的、机械的或其它形式的。[0098] 上述作为分离部件说明的单元可以是、或也可以不是物理上分开的,作为单元显示的部件可以是、或也可以不是物理单元;既可以位于一个地方,也可以分布到多个网络单元上;可以根据实际的需要选择其中的部分或全部单元来实现本实施例方案的目的。[0099] 另外,在本发明各实施例中的各功能单元可以全部集成在一个处理单元中,也可以是各单元分别单独作为一个单元,也可以两个或两个以上单元集成在一个单元中;上述集成的单元既可以采用硬件的形式实现,也可以采用硬件加软件功能单元的形式实现。[0100] 本领域普通技术人员可以理解:实现上述方法实施例的全部或部分步骤可以通过程序指令相关的硬件来完成,前述的程序可以存储于计算机可读取存储介质中,该程序在执行时,执行包括上述方法实施例的步骤;而前述的存储介质包括:移动存储设备、只读存储器(ROM,Read‑OnlyMemory)、随机存取存储器(RAM,RandomAccessMemory)、磁碟或者光盘等各种可以存储程序代码的介质。[0101] 或者,本发明上述集成的单元如果以软件功能模块的形式实现并作为独立的产品销售或使用时,也可以存储在一个计算机可读取存储介质中。基于这样的理解,本发明实施例的技术方案本质上或者说对现有技术做出贡献的部分可以以软件产品的形式体现出来,该计算机软件产品存储在一个存储介质中,包括若干指令用以使得一台计算机设备(可以是个人计算机、服务器、或者网络设备等)执行本发明各个实施例所述方法的全部或部分。而前述的存储介质包括:移动存储设备、ROM、RAM、磁碟或者光盘等各种可以存储程序代码的介质。[0102] 以上所述,仅为本发明的具体实施方式,但本发明的保护范围并不局限于此,任何熟悉本技术领域的技术人员在本发明揭露的技术范围内,可轻易想到变化或替换,都应涵盖在本发明的保护范围之内。因此,本发明的保护范围应以所述权利要求的保护范围为准。
专利地区:广东
专利申请日期:2024-01-19
专利公开日期:2024-05-03
专利公告号:CN117592384B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477