 产学研创新服务平台(全国)


一种深度学习中端到端的宠物语言翻译方法发明专利
更新时间:2026-10-28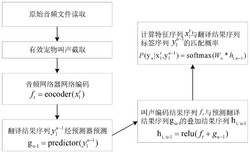 专利申请类型:发明专利;
地区:湖北-襄阳;
源自:襄阳高价值专利检索信息库;
专利名称:一种深度学习中端到端的宠物语言翻译方法
专利类型:发明专利
专利申请号:CN202111188371.3
专利申请(专利权)人:湖北文理学院
权利人地址:湖北省襄阳市隆中路296号
专利发明(设计)人:王峰,李梦君,屈俊峰,黄金洲,国冰磊,孙成娇
专利摘要:本发明提供了一种深度学习中端到端的宠物语言翻译方法,首先,读取原始宠物音频文件;然后从原始宠物音频文件中提取宠物叫声;再将提取的宠物叫声的音频特征序列输入预先构建的端到端的宠物语言翻译模型,其中,宠物语言翻译模型包括音频编码器网络、标签预测网络、联合网络和全连接层,音频编码器网络用于根据音频特征序列获取翻译结果标签序列,标签预测网络用于根据音频编码器网络获取的翻译结果标签序列的上一翻译结果标签序列得到预测结果序列,联合网络用于将音频编码器网络和标签预测网络的输出进行叠加,全连接层用于计算音频特征序列与翻译结果标签序列的匹配概率。本发明可以实现宠物语言翻译,并保证准确性。
主权利要求:
1.一种深度学习中端到端的宠物语言翻译方法,其特征在于,包括:S1:读取原始宠物音频文件;
S2:从原始宠物音频文件中提取宠物叫声;
S3:将提取的宠物叫声的音频特征序列输入预先构建的端到端的宠物语言翻译模型,其中,宠物语言翻译模型包括音频编码器网络、标签预测网络、联合网络和全连接层,音频编码器网络用于根据音频特征序列获取翻译结果标签序列,标签预测网络用于根据音频编码器网络获取的翻译结果标签序列的上一翻译结果标签序列得到预测结果序列,联合网络用于将音频编码器网络和标签预测网络的输出进行叠加,全连接层用于计算音频特征序列与翻译结果标签序列的匹配概率,基于匹配概率能够得到最终翻译结果。
2.如权利要求1所述的宠物语言翻译方法,其特征在于,步骤S3中音频编码器网络的计算过程为:其中,t表示时间序列,u表示翻译件结果标签序列的编号, 表示音频特征序列 对应的翻译结果标签序列,ft表示音频编码器网络的输出。
3.如权利要求1所述的宠物语言翻译方法,其特征在于,步骤S3标签预测网络的计算过程为:其中, 表示根据音频编码器网络获取的翻译结果标签序列 的上一翻译结果标签序列,gu‑1表示预测结果序列。
4.如权利要求1所述的宠物语言翻译方法,其特征在于,步骤S3联合网络的计算过程为:ht,u‑1=relu(ft+gu‑1)(3)
ht,u‑1表示将音频编码器网络的输出ft与标签预测网络的输出gu‑1进行叠加后得到的结果,表示宠物叫声在整个音频文件中标签词汇的分布概率。
5.如权利要求1所述的宠物语言翻译方法,其特征在于,步骤S3全连接层的计算过程为:表示音频特征序列, 表示根据音频编码器网络获取的翻译结果标签序列 的上一翻译结果标签序列,Wo表示宠物叫声的音频特征序列ft与预测结果序列gu‑1在联合网络ht,u‑1中进行匹配的连接边的权重,其中,权重越大,表明该叫声被匹配的翻译结果的分布概率越大。 说明书 : 一种深度学习中端到端的宠物语言翻译方法技术领域[0001] 本发明涉及人工智能中自然语言处理与翻译技术领域,尤其涉及一种深度学习中端到端的宠物语言翻译方法。背景技术[0002] 声纹,是指携带语言信息的声波频谱。它不仅具有特定性,而且具有相对稳定性的特点。对于人来说,其声音在成年后会保持长期相对稳定不变的状态。因此,它同指纹一样,具有独特的生物学特征,可用于身份识别。据美国圣何塞州立大学‑国家生物特征测评中心研究结果显示,与指纹、掌型、视网膜、虹膜、人脸、静脉等生物特征识别技术相比,声纹识别在易用性、准确率、成本、用户接受度、远程认证、手机采集等多方面具有不同程度的优势。[0003] 声纹识别技术工作的大体流程是:1、提取语音,预处理并提取声音特征;2、利用已训练模型,计算语音对应的声纹模型或特征;3、相似度打分,得到评级结果。本发明正是利用声纹识别技术中相关步骤作为桥梁来实现宠物语言翻译过程的。当前已存在最先进的技术i‑vectors和end‑to‑end仅限于将声纹识别技术应用于说话人鉴定上,即鉴定说话人与被鉴定对象是否为同一人,或找出被鉴定对象在被鉴定音频中是哪个说话人。[0004] 经详细的调查研究发现,鲜有技术模型和方法被用于宠物声纹识别,甚至于宠物语言翻译。发明内容[0005] 本发明提出一种深度学习中端到端的宠物语言翻译方法,用于解决或者至少部分解决现有技术中无法对宠物语言进行翻译的技术问题。[0006] 为了解决上述技术问题,本发明提供了一种深度学习中端到端的宠物语言翻译方法,包括:[0007] S1:读取原始宠物音频文件;[0008] S2:从原始宠物音频文件中提取宠物叫声;[0009] S3:将提取的宠物叫声的音频特征序列输入预先构建的端到端的宠物语言翻译模型,其中,宠物语言翻译模型包括音频编码器网络、标签预测网络、联合网络和全连接层,音频编码器网络用于根据音频特征序列获取翻译结果标签序列,标签预测网络用于根据音频编码器网络获取的翻译结果标签序列的上一翻译结果标签序列得到预测结果序列,联合网络用于将音频编码器网络和标签预测网络的输出进行叠加,全连接层用于计算音频特征序列与翻译结果标签序列的匹配概率,基于匹配概率能够得到最终翻译结果。[0010] 在一种实施方式中,步骤S3中音频编码器网络的计算过程为:[0011][0012] 其中,t表示时间序列,u表示翻译件结果标签序列的编号, 表示音频特征序列对应的翻译结果标签序列,ft表示音频编码器网络的输出。[0013] 在一种实施方式中,步骤S3标签预测网络的计算过程为:[0014][0015] 其中, 表示根据音频编码器网络获取的翻译结果标签序列 的上一翻译结果标签序列,gu‑1表示预测结果序列。[0016] 在一种实施方式中,步骤S3联合网络的计算过程为:[0017] ht,u‑1=relu(ft+gu‑1)(3)[0018] ht,u‑1表示将音频编码器网络的输出ft与标签预测网络的输出gu‑1进行叠加后得到的结果,表示宠物叫声在整个音频文件中标签词汇的分布概率。[0019] 在一种实施方式中,步骤S3全连接层的计算过程为:[0020][0021] 表示音频特征序列, 表示根据音频编码器网络获取的翻译结果标签序列的上一翻译结果标签序列,Wo表示宠物叫声的音频特征序列ft与预测结果序列gu‑1在联合网络ht,u‑1中进行匹配的连接边的权重,其中,权重越大,表明该叫声被匹配的翻译结果的分布概率越大。[0022] 本申请实施例中的上述一个或多个技术方案,至少具有如下一种或多种技术效果:[0023] 本发明提供的一种深度学习中端到端的宠物语言翻译方法,构建了端到端的宠物语言翻译模型,该翻译模型包括音频编码器网络(编码器)、标签预测网络(预测器)、联合网络和全连接层,编码器用于根据音频特征序列获取翻译结果标签序列,即可以得到原始宠物叫声编码后的结果,预测器用于根据 的上一翻译结果标签序列 得到预测结果序列gu‑1,联合网络对编码器和预测器的输出进行得加,利用非线性函数于计算整个音频文件目标语句中各种发声上标签词汇的分布概率。全连接层利用softmax函数计算音频特征序列与翻译结果标签序列的匹配概率,基于匹配概率能够得到最终翻译结果。本发明将声纹识别技术应用于宠物语言翻译中,构建的端到端模型是一个整合系统,可以实现一体化和联合优化;并且End‑to‑end的目标函数和说话人识别任务具有吻合性,主体具有多样性,可以用到不同结构和多种场景中,在翻译性能、数据多样性和与翻译目标的吻合性,以及整合系统一体化和联合优化等方面,均具有潜在的优势。附图说明[0024] 为了更清楚地说明本发明实施例或现有技术中的技术方案,下面将对实施例或现有技术描述中所需要使用的附图作简单地介绍,显而易见地,下面描述中的附图是本发明的一些实施例,对于本领域普通技术人员来讲,在不付出创造性劳动的前提下,还可以根据这些附图获得其他的附图。[0025] 图1为本发明实施例中基于端到端的宠物语言翻译方法的原理图;[0026] 图2为本发明实施例中利用端到端模型进行宠物语言翻译过程示意图;[0027] 图3为本发明实施中基于真实数据集的宠物语言翻译实验过程及结果展示图。具体实施方式[0028] 本发明的目的在于,提供一种深度学习中端到端的宠物语言翻译方法,采用End‑to‑end端到端应用于宠物语言翻译方法的应用上,在翻译性能、数据多样性和与翻译目标的吻合性,以及整合系统一体化和联合优化等方面,均具有潜在的优势。[0029] 当前的自然语言处理技术大多适用于人的语言和信息处理,鲜有涉及宠物语言。因此,本发明所涉技术和方法的公开有利于拓宽人们的视野,使人能够根据本发明提供的技术思路和方法对宠物的语言如何做到与人类语言匹配有更深刻认识。宠物主要通过吠声、身体部位的动作或行为向人发送实体信号,而起到与人沟通交流的目的。本发明通过对宠物吠声进行数据采集,利用宠物在不同品种、年龄、性别、行为、状态和场景下吠声的频率、频次、音色等指标的不同,利用深度学习中当下最先进的End‑to‑end(端到端)的声纹识别技术对吠声进行声学频谱上的提取和分析,基于不同的声学频谱与人类语言的匹配所构建的宠物语言翻译库,系统化的使得宠物语言翻译在声纹特征识别方面达到优质的效果。[0030] 为使本发明实施例的目的、技术方案和优点更加清楚,下面将结合本发明实施例中的附图,对本发明实施例中的技术方案进行清楚、完整地描述,显然,所描述的实施例是本发明一部分实施例,而不是全部的实施例。基于本发明中的实施例,本领域普通技术人员在没有做出创造性劳动前提下所获得的所有其他实施例,都属于本发明保护的范围。[0031] 本发明实施例提供了一种深度学习中端到端的宠物语言翻译方法,包括:[0032] S1:读取原始宠物音频文件;[0033] S2:从原始宠物音频文件中提取宠物叫声;[0034] S3:将提取的宠物叫声的音频特征序列输入预先构建的端到端的宠物语言翻译模型,其中,宠物语言翻译模型包括音频编码器网络、标签预测网络、联合网络和全连接层,音频编码器网络用于根据音频特征序列获取翻译结果标签序列,标签预测网络用于根据音频编码器网络获取的翻译结果标签序列的上一翻译结果标签序列得到预测结果序列,联合网络用于将音频编码器网络和标签预测网络的输出进行叠加,全连接层用于计算音频特征序列与翻译结果标签序列的匹配概率,基于匹配概率能够得到最终翻译结果。[0035] 相关研究表明,与其他生物特征识别技术相比,声纹识别在易用性、准确率、成本、用户接受度、远程认证、手机采集等多方面具有不同程度的优势。因此,本发明将宠物语言翻译技术定位于使用声纹识别技术作为中间核心技术不但具有方法创新性,而且具有技术先进性,同时在发明专利成果转化为实际生产力和产品应用方面是切实可行的。[0036] 本申请发明人经详细的调查研究发现,鲜有技术模型和方法被用于宠物声纹识别,甚至于宠物语言翻译。因此,本发明所涉技术和方法的公开在技术先进性、方法创新性和技术应用领先等多方面均具有优势。[0037] Speakeridentification(/verification/recognition),可翻译为说话人鉴定(/确认/识别)。虽然有三种不同的名称,但三个任务大同小异,它们的核心任务都是计算两段音频来自相同说话人的概率。早期的声纹识别方法主要借助波谱图匹配。后续分析理论和方法主要采用倒谱分析的解决思路。其代表性方法包括MFCCs、FilterBank。2012年,逐步跨入以深度学习为主线的算法研究,以DNN系统为代表的声纹识别技术陆续出现。直到近些年算法思想革新和技术不断改良,End‑to‑end端到端系统逐渐成为声纹识别领域当下最先进的技术。[0038] 在整个技术发展进程中,出现了一些具有代表性的声纹识别技术。接下来将针对这些代表性的背景技术做相关介绍。[0039] 1、高斯混合模型GMM:它被称之为声纹识别模型走进实用的开端。GMM是一种参数化的生成性模型,具备对实际数据极强的表征能力;因此,其劣势也比较明显,随着训练数据规模逐渐变大,表征能力越强导致其运算负荷效应也非常明显:由于参数规模等比例膨胀,因此需要更多的数据驱动GMM的参数才能得到更泛化的GMM模型。[0040] 2、GMM‑UBM通用背景模型:其本质是GMM的改良方法。即无法从目标用户采集足够的语音数据时,则从非目标用户那里采集数据。同时,将非目标和目标用户的数据进行混合训练GMM。由于这种模型混杂较多非目标用户,因此它不具备表征具体目标用户的能力。仅能看作是某具体目标模型的先验模型。换言之,即采用非目标用户进行预训练,以减少对目标用户的训练时间和调参。由此可见,GMM‑UBM模型不抗干扰。[0041] 3、因子分析框架模型FA&JFA:通过借助因子分析框架,只用数百个基向量的线性组合即可表征全体高斯超向量。联合因子分析JFA的理论分析框架将说话人的空间和信道所处空间做独立不相关假设。基于该假设,与声纹相关的全部信息均可由特征音空间表达,且同一说话人的多段语音在特征音空间上都能得到相同的参数映射。[0042] 4、全因子空间i‑vector:即任一段音频,无论长度和内容,都可被映射为一段低维度定长的i‑vector。因此,只需找到优化手段和测量方法,即可在海量数据中将同一说话人的多段i‑vector与不同说话人的i‑vector区分开。[0043] 5、基于深度学习的声纹识别技术:早期基于DNN的说话识别代替了GMM计算后验统计。2014年,Google提出d‑vector方法后,一系列基于DNN的方法被提出,如x‑vector等。其中,d‑vector指的是DNN训练后,通过提取每一帧语音的Filter‑bank能量特征作为DNN的输入,从最后一个隐藏层提取激活函数,L2进行正则化后被累加的结果。即,说话人若存在多条语音,那么采用这些语音的d‑vectors的均值表示这个人的声纹。[0044] 与d‑vector相比,x‑vector可利用短短的10s左右的语音,捕捉到用户声纹信息,在短语音上拥有更强的鲁棒性。[0045] 与i‑vector/PLDA相比,End‑to‑end端到端具有如下优势:[0046] (1)End‑to‑end是一个整合系统,它可以实现一体化和联合优化;[0047] (2)End‑to‑end的目标函数和说话人识别任务具有吻合性,而嵌入之类方法则是基于分类任务来做识别任务(识别与分类看似一样其实不一样),目的不一致;i‑vector谈不上这点;[0048] (3)End‑to‑end网络的主体具有多样性,可以用到不同结构和多种场景中,这就可以自由地提升性能,例如用CNN、ResNet、Attention等等;而i‑vector依然是UBM/T结构;从性能上看,数据量越大,E2E无论短时长还是长时长,都要优于i‑vector;[0049] 基于以上背景技术分析可知,本发明采用End‑to‑end端到端应用于宠物语言翻译方法的应用上,在翻译性能、数据多样性和与翻译目标的吻合性,以及整合系统一体化和联合优化等方面,均具有潜在的优势。相关的参考文献信息见实审参考资料。[0050] 针对当前宠物语言翻译方法在翻译性能、数据量保障、数据多样性、整合系统一体化和联合优化等多方面的不足,本发明公开了一种先进的端到端的声纹识别技术应用于宠物语言翻译的核心环节。该发明所涉技术的公开将对宠物语言翻译领域产生重要的影响。[0051] 通常而言,宠物语言翻译领域出现在人们的日常生活中,最普遍和常见的宠物翻译应用对象当属宠物狗。因此,本发明将以宠物狗作为目标对象,阐述如何将端到端的声纹识别技术一步步应用到宠物语言翻译中。[0052] 一般地,狗狗的叫声大致可分为5种类型,即:[0053] 1、“汪汪”叫,又可细分为如下3种情形:①声音高而重复:一般表明狗狗的情绪很糟糕;②单调的重复叫:表明狗狗比较无聊;③开心的叫:表明它很愉快;[0054] 2、低声咆哮:一般表明它在警告其它对象;[0055] 3、狼嚎:它可能存在以下三种情绪,①分离焦虑、生病、抑郁症;②追逐猎物或发现入侵者;③召唤它们的同伴;[0056] 4、哀鸣:可能存在以下两种情形,①分离;②生病,身体疼痛;[0057] 5、“呜呜”叫:表明它屈服于主人或其它动物;[0058] 虽然实际生活中,人们能通过耳朵感受到宠物狗的各种形式的叫声,即便是经验丰富的养狗专家在面对宠物叫声时尚且捉襟见肘,因此一般的养狗初学者更是无法理解这些宠物叫声代表的含义。鉴于此,本发明公开的技术和方法将具有解决这些问题的实际应用价值。[0059] 通过声纹提取的实验发现,上述狗狗的五类叫声,分别对应于不同的声纹特征,即便是每类叫声中的细小分类之间也是存在声纹特征上的区别,就连上述描述中的狗狗做出狼嚎的声音,也可以从声纹分析的角度将这种叫声与狼“嚎叫”的声音进行对比,通过声纹的相似性表明什么是狗的“狼嚎”声。[0060] 基于以上描述,本发明提出了一种end‑to‑end(端到端)的宠物语言翻译模型。该模型是一种面向实时和流音频识别的转化模型。该模型由音频编码器网络(编码器)、标签预测网络(预测器)、联合网络和全连接层构成。[0061] 编码器用于对输入的原始宠物语言的音频特征序列进行编码,预测器用于根据用于根据对应的标签序列进行预测,得到预测结果序列,联合网络对编码器和预测器的输出进行叠加,计算宠物叫声在整个音频文件中标签词汇的分布概率。最后通过Softmax函数计算特征序列 与翻译结果标签序列 的匹配概率,借以衡量翻译匹配结果的正确率。[0062] 在一种实施方式中,步骤S3中音频编码器网络的计算过程为:[0063][0064] 其中,t表示时间序列,u表示翻译件结果标签序列的编号, 表示音频特征序列对应的翻译结果标签序列,ft表示音频编码器网络的输出。[0065] 具体来说,时间序列t,可以由时分秒构成时间顺序。标签序列 是由公式1利用计算得到的。根据本领域的公知常识,一段音频录制完成以后为一段时间序列,每个时间序列所在的时间片都可以被划分出一片声纹。[0066] 在一种实施方式中,步骤S3标签预测网络的计算过程为:[0067][0068] 其中, 表示根据音频编码器网络获取的翻译结果标签序列 的上一翻译结果标签序列,gu‑1表示预测结果序列。[0069] 在一种实施方式中,步骤S3联合网络的计算过程为:[0070] ht,u‑1=relu(ft+gu‑1)(3)[0071] ht,u‑1表示将音频编码器网络的输出ft与标签预测网络的输出gu‑1进行叠加后得到的结果,表示宠物叫声在整个音频文件中标签词汇的分布概率。[0072] 在一种实施方式中,步骤S3全连接层的计算过程为:[0073][0074] 表示音频特征序列, 表示根据音频编码器网络获取的翻译结果标签序列的上一翻译结果标签序列,Wo表示宠物叫声的音频特征序列ft与预测结果序列gu‑1在联合网络ht,u‑1中进行匹配的连接边的权重,其中,权重越大,表明该叫声被匹配的翻译结果的分布概率越大。[0075] 针对上述公式(1)‑(4)做如下解释说明。公式(1)用于将原始的宠物叫声音频的特征序列 利用编码器进行编码,得到输出结果序列ft;作为宠语翻译结果的标签序列该序列需逐个通过预测器进行预测后,得出预测结果序列gu‑1;公式(3)利用relu函数计算宠物叫声在整个音频文件中标签词汇的分布概率,将原始宠物叫声编码后的结果ft与预测结果序列gu‑1进行叠加,得出结果ht,u‑1;公式(4)利用softmax函数计算特征序列 与翻译结果标签序列 的匹配概率,借以衡量翻译匹配结果的正确率。权重越大,表明该叫声被匹配的翻译结果的分布概率越大,借此反映宠物叫声与翻译结果匹配的契合程度。[0076] 请参见图1,为基于端到端的宠物语言翻译方法的原理图。基于图1的原理图,可绘制神经网络图对宠物语言翻译过程加以描述,如图2所示。[0077] 为了进一步说明本发明提供的方法的实施过程和有益效果,下面采用真实的宠物狗叫声的数据集进行宠语翻译的测试性实验,得到了区分度较高的实验结果,其实验过程和实验效果展示如图3所示。[0078] 图3中,采用真实宠物狗叫声的数据集,选取其中具有代表性的七组狗叫的数据,分别将这七组数据进行编号为 通过端到端神经网络模型的编码、预测、叠加、概率评估等一系列操作之后,得到图3中所示的七组实验结果。[0079] 值得说明的是,图中显示的七组翻译结果为翻译结果标签数据库根据神经网络模型的计算结果与预先训练和构建的规则进行匹配后得到的结果。其中,翻译结果标签数据库的,神经网络模型的计算结果是一系列概率结果: 哪一个的概率值最高,相应的翻译结果就会被输出,得出宠物语言翻译的结果。因为宠物的叫声可能存在多种结果,在人耳无法分辨的情况下,通过神经网络计算声纹特征的概率则可以很好地进行区分的。[0080] 关于预先训练和构建的规则,例如,图3中的第一个声纹,通过找多个有多年养狗经验的人的人耳来判断,会对该声音给出不同的结论,基于这些结论可以得到多组翻译结果来构成狗语言翻译后的人类语言,从而可以构建一种声音对应多个翻译结果的规则,但唯独对这个声音的声纹特征,对应翻译统计结果最高的结果。同时,采用这种思路进行迭代,将宠物声音类似但声纹略有差别的声音片段以此对应统计结果最高的翻译语言,则可以得到的“预先训练和构建的规则”。事实上,这些声音虽然相似,但人耳却是无法准确判断的,只能依靠声纹上识别其差别性才能实现宠物语言的翻译,从而达到了本发明所要实现的效果。[0081] 换句话说,由于宠物狗相似的声音片段,人在主观上会得出不同的结论,因此依赖丰富经验的养宠者的经验作为判断基础构建的“预先规则库”,对于声纹特征上的宠物翻译结果是有较好辅助性作用的。即本发明是利用养宠大神的智慧,去教会养宠小白如何正确的养宠。虽然,个别的养宠大神在相似声音判定时,也会出现错误,但利用养宠大神们经验的群体智慧会大大降低这种出错的概率,再结合深度学习技术对这种声纹特征的自动识别与剖析,以及群智的规则匹配,则可以大大提升宠物语言翻译的可信度和准确率。由于本发明公开的模型和方法能智能的将宠物狗的声纹数据很明显的区分开。由此可见,利用深度学习中端到端的神经网络技术应用于宠物语言翻译场景中,具有较大的应用价值、直观的产业化价值和较好的市场前景。[0082] 本发明所公开的技术和方法,可供技术产业化的应用开发人员将其植入到类似于宠物项圈、宠物手环或手表之类的宠物用品中,从而加强宠物主人和宠物间的沟通与交流。[0083] 以上实施例仅用以说明本发明的技术方案,而非对其限制;尽管参照前述实施例对本发明进行了详细的说明,本领域的普通技术人员应当理解:其依然可以对前述各实施例所记载的技术方案进行修改,或者对其中部分技术特征进行等同替换;而这些修改或者替换,并不使相应技术方案的本质脱离本发明各实施例技术方案的精神和范围。
专利地区:湖北
专利申请日期:2021-10-12
专利公开日期:2024-06-14
专利公告号:CN114023337B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




