 产学研创新服务平台(全国)


一种大语言模型隐含语义识别能力的评估方法和装置
更新时间:2026-10-29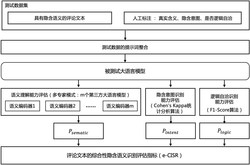 专利申请类型:发明专利;
地区:浙江-杭州;
源自:杭州高价值专利检索信息库;
专利名称:一种大语言模型隐含语义识别能力的评估方法和装置
专利类型:发明专利
专利申请号:CN202410552712.8
专利申请(专利权)人:浙江大学
权利人地址:浙江省杭州市西湖区余杭塘路866号
专利发明(设计)人:姚诚伟,卜佳俊,于智
专利摘要:本发明公开了一种大语言模型隐含语义识别能力的评估方法和装置,包括:构建评论文本隐含语义的测试数据集,其包含评论文本和多个维度上的标注标签;利用大语言模型预测得到测试数据集中评论文本的隐含语义、隐含意图和是否逻辑自洽;通过语义编码器对预测结果与标注标签进行语义编码后基于编码结果来评估模型在识别语义理解能力;采用了Cohen's Kappa统计分析算法对比模型的隐含意图预测结果与标注标签并评估模型在隐含意图识别能力;利用F1‑Score计算方法评估模型在逻辑自洽上的识别能力;综合三种能力得到模型的综合性隐含语义识别能力,能能促进评论文本分析领域的应用和发展。
主权利要求:
1.一种大语言模型隐含语义识别能力的评估方法,其特征在于,包括以下步骤:构建包括评论文本及其对应三类标注标签的测试数据集,其中标注标签包括评论文本的隐含语义标签和隐含意图标签、以及评论文本在隐含语义中是否逻辑自洽的逻辑自洽标签;
设计用于测试大语言模型的提示词,其中提示词包含与三类标注标签对应的三类任务预测指令、以及模型输出格式;
从测试数据集中提取每个评论文本与提示词组合后输入至被测试大语言模型得到三类任务的隐含语义预测结果、隐含意图预测结果、以及逻辑自洽预测结果;
利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力;
采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力;
采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力;
综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力。
2.根据权利要求1所述的大语言模型隐含语义识别能力的评估方法,其特征在于,所述隐含语义标签为至少一句概括评论文本真实含义的文本;
所述隐含意图标签包括批评抱怨、推荐建议、警告提醒、暗示引导、幽默调侃、以及激发讨论;
所述逻辑自洽标签包括表示评论文本在隐含语义中逻辑自洽的第一标识符,以及表示评论文本在隐含语义中不逻辑自洽的第二标识符。
3.根据权利要求1所述的大语言模型隐含语义识别能力的评估方法,其特征在于,提示词中包含的三类任务预测指令包括:预测评论文本的隐含语义,预测评论文本的隐含意图,以及预测评论文本在隐含语义中是否逻辑自洽。
4.根据权利要求1所述的大语言模型隐含语义识别能力的评估方法,其特征在于,利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力,包括:采用 个第三方大语言模型的语义编码器,并将隐含语义预测结果和隐含语义标签分别输入至每个语义编码器中得到对应的两个编码结果;
计算两个编码结果的相似度,并基于M个语义编码器对应的所有输入评论文本的相似度计算被测试大语言模型在隐含语义评论文本的语义理解能力上的综合评分 :;
其中, 表示第i条评论文本的隐含语义预测结果和隐含语义标签基于第m个语义编码器的编码结果计算的相似度, 表示评论文本数量, ,越大表示被测试大语言模型预测的语义相关度越高, 表示语义负相关,被测试大语言模型预测隐含语义的能力差。
5.根据权利要求1所述的大语言模型隐含语义识别能力的评估方法,其特征在于,采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力,包括:首先,根据评论文本的隐含意图标签和隐含意图预测结果构建第一混淆矩阵;
然后,针对第一混淆矩阵,利用Cohen'sKappa统计分析算法评估被测试大语言模型在隐含意图识别能力上的一致性 :;
其中, 表示观察一致性, 表示期望一致性, , 越
大表示被测试大语言模型在预测隐含意图上一致性越好, 表示被测试大语言模型猜对的偶然性高,被测试大语言模型预测隐含意图上的能力差。
6.根据权利要求1所述的大语言模型隐含语义识别能力的评估方法,其特征在于,采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力,包括:首先,根据逻辑自洽标签和逻辑自洽预测结果构建第二混淆矩阵;
然后,根据这个第二混淆矩阵,采用F1‑Score计算方法来评估被测试大语言模型的逻辑自洽识别能力的综合评分 :;
其中, 代表被测试大语言模型的精确度, 表示被测试大语言模型的召回率, ,数值越大代表被测试大语言模型的逻辑自洽识别能力越强。
7.根据权利要求1所述的大语言模型隐含语义识别能力的评估方法,其特征在于,综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力,包括:采用加权平均方法计算综合性隐含语义识别能力的评估结果 :;
其中, , ,以及 为权重系数,取值为(0 ,1) ,且 =1,, 越大代表被测试大语言模型在评论文本的综合性隐含
语义识别能力越强。
8.一种大语言模型隐含语义识别能力的评估装置,其特征在于,包括:数据集构建模块,用于构建包括评论文本及其对应三类标注标签的测试数据集,其中标注标签包括评论文本的隐含语义标签和隐含意图标签、以及评论文本在隐含语义中是否逻辑自洽的逻辑自洽标签;
提示词设计模块,用于设计用于测试大语言模型的提示词,其中提示词包含与三类标注标签对应的三类任务预测指令、以及模型输出格式;
模型预测模块,用于从测试数据集中提取每个评论文本与提示词组合后输入至被测试大语言模型得到三类任务的隐含语义预测结果、隐含意图预测结果、以及逻辑自洽预测结果;
语义理解能力评估模块,用于利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力;
隐含意图识别能力评估模块,用于采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力;
逻辑自洽识别能力评估模块,用于采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力;
综合评估模块,用于综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力。
9.一种计算设备,包括存储器和一个或多个处理器,所述存储器中存储有可执行代码,其特征在于,所述一个或多个处理器执行所述可执行代码时,用于实现权利要求1‑7中任一项所述的大语言模型隐含语义识别能力的评估方法。
10.一种计算机产品,其存储有计算机程序,其特征在于,该计算机程序被处理器执行时,实现权利要求1‑7中任一项所述的大语言模型隐含语义识别能力的评估方法。 说明书 : 一种大语言模型隐含语义识别能力的评估方法和装置技术领域[0001] 本发明属于自然语言处理与大语言模型相结合的技术领域,具体涉及一种大语言模型隐含语义识别能力的评估方法和装置。背景技术[0002] 深入分析和准确识别评论文本中的隐含语义,在电商评论分析、媒体人物画像构建以及虚假信息传播监测等多个方面发挥着极为重要作用。[0003] 随着大语言模型的技术突破,模型在处理长文本时展现出较强的上下文的理解力及逻辑推理能力,显著提高了对文本深层语义的理解与识别水平。然而,国内外的各类网络平台上的评论文本在表达上具有很大的复杂性,产生这种复杂性的主要因素包括:在电商平台上商业竞争问题以及用户需求多样化问题等;在媒体和社交平台上隐晦发布虚假信息等。这些复杂性因素增加了大语言模型对评论文本隐含语义识别的难度,因此选择或研发一款适合分析评论文本的隐含语义的大语言模型变得至关重要。在此过程中,首先需要有一种对大语言模型在评论文本隐含语义的识别能力进行全面、准确评估的方法。[0004] 目前对大语言模型的主流测试和评估方法包括:标准化和通用化的语言理解测试、多任务导向的评估、以及模型输出的一致性评估等。这些主流测试和评估方法的主要原理是通过设计一系列标准化的任务或问题,来测试大语言模型对语言的理解程度和解决问题的能力,往往侧重于评估大语言模型在通用领域的综合性能。然而,面向评论文本的隐含语义识别这一特殊且复杂任务上,传统的主流测试和评估方法难以精确地捕捉到模型在处理隐含语义时的细微差别,目前还缺乏一种这类任务上全面且有效的评估测试方法。[0005] 公开号为CN110363243A的专利申请公开了一种分类模型的评估方法,其计算正常样本的置信度与对抗样本的置信度之间的相似性来评估分类模型。公开号为CN116955974A专利申请公开了一种多分类模型性能评估方法,其包括:获取数据集以及多分类模型对数据集的分类结果;根据数据集以及多分类模型对数据集的分类结果计算任一类样本对应的预测概率分布以及真实概率分布;根据任一类样本的预测概率分布与任一类样本的真实概率分布之间的相似程度计算任一类的类别确信度;根据任一类的类别确信度与多边形面积的乘积计算任一类的分类性能多边形面积;根据多个类对应的分类性能多边形面积和数据集真实类别概率分布的余弦相似度对多分类模型性能进行评估。[0006] 上述两个技术方案虽然能够实现对分类模型的性能评估,由于大语言模型和分类模型的任务执行原理相差很大,因此上述技术方案并不能实现对大语言模型对评论文本隐含语义识别能力的评估。发明内容[0007] 鉴于上述,本发明的目的是提供一种大语言模型隐含语义识别能力的评估方法和装置,实现对大语言模型隐含语义识别能力的全面、准确、客观地评估。[0008] 为实现上述发明目的,实施例提供的一种大语言模型隐含语义识别能力的评估方法,包括以下步骤:[0009] 构建包括评论文本及其对应三类标注标签的测试数据集,其中标注标签包括评论文本的隐含语义标签和隐含意图标签、以及评论文本在隐含语义中是否逻辑自洽的逻辑自洽标签;[0010] 设计用于测试大语言模型的提示词,其中提示词包含与三类标注标签对应的三类任务预测指令、以及模型输出格式;[0011] 从测试数据集中提取每个评论文本与提示词组合后输入至被测试大语言模型得到三类任务的隐含语义预测结果、隐含意图预测结果、以及逻辑自洽预测结果;[0012] 利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力;[0013] 采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力;[0014] 采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力;[0015] 综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力。[0016] 优选地,所述隐含语义标签为至少一句概括评论文本真实含义的文本;[0017] 所述隐含意图标签包括批评抱怨、推荐建议、警告提醒、暗示引导、幽默调侃、以及激发讨论;[0018] 所述逻辑自洽标签包括表示评论文本在隐含语义中逻辑自洽的第一标识符,以及表示评论文本在隐含语义中不逻辑自洽的第二标识符。[0019] 优选地,提示词中包含的三类任务预测指令包括:预测评论文本的隐含语义,预测评论文本的隐含意图,以及预测评论文本在隐含语义中是否逻辑自洽。[0020] 优选地,利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力,包括:[0021] 采用 个第三方大语言模型的语义编码器,并将隐含语义预测结果和隐含语义标签分别输入至每个语义编码器中得到对应的两个编码结果;[0022] 计算两个编码结果的相似度,并基于M个语义编码器对应的所有输入评论文本的相似度计算被测试大语言模型在隐含语义评论文本的语义理解能力上的综合评分:[0023] ;[0024] 其中, 表示第i条评论文本的隐含语义预测结果和隐含语义标签基于第m个语义编码器的编码结果计算的相似度, 表示评论文本数量, ,越大表示被测试大语言模型预测的语义相关度越高, 表示语义负相关,被测试大语言模型预测隐含语义的能力差。[0025] 优选地,采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力,包括:[0026] 首先,根据评论文本的隐含意图标签和隐含意图预测结果构建第一混淆矩阵;[0027] 然后,针对第一混淆矩阵,利用Cohen'sKappa统计分析算法评估被测试大语言模型在隐含意图识别能力上的一致性 :[0028] ;[0029] 其中, 表示观察一致性, 表示期望一致性, ,越大表示被测试大语言模型在预测隐含意图上一致性越好, 表示被测试大语言模型猜对的偶然性高,被测试大语言模型预测隐含意图上的能力差。[0030] 优选地,采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力,包括:[0031] 首先,根据逻辑自洽标签和逻辑自洽预测结果构建第二混淆矩阵;[0032] 然后,根据这个第二混淆矩阵,采用F1‑Score计算方法来评估被测试大语言模型的逻辑自洽识别能力的综合评分 :[0033] ;[0034] 其中, 代表被测试大语言模型的精确度, 表示被测试大语言模型的召回率, ,数值越大代表被测试大语言模型的逻辑自洽识别能力越强。[0035] 优选地,综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力,包括:[0036] 采用加权平均方法计算综合性隐含语义识别能力的评估结果 :[0037] ;[0038] 其中, , ,以及 为权重系数,取值为(0,1),且 =1,, 越大代表被测试大语言模型在评论文本的综合性隐含语义识别能力越强。[0039] 为实现上述发明目的,本发明实施例还提供了一种大语言模型隐含语义识别能力的评估装置,包括:[0040] 数据集构建模块,用于构建包括评论文本及其对应三类标注标签的测试数据集,其中标注标签包括评论文本的隐含语义标签和隐含意图标签、以及评论文本在隐含语义中是否逻辑自洽的逻辑自洽标签;[0041] 提示词设计模块,用于设计用于测试大语言模型的提示词,其中提示词包含与三类标注标签对应的三类任务预测指令、以及模型输出格式;[0042] 模型预测模块,用于从测试数据集中提取每个评论文本与提示词组合后输入至被测试大语言模型得到三类任务的隐含语义预测结果、隐含意图预测结果、以及逻辑自洽预测结果;[0043] 语义理解能力评估模块,用于利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力;[0044] 隐含意图识别能力评估模块,用于采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力;[0045] 逻辑自洽识别能力评估模块,用于采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力;[0046] 综合评估模块,用于综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力。[0047] 为实现上述发明目的,本发明实施例还提供了一种计算设备,包括存储器和一个或多个处理器,所述存储器中存储有可执行代码,所述一个或多个处理器执行所述可执行代码时,用于实现上述大语言模型隐含语义识别能力的评估方法。[0048] 为实现上述发明目的,本发明实施例还提供了一种计算机产品,其存储有计算机程序,该计算机程序被处理器执行时,实现上述大语言模型隐含语义识别能力的评估方法。[0049] 与现有技术相比,本发明具有的有益效果至少包括:[0050] 在构建用于评估大语言模型隐含语义的测试数据集的基础上,从评论文本的隐含语义和隐含意图、以及评论文本在隐含语义中是否逻辑自洽这三个方面来综合评估大语言模型的综合性隐含语义识别能力。这样的评估方案全面、客观、且有效,可以用于指导不同领域的大语言模型的选择,在电商评论、媒体人画像分析和假消息文本监测等领域有着广泛应用前景。附图说明[0051] 为了更清楚地说明本发明实施例或现有技术中的技术方案,下面将对实施例或现有技术描述中所需要使用的附图做简单地介绍,显而易见地,下面描述中的附图仅仅是本发明的一些实施例,对于本领域普通技术人员来讲,在不付出创造性劳动前提下,还可以根据这些附图获得其他附图。[0052] 图1是实施例提供的大语言模型隐含语义识别能力的评估方法的流程图;[0053] 图2是实施例提供的大语言模型隐含语义识别能力的评估装置;[0054] 图3是实施例提供的计算设备的结构示意图。具体实施方式[0055] 为使本发明的目的、技术方案及优点更加清楚明白,以下结合附图及实施例对本发明进行进一步的详细说明。应当理解,此处所描述的具体实施方式仅仅用以解释本发明,并不限定本发明的保护范围。[0056] 为解决当前评估大语言模型对评论文本隐含语义识别能力存在的难题,本发明实施例提供的大语言模型隐含语义识别能力的评估方法,如图1所示,包括以下步骤:[0057] S1,构建包括评论文本及其对应三类标注标签的测试数据集,其中标注标签包括评论文本的隐含语义标签和隐含意图标签、以及评论文本在隐含语义中是否逻辑自洽的逻辑自洽标签。[0058] 实施例构建的测试数据集包含具有不同领域、不同程度隐含语义以及蕴涵不同意图的评论文本 ,还包括对评论文本进行多维度人工标注的标注标签 。这些测试数据集是评估的基础,其质量和覆盖度直接影响评估结果的准确性和可靠性。测试数据集涉及的要求和构建过程包括:[0059] (1)测试数据集中的评论文本应涵盖多个领域和主题,包括商品、文化、社会、体育四大类领域,以确保评估的全面性;[0060] (2)数据采集来源包括电商平台、媒体类网站、微博、博客等渠道;[0061] (3)采集下来的评论文本需要做数据清洗,去除各类控制符、说明性文字、冗余信息等,最终形成纯文本格式的数据;[0062] (4)人工标注评论文本的真实隐含语义,根据采集评论文本的上下标注出评论文本的真实隐含语义,并用1~2句话概括,并标注隐含语义标签 ;[0063] (5)评论文本的隐含意图重点围绕批评抱怨、推荐建议、警告提醒、暗示引导、幽默调侃、激发讨论,这些分类已经涵盖绝大部分的隐含意图。根据评论文本的上下文,标注出评论文本使用的隐含意图,以多数服从少数原则确定评论文本隐含意图的最终标注值,并标注隐含意图标签 ,具体标注标准如下:[0064] 批评抱怨:评论者可能使用反讽、语义双关等手法,隐晦地表达对某个产品、事件、人物或观点的批评或不满;[0065] 推荐建议:评论者通过描述自己的积极体验、经历或知识来暗示读者尝试同样的选择或认同同样的观点;[0066] 警告提醒:评论者隐晦地警告其他读者关于潜在的问题或风险,暗示读者不要去碰某些事情或东西;[0067] 暗示引导:评论者故意省略某些信息,让读者自行推断,暗示引导读者得出某些希望得到的结论或者推导出错误的信息;[0068] 幽默调侃:评论者使用隐含语义来创造幽默效果或调侃某个话题,意图相对中性;[0069] 激发讨论:评论者故意使用隐含语义来激发其他读者的兴趣,引发讨论或辩论。[0070] (6)人工标注是否逻辑自洽,根据评论文本的上下文标注出评论文本是否逻辑自洽,以判断评论文本是否通过隐晦表达来误导读者或发布假消息等潜在风险。标注以多数服从少数原则确定评论文本在隐含语义中是否逻辑自洽的最终标识符,包括表示评论文本在隐含语义中逻辑自洽的第一标识符TRUE、表示评论文本在隐含语义中不逻辑自洽的第二标识符FALSE,并标注逻辑自洽标签 。[0071] (7)用JSON格式整合 形成一个完整的测试数据集,其中,,表示每个评论文本 对应三个标注标签分别为 、 、 。[0072] (8)以上每个人工标注的通过至少3位语言专家完成并相互校对,多数服从少数原则,具有高度的准确性和一致性,以便为模型提供一个明确的评估标准。上述测试数据集用于在多个能力上对大语言模型理解和识别评论文本隐含语义上进行全面、客观的评估。[0073] S2,设计用于测试大语言模型的提示词,其中提示词包含与三类标注标签对应的三类任务预测指令、以及模型输出格式。[0074] 设计用于测试大语言模型的提示词(prompt)是评估过程中的关键环节,通过构建提示词要求被测试大语言模型通过理解测试数据集中评论文本给出对隐含语义的多维度预测。提示词是指导大语言模型进行预测的指令,明确指出预测任务指令和输出格式。在设计提示词时,按照顺序提取测试数据集中的一条评论文本 ,并包含明确的任务预测指令,也就是要求大语言模型根据给定评论文本完成指定任务,指定任务包含三类,分别为:(1)预测评论文本的隐含语义。(2)利用步骤S1中关于隐含意图的分类标准预测评论文本的隐含意图。(3)预测评论文本在隐含语义中是否逻辑自洽。[0075] 同时设计的提示词明确要求大语言模型的输出格式规范,具体要求包括:(1)预测评论文本的隐含语义时,以1~2句话概括输入内容的真实含义,并以纯文本格式输出。(2)预测评论文本的隐含意图时,输出{批评抱怨,推荐建议,警告提醒,暗示引导,幽默调侃,激发讨论}中的其中一个元素。(3)在预测评论文本在隐含语义中是否逻辑自洽时,输出第一标识符(TRUE)或第二标识符(FALSE)。[0076] 上述提示词的设计,可以确保本发明的主要任务方向和目标,从而提高预测的准确性。[0077] S3,从测试数据集中提取每个评论文本与提示词组合后输入至被测试大语言模型得三类任务的隐含语义预测结果、隐含意图预测结果、以及逻辑自洽预测结果。[0078] 被测试大语言模型一般已经在大规模数据集上进行预训练,已经学习到了丰富的知识、上下文逻辑关系和语言生成能力。通过调用经过预训练的大语言模型可以来解决各种下游任务。[0079] 实施例中,首先利用深度学习框架(如PyTorch)调取经过预训练的大语言模型,以及调取被测试大语言模型配套使用的字典(AutoTokenizer);然后将提取的评论文本与提示词组合后输入给经过预训练的大语言模型,模型根据提示词中的任务要求进行预测,并重复直上述过程至测试数据集中的所有评论文本都被预测,最终输出预测结果:[0080] ;[0081] 其中, 表示被预测的大语言模型对每个评论文本的隐含语义预测结果,即隐含语义预测结果中第i个变量 为1~2句纯文本语句;表示被预测的大语言模型对每个评论文本的隐含意图预测结果,即为{批评抱怨,推荐建议,警告提醒,暗示引导,幽默调侃,激发讨论}其中的某个元素; 表示被测试大语言模型对每个评论文本在隐含语义中的逻辑自洽预测结果,即为第一标识符TRUE或者第二标识符FALSE。[0082] S4,利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力。[0083] 为了更加客观、全面地进行测试评估,本发明实施例采用了多编码器即多专家思路方式。具体而言,采用 个第三方大语言模型的语义编码器,其中第三方大语言模型可以采用开源模型,如:BERT、ELECTRA、ChatGLM、XLNet、T5等,这些模型已经具备良好的语义编码能力,利用M个语义编码器分别对隐含语义预测结果 与人工标注的实际含义 进行语义编码得到编码结果,然后基于编码结果计算两者之间的相似程度来评估大语言模型的语义理解能力。具体过程如下:[0084] (1)按顺序调取第 个第三方大语言模型的预训练模型(AutoModel_Val[m]),以及对应提供的字典(AutoTokenizer_Val[m]),其中 , 为第三方用于评估的大语言模型的数量,如选择 ,表示利用3个第三方大语言模型用于评估;[0085] (2)将被测试大语言模型的隐含语义预测结果 与人工标注的隐含语义标签分别输入第三方大语言模型(AutoModel_Val[m])的语义编码器,结合其对应字典分别获得编码输出层输出的向量形式的编码结果 和 ;[0086] (3)利用余弦相似度算法计算 和 的相似度,公式如下:[0087] ;[0088] 其中, 表示第i条评论文本的隐含语义预测结果和隐含语义标签基于第m个语义编码器的编码结果计算的相似度。[0089] (4)判断所有第三方大语言模型是否全部被调用,如果没有全部被调用,则重复(1)至(4);[0090] (5)综合所有相似度来评估大语言模型的语义理解能力。前序步骤中获得所有被测试评论文本的相似度 ,其中 ,这些相似度反映了每个语义编码器对被测试大语言模型在理解每篇评论文本隐含语义方面的准确性。为了得到一个综合评分,需要对这些分散的评估结果进行整合。通过算术平均值,可以很好地平衡每个语义编码器在评估上差异,确保评估结果的全面性和客观性,因此计算被测试大语言模型在隐含语义评论文本的语义理解能力上的综合评分 为:[0091] ;[0092] 其中, , 越大表示被测试大语言模型预测的语义相关度越高, 表示语义负相关,被测试大语言模型预测隐含语义的能力较差。[0093] S5,采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力。[0094] 首先,利用测试数据集中关于评论文本的隐含意图标签 和被测试大语言模型输出的隐含意图预测结果 ,建立大小为 的第一混淆矩阵 ,其中 ,代表6种不同的隐含意图{批评抱怨,推荐建议,警告提醒,暗示引导,幽默调侃,激发讨论}。[0095] 然后,针对第一混淆矩阵 ,利用Cohen'sKappa统计分析算法评估被测试大语言模型在隐含意图识别能力上的一致性,具体计算过程如下:[0096] (1)计算观察一致性 ,即计算被预测大语言模型预测隐含意图的正确率:[0097] ;[0098] 其中, 为被预测大语言模型在第 种隐含意图上预测准确的数量,即混淆矩阵对角线的所有元素。[0099] (2)计算期望一致性 ,即计算偶然因素导致被预测大语言模型预测隐含意图的正确率:[0100] ;[0101] 其中, 和 分别代表第 种隐含意图上预测的假正例和假负例的数量。[0102] (3)计算Cohen'sKappa统计分析结果,即被测试大语言模型在隐含意图识别能力上的一致性 :[0103] ;[0104] 其中, , 越大表示被测试大语言模型在预测隐含意图上一致性越好, 表示被测试大语言模型猜对的偶然性较高,被测试大语言模型预测隐含意图上的能力较差。[0105] S6,采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力。[0106] 通过对大语言模型逻辑自洽识别性能的测试来评估模型对隐晦误导读者或虚假消息等的逻辑自洽识别能力。首先,利用测试数据集中关于评论文本在隐含语义中是否逻辑自洽的逻辑自洽标签 和被测试大语言模型输出的逻辑自洽预测结果 ,建立大小为 的第二混淆矩阵D,并计算真正例(TP)、假正例(FP)和假负例(FN)的数量。[0107] 然后,根据这个第二混淆矩阵D,采用F1‑Score计算方法来评估被测试大语言模型的逻辑自洽识别能力的综合评分 ,具体计算过程如下:[0108] ;[0109] 其中, 代表精确度, 代表召回率,,数值越大代表被测试大语言模型的逻辑自洽识别能力越强。[0110] S7,综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力。[0111] 综合被测试大语言模型在语义理解、隐含意图识别和逻辑自洽识别能力的评估结果,采用加权平均方法计算综合性隐含语义识别能力的评估结果 :[0112] ;[0113] 其中, , ,以及 为权重系数,取值为(0,1),且 =1,优选地,, , , , 越大代表被测试大语言模型在评论文本的综合性隐含语义识别能力越强。[0114] 通过以上步骤,可以全面、客观地评估大语言模型在评论文本隐含语义识别方面的能力,准确地比较不同大语言模型在评论文本隐含语义识别方面的性能差异,在相关不同应用中为选择合适的大语言模型提供科学依据。再者,这种评估方法不仅可以为模型的改进和优化提供依据,推动大语言模型在电商评论分析、媒体人画像和隐晦虚假消息监测等评论文本分析领域的应用和发展,还可以为相关领域的研究和应用提供重要的参考。[0115] 如图2所示,实施例还提供了一种大语言模型隐含语义识别能力的评估装置20,包括:数据集构建模块21、提示词设计模块22、模型预测模块23、语义理解能力评估模块24、隐含意图识别能力评估模块25、逻辑自洽识别能力评估模块26、以及综合评估模块27,其中,数据集构建模21用于构建包括评论文本及其对应三类标注标签的测试数据集,其中标注标签包括评论文本的隐含语义标签和隐含意图标签、以及评论文本在隐含语义中是否逻辑自洽的逻辑自洽标签;提示词设计模块22用于设计用于测试大语言模型的提示词,其中提示词包含与三类标注标签对应的三类任务预测指令、以及模型输出格式;模型预测模块23用于从测试数据集中提取每个评论文本与提示词组合后输入至被测试大语言模型得到三类任务的隐含语义预测结果、隐含意图预测结果、以及逻辑自洽预测结果;语义理解能力评估模块24用于利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力;隐含意图识别能力评估模块25用于采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力;逻辑自洽识别能力评估模块26用于采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力;综合评估模块27用于综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力。[0116] 需要说明的是,上述实施例提供的大语言模型隐含语义识别能力的评估装置在进行大语言模型隐含语义识别能力的评估方法时,应以上述各功能模块的划分进行举例说明,可以根据需要将上述功能分配由不同的功能模块完成,即在终端或服务器的内部结构划分成不同的功能模块,以完成以上描述的全部或者部分功能。另外,上述实施例提供的大语言模型隐含语义识别能力的评估装置与大语言模型隐含语义识别能力的评估方法实施例属于同一构思,其具体实现过程详见大语言模型隐含语义识别能力的评估方法实施例,这里不再赘述。[0117] 基于同样的发明构思,实施例还提供了一种计算设备,包括存储器和一个或多个处理器,存储器中存储有可执行代码,一个或多个处理器执行可执行代码时,用于实现大语言模型隐含语义识别能力的评估方法,具体包括以下步骤:[0118] S1,构建包括评论文本及其对应三类标注标签的测试数据集,其中标注标签包括评论文本的隐含语义标签和隐含意图标签、以及评论文本在隐含语义中是否逻辑自洽的逻辑自洽标签;[0119] S2,设计用于测试大语言模型的提示词,其中提示词包含与三类标注标签对应的三类任务预测指令、以及模型输出格式;[0120] S3,从测试数据集中提取每个评论文本与提示词组合后输入至被测试大语言模型得到三类任务的隐含语义预测结果、隐含意图预测结果、以及逻辑自洽预测结果;[0121] S4,利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力;[0122] S5,采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力;[0123] S6,采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力;[0124] S7,综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力。[0125] 如图3所示,实施例提供的计算设备,在硬件层面,除了包含处理器和存储器外,还包括内部总线、网络接口、内存等其他业务所需要的硬件。存储器为非易失性存储器,处理器从非易失性存储器中读取对应的计算机程序到内存中然后运行,以实现上述S1‑S7所述的大语言模型隐含语义识别能力的评估方法。当然,除了软件实现方式之外,本发明并不排除其他实现方式,比如逻辑器件抑或软硬件结合的方式等等,也就是说以下处理流程的执行主体并不限定于各个逻辑单元,也可以是硬件或逻辑器件。[0126] 基于同样的发明构思,实施例还提供了计算机产品,其存储有计算机程序,该计算机程序被处理器执行时,实现大语言模型隐含语义识别能力的评估方法,具体包括以下步骤:[0127] S1,构建包括评论文本及其对应三类标注标签的测试数据集,其中标注标签包括评论文本的隐含语义标签和隐含意图标签、以及评论文本在隐含语义中是否逻辑自洽的逻辑自洽标签;[0128] S2,设计用于测试大语言模型的提示词,其中提示词包含与三类标注标签对应的三类任务预测指令、以及模型输出格式;[0129] S3,从测试数据集中提取每个评论文本与提示词组合后输入至被测试大语言模型得到三类任务的隐含语义预测结果、隐含意图预测结果、以及逻辑自洽预测结果;[0130] S4,利用语义编码器对隐含语义预测结果和隐含语义标签进行编码后,基于编码结果评估被测试大语言模型的语义理解能力;[0131] S5,采用Cohen'sKappa统计分析算法并基于隐含意图预测结果和隐含意图标签评估被测试大语言模型的隐含意图识别能力;[0132] S6,采用F1‑Score计算方法并基于逻辑自洽预测结果和逻辑自洽标签评估被测试大语言模型的逻辑自洽识别能力;[0133] S7,综合大语言模型的语义理解能力、隐含意图识别能力以及逻辑自洽识别能力评估大语言模型的综合性隐含语义识别能力。[0134] 以上所述的具体实施方式对本发明的技术方案和有益效果进行了详细说明,应理解的是以上所述仅为本发明的最优选实施例,并不用于限制本发明,凡在本发明的原则范围内所做的任何修改、补充和等同替换等,均应包含在本发明的保护范围之内。
专利地区:浙江
专利申请日期:2024-05-07
专利公开日期:2024-07-16
专利公告号:CN118133844B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




