产学研创新服务平台(全国)


分散式风电功率预测方法、系统、装置及存储介质
更新时间:2026-11-01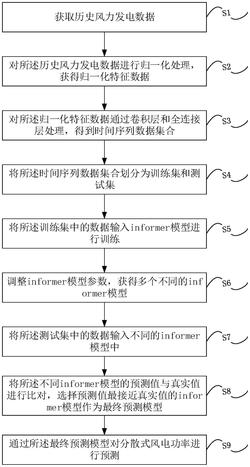 专利申请类型:实用新型专利;
地区:云南-昆明;
源自:昆明高价值专利检索信息库;
专利名称:分散式风电功率预测方法、系统、装置及存储介质
专利类型:实用新型专利
专利申请号:CN202210509345.4
专利申请(专利权)人:云南电网有限责任公司电力科学研究院
权利人地址:云南省昆明市经济技术开发区云大西路105号
专利发明(设计)人:苏适,李巍,严玉廷,潘姝慧,谢青洋,白浩,杨洋,杨家全,梁俊宇,袁智勇,袁兴宇,郭琦,张弓帅,徐敏
专利摘要:本申请涉及一种分散式风电功率预测方法、系统、装置及存储介质,属于电力系统技术领域。本申请包括:获取历史风力发电数据,对历史风力发电数据进行归一化处理,获得归一化特征数据;对归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合;将时间序列数据集合划分为训练集和测试集;将训练集中的数据输入informer模型进行训练;调整informer模型参数,获得多个不同的informer模型;将测试集中的数据输入不同的informer模型中;将不同informer模型的预测值与真实值进行比对,选择预测值最接近真实值的informer模型作为最终预测模型;通过本方案解决现有的网络模型无法捕获输出和输入之间固有的长距离特征,长序列时间预测效果较差的问题。
主权利要求:
1.一种分散式风电功率预测方法,其特征在于,所述方法包括:
获取历史风力发电数据,所述历史风力发电数据包括待预测风电厂的历史风电功率序列数据以及待预测风电厂所在区域的历史数值天气数据;
对所述历史风力发电数据进行归一化处理,获得归一化特征数据;
对所述归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合;
所述对所述归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合包括:将归一化特征数据输入卷积层中,对所述归一化特征数据中每个时间点的历史风力发电数据进行一维卷积处理,得到特征向量 通过全连接层处理每个时间点对应的特征向量 所对应的位置信息,得到局部时间戳PE,通过全连接层处理每个时间点本身的全局时间信息,得到全局时间戳SE;通过所述特征向量 所述局部时间戳PE以及所述全局时间戳SE计算采样点,所有的采样点形成所述时间序列数据集合;
将所述时间序列数据集合划分为训练集和测试集;
将所述训练集中的数据输入informer模型进行训练;
调整informer模型参数,获得多个不同的informer模型;
将所述测试集中的数据输入不同的informer模型中;
将所述不同informer模型的预测值与真实值进行比对,选择预测值最接近真实值的informer模型作为最终预测模型;
通过所述最终预测模型对分散式风电功率进行预测。
2.根据权利要求1所述的分散式风电功率预测方法,其特征在于,所述将所述训练集中的数据输入informer模型进行训练包括:选取所述训练集中两段长度为X个采样点的时间序列数据,分别作为编码器时间序列数据以及译码器时间序列数据,将所述编码器时间序列数据输入至informer模型的编码器中,将所述译码器时间序列数据输入至informer模型的译码器中,所述编码器时间序列数据为X个已知的采样点,所述译码器时间序列数据包括Y个已知的采样点以及Z个被遮挡的未知采样点,所述译码器时间序列数据中Y个已知的采样点与所述编码器时间序列数据中后Y个已知的采样点相同,所述Z个被遮挡的未知采样点作为被预测的值。
3.根据权利要求2所述的分散式风电功率预测方法,其特征在于,所述编码器接收所述编码器时间序列数据后,通过自身的多头稀疏自注意力模块以及自注意力蒸馏模块对编码器时间序列数据进行处理,得到编码特征,所述编码器将所述编码特征输入至所述译码器中,所述译码器接收所述译码器时间序列数据后,通过自身的多头稀疏自注意力模块将译码器时间序列数据与所述编码特征进行交互,输出预测值。
4.根据权利要求3所述的分散式风电功率预测方法,其特征在于,选择预测结果最接近真实值的informer模型作为最终预测模型的筛选标准为预测值与真实值的均方根误差,选取informer模型中输出的预测值与真实值的均方根误差最小的informer模型作为最终预测模型。
5.根据权利要求1所述的分散式风电功率预测方法,其特征在于,所述对所述历史风力发电数据进行归一化处理,获得归一化特征数据包括:将所述待预测风电厂所在区域的历史数值天气数据做平方以及三次方,将平方以及三次方后的待预测风电厂所在区域的历史数值天气数据作为两类新的特征,将两类新的特征以及所述历史风力发电数据进行归一化处理,获得归一化特征数据。
6.根据权利要求5所述的分散式风电功率预测方法,其特征在于,所述获取历史风力发电数据包括:根据预设的采样时间间隔获取待预测风电厂的风电功率,获取每个风电功率采样时间点的与风电功率相关的气象信息,所述与风电功率相关的气象信息包括风速、风向、气温、气压、湿度。
7.根据权利要求6所述的分散式风电功率预测方法,其特征在于,所述获取历史风力发电数据还包括:对所述历史风力发电数据进行预处理;所述预处理包括:查找历史风力发电数据中的缺失值,剔除历史风力发电数据中的问题值,将剔除的问题值和查找到的缺失值进行插值操作补全。
8.一种分散式风电功率预测系统,其特征在于,所述系统基于权利要求1‑7任一项所述的一种分散式风电功率预测方法,所述系统包括informer模型,所述informer模型包括编码器以及译码器,所述编码器包括多个编码结构,所述编码结构包括多头稀疏自注意力模块以及自注意力蒸馏模块,所述译码器包括两个一样的多头稀疏自注意力模块。
9.一种分散式风电功率预测装置,其特征在于,所述装置包括:
数据获取模块:用于获取历史风力发电数据;
特征数据获取模块:用于对历史风力发电数据进行归一化处理,获得归一化特征数据;
时间序列数据集合获取模块:用于对归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合;
所述对所述归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合包括:将归一化特征数据输入卷积层中,对所述归一化特征数据中每个时间点的历史风力发电数据进行一维卷积处理,得到特征向量 通过全连接层处理每个时间点对应的特征向量 所对应的位置信息,得到局部时间戳PE,通过全连接层处理每个时间点本身的全局时间信息,得到全局时间戳SE;通过所述特征向量 所述局部时间戳PE以及所述全局时间戳SE计算采样点,所有的采样点形成所述时间序列数据集合;
最终预测模型获取模块:用于通过时间序列数据集合对informer模型进行训练得到最终预测模型。
10.一种存储介质,其特征在于,所述存储介质存储有计算机程序,所述计算机程序被处理器执行时,实现如权利要求1‑7任一项所述的分散式风电功率预测方法中的各个步骤。 说明书 : 分散式风电功率预测方法、系统、装置及存储介质技术领域[0001] 本申请属于电力系统技术领域,具体涉及分散式风电功率预测方法、系统、装置及存储介质。背景技术[0002] 随着世界能源环境的改革以及环境保护的迫切需要,风电在可再生能源中的地位愈发凸显,风电的高速发展,大大缓解我国能源不足的现状,但是风电本身所特有的间歇性和不确定性增加了对电网计划和调度的难度。对于像中部地区和东南沿海地区这些负荷较为集中的地区,大多都属于风能资源第三类地区,不利于风电的集中的,连续大片的开发,分散式风电解决了这些地区风能利用的问题。分散式接入风电项目是指位于用电负荷中心附近,不以大规模远距离输送电力为目的,所产生的电力就近接入电网,并在当地消纳的风电项目。随着分散式风电的扩建和发展,对分散式风电风功预测,成为了使分散式风电平稳运行、使其所接入的电网安全可靠运行的重要手段。准确的风电功率预测,可以显著提高电力系统安全性、稳定性、经济性、可靠性,并提高风电的消纳能力。[0003] 目前,国内外众多学者已经做了大量研究,在风功预测方面主要有统计方法和物理方法。物理方法需要众多复杂的风机相关信息,应用起来难度较高。统计方法只需要风速、天气情况和功率等相关时间序列即可。常见的方法有人工神经网络法,支持向量机法等,但是现有的方法所使用的模型如LSTM、RNN模型由于本身的架构限制了长序列时间预测(longsequencetime‑seriesforecasting:LSTF)的性能,无法捕获输出和输入之间固有的长距离特征,而恰好长序列时间预测可以提供更精准的早期警报,以确保分散式风电的平稳运行。发明内容[0004] 为此,本申请提供一种分散式风电功率预测方法、系统、装置及存储介质,本申请中,通过构建基于informer模型的风电功率预测模型,实现风电功率的长序列时间预测,用于解决现有的网络模型无法捕获输出和输入之间固有的长距离特征,长序列时间预测效果较差的问题。[0005] 为实现以上目的,本申请采用如下技术方案:[0006] 一种分散式风电功率预测方法,所述方法包括:[0007] 获取历史风力发电数据,所述历史风力发电数据包括待预测风电厂的历史风电功率序列数据以及待预测风电厂所在区域的历史数值天气数据;[0008] 对所述历史风力发电数据进行归一化处理,获得归一化特征数据;[0009] 对所述归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合;[0010] 将所述时间序列数据集合划分为训练集和测试集;[0011] 将所述训练集中的数据输入informer模型进行训练;[0012] 调整informer模型参数,获得多个不同的informer模型;[0013] 将所述测试集中的数据输入不同的informer模型中;[0014] 将所述不同informer模型的预测值与真实值进行比对,选择预测值最接近真实值的informer模型作为最终预测模型;[0015] 通过所述最终预测模型对分散式风电功率进行预测。[0016] 进一步的,所述对所述归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合包括:将归一化特征数据输入卷积层中,对所述归一化特征数据中每个时间点的历史风力发电数据进行一维卷积处理,得到特征向量 通过全连接层处理每个时间点对应的特征向量 所对应的位置信息,得到局部时间戳PE,通过全连接层处理每个时间点本身的全局时间信息,得到全局时间戳SE;通过所述特征向量 所述局部时间戳PE以及所述全局时间戳SE计算采样点,所有的采样点形成所述时间序列数据集合。[0017] 进一步的,所述将所述训练集中的数据输入informer模型进行训练包括:选取所述训练集中两段长度为X个采样点的时间序列数据,分别作为编码器时间序列数据以及译码器时间序列数据,将所述编码器时间序列数据输入至informer模型的编码器中,将所述译码器时间序列数据输入至informer模型的译码器中,所述编码器时间序列数据为X个已知的采样点,所述译码器时间序列数据包括Y个已知的采样点以及Z个被遮挡的未知采样点,所述译码器时间序列数据中Y个已知的采样点与所述编码器时间序列数据中后Y个已知的采样点相同,所述Z个被遮挡的未知采样点作为被预测的值。[0018] 进一步的,所述编码器接收所述编码器时间序列数据后,通过自身的多头稀疏自注意力模块以及自注意力蒸馏模块对编码器时间序列数据进行处理,得到编码特征,所述编码器将所述编码特征输入至所述译码器中,所述译码器接收所述译码器时间序列数据后,通过自身的多头稀疏自注意力模块将译码器时间序列数据与所述编码特征进行交互,输出预测值。[0019] 进一步的,所述选择预测结果最接近真实值的informer模型作为最终预测模型的筛选标准为预测值与真实值的均方根误差,选取informer模型中输出的预测值与真实值的均方根误差最小的informer模型作为最终预测模型。[0020] 进一步的,所述对所述历史风力发电数据进行归一化处理,获得归一化特征数据包括:将所述待预测风电厂所在区域的历史数值天气数据做平方以及三次方,将平方以及三次方后的待预测风电厂所在区域的历史数值天气数据作为两类新的特征,将两类新的特征以及所述历史风力发电数据进行归一化处理,获得归一化特征数据。[0021] 进一步的,所述获取历史风力发电数据包括:根据预设的采样时间间隔获取待预测风电厂的风电功率,获取每个风电功率采样时间点的与风电功率相关的气象信息,所述与风电功率相关的气象信息包括风速、风向、气温、气压、湿度。[0022] 进一步的,所述获取历史风力发电数据还包括:对所述历史风力发电数据进行预处理;所述预处理包括:查找历史风力发电数据中的缺失值,剔除历史风力发电数据中的问题值,将剔除的问题值和查找到的缺失值进行插值操作补全。[0023] 一种分散式风电功率预测系统,所述系统基于所述的一种分散式风电功率预测方法,所述系统包括informer模型,所述informer模型包括编码器以及译码器,所述编码器包括多个编码结构,所述编码结构包括多头稀疏自注意力模块以及自注意力蒸馏模块,所述译码器包括两个一样的多头稀疏自注意力模块。[0024] 一种分散式风电功率预测装置,所述装置包括:[0025] 数据获取模块:用于获取历史风力发电数据;[0026] 特征数据获取模块:用于对历史风力发电数据进行归一化处理,获得归一化特征数据;[0027] 时间序列数据集合获取模块:用于对归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合;[0028] 最终预测模型获取模块:用于通过时间序列数据集合对informer模型进行训练得到最终预测模型。[0029] 一种存储介质,所述存储介质存储有计算机程序,所述计算机程序被处理器执行时,实现所述的分散式风电功率预测方法中的各个步骤。[0030] 本申请采用以上技术方案,至少具备以下有益效果:[0031] 本申请通过获取历史风力发电数据,对历史风力发电数据进行归一化处理,利用归一化后的历史风力发电数据训练informer模型,得到最终informer模型,通过最终informer模型实现分散式风电功率的长序列时间预测,解决现有的模型,如LSTM、RNN等模型对于长序列时间预测效果较差,无法捕获输出和输入之间固有的长距离特征的问题。[0032] 应当理解的是,以上的一般描述和后文的细节描述仅是示例性和解释性的,并不能限制本申请。附图说明[0033] 为了更清楚地说明本申请实施例或现有技术中的技术方案,下面将对实施例或现有技术描述中所需要使用的附图作简单地介绍,显而易见地,下面描述中的附图仅仅是本申请的一些实施例,对于本领域普通技术人员来讲,在不付出创造性劳动的前提下,还可以根据这些附图获得其他的附图。[0034] 图1是根据一示例性实施例示出的一种分散式风电功率预测方法的流程图;[0035] 图2是根据一示例性实施例示出的获取时间序列数据集合的流程图;[0036] 图3是根据一示例性实施例示出的一种分散式风电功率预测装置的连接示意图;[0037] 图4是根据一示例性实施例示出的informer模型输入表示示意图;[0038] 图5是根据一示例性实施例示出的informer模型结构示意图;[0039] 图6是根据一示例性实施例示出的informer编码器结构示意图[0040] 附图中:1‑数据获取模块,2‑特征数据获取模块,3‑时间序列数据集合获取模块,4‑最终预测模型获取模块。具体实施方式[0041] 为使本申请的目的、技术方案和优点更加清楚,下面将对本申请的技术方案进行详细的描述。显然,所描述的实施例仅仅是本申请一部分实施例,而不是全部的实施例。基于本申请中的实施例,本领域普通技术人员在没有做出创造性劳动的前提下所得到的所有其它实施方式,都属于本申请所保护的范围。[0042] 请参阅图1,图1是根据一示例性实施例示出的分散式风电功率预测方法的流程图,该分散式风电功率预测方法应用于电力控制技术领域,该分散式风电功率预测方法包括:[0043] S1,获取历史风力发电数据,所述历史风力发电数据包括待预测风电厂的历史风电功率序列数据以及待预测风电厂所在区域的历史数值天气数据;[0044] S2,对所述历史风力发电数据进行归一化处理,获得归一化特征数据;[0045] S3,对所述归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合;[0046] S4,将所述时间序列数据集合划分为训练集和测试集;[0047] S5,将所述训练集中的数据输入informer模型进行训练;[0048] S6,调整informer模型参数,获得多个不同的informer模型;[0049] S7,将所述测试集中的数据输入不同的informer模型中;[0050] S8,将所述不同informer模型的预测值与真实值进行比对,选择预测值最接近真实值的informer模型作为最终预测模型;[0051] S9,通过所述最终预测模型对分散式风电功率进行预测;[0052] 具体的,获取待预测风电厂的历史风电功率序列数据以及风电厂所在区域的数值天气数据,由于不同变量间的量纲存在差异,会造成很大的数量上的差别,为更加全面公平地考量各个因素变量的影响,需将历史风电功率以及数值天气数据进行时间序列归一化,由于天气数据的非周期性趋势,通过一阶差分的方法使信号从非平稳变换至平稳状态,通过样本数据的极限值归一化处理数值天气数据和风电功率,将数值归至[‑1,1],通过公式进行处理得到归一化特征数据,所述公式如下:[0053][0054] 式中,xmin为各个变量的极小值,xmax为各个变量的极大值;[0055] 将所述归一化特征数据通过卷积层进行一维卷积处理以及通过全连接层处理每个时间点本身的全局时间信息得到时间序列数据集合,将时间序列数据集合划分为训练集以及测试集,其中,抽取时间序列数据集合中的百分之七十作为训练集,剩下的百分之三十作为测试集,将训练集中的数据输入到informer模型中进行训练,通过训练结果调整informer模型的各项参数,得到多个不同参数的informer模型,将测试集中的数据一一输入到不同参数的informer模型中,不同的informer模型输出各自的预测值,将informer模型各自输出的预测值与真实值进行误差比对,选取误差最小的预测值的informer模型作为最终预测模型,通过最终预测模型对电力系统中分散式风电功率进行预测,提前获得分散式风电功率的预测值。[0056] 如附图2所示,所述对所述归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合包括:[0057] S301,将归一化特征数据输入卷积层中,对所述归一化特征数据中每个时间点的历史风力发电数据进行一维卷积处理,得到特征向量[0058] S302,通过全连接层处理每个时间点对应的特征向量 所对应的位置信息,得到局部时间戳PE,通过全连接层处理每个时间点本身的全局时间信息,得到全局时间戳SE;[0059] S303,通过所述特征向量 所述局部时间戳PE以及所述全局时间戳SE计算采样点,所有的采样点形成所述时间序列数据集合;[0060] 具体的,如附图4所示,通过卷积层对所述归一化特征数据中每个时间点的历史风力发电数据进行一维卷积处理,得到特征向量 通过全连接层处理每个时间点对应的特征向量所对应的位置信息,得到局部时间戳PE,所述公式如下:[0061] 〖PE〗_((pos,2j))=sin(pos/(2L_x)^(2j/d_model))[0062] 通过全连接层处理每个时间点本身的全局时间信息,所述全局时间信息包括:年、月、日、时、节假日等,得到全局时间戳SE,所述公式如下:[0063] 〖SE〗_((pos,2j+1))=cos(pos/(2L_x)^(2j/d_model))[0064] 其中,局部时间戳PE以及全局时间戳SE的计算公式中,[0065] j∈{1,…,[d_model/2]}[0066] 根据特征向量 局部时间戳PE以及全局时间戳SE,通过公式计算采样点,所述公式如下:[0067][0068] 将计算出的所有采样点进行集合,得到时间序列数据集合。[0069] 进一步的,所述将所述训练集中的数据输入informer模型进行训练包括:选取所述训练集中两段长度为X个采样点的时间序列数据,分别作为编码器时间序列数据以及译码器时间序列数据,将所述编码器时间序列数据输入至informer模型的编码器中,将所述译码器时间序列数据输入至informer模型的译码器中,所述编码器时间序列数据为X个已知的采样点,所述译码器时间序列数据包括Y个已知的采样点以及Z个被遮挡的未知采样点,所述译码器时间序列数据中Y个已知的采样点与所述编码器时间序列数据中后Y个已知的采样点相同,所述Z个被遮挡的未知采样点作为被预测的值;[0070] 具体的,将时间序列数据集合分成训练集以及测试集,其中,所述时间序列数据集合中的百分之七十作为训练集,剩下的百分之三十作为测试集,将训练集中的数据选取两段长度为20个采样点的时间序列数据,分别作为编码器时间序列数据以及译码器时间序列数据,其中,所述编码器时间序列数据中的20个采样点作为已知采样点输入至编码器中,所述译码器时间序列数据包括8个已知采样点以及12个被遮挡的未知采样点,被遮挡的未知采样点在输入至译码器中时,设置为0,其中,译码器时间序列数据中的8个已知采样点与编码器时间序列数据中后8个连续的已知采样点相同。[0071] 进一步的,所述编码器接收所述编码器时间序列数据后,通过自身的多头稀疏自注意力模块以及自注意力蒸馏模块对编码器时间序列数据进行处理,得到编码特征,所述编码器将所述编码特征输入至所述译码器中,所述译码器接收所述译码器时间序列数据后,通过自身的多头稀疏自注意力模块将译码器时间序列数据与所述编码特征进行交互,输出预测值;[0072] 具体的,如附图5所示,编码器在接收到编码器时间序列数据后,通过多头稀疏自注意力模块以及自注意力蒸馏模块(附图5中,用阴影部分表示的梯形)对编码器时间序列数据尽心处理,得到编码特征,将所述编码特征输入到译码器中,当译码器接收到译码器时间序列数据后,通过多头注意力与编码特征进行交互,输出预测值(附图5中,最右侧用阴影表示的小方格)。[0073] 进一步的,所述选择预测结果最接近真实值的informer模型作为最终预测模型的筛选标准为预测值与真实值的均方根误差,选取informer模型中输出的预测值与真实值的均方根误差最小的informer模型作为最终预测模型;[0074] 具体的,当不同的informer模型输出不同的预测值后,通过均方根误差法计算预测值与真实值之间的误差,均方根误差法是严格计算误差的指标,选取均方根误差最小的预测值对应的informer模型作为最终预测模型,均方根误差的公式为:[0075][0076] 其中,n为预测验证数据个数;Yi和 分别为数据的真实值和预测值;i为预测点序列编号。[0077] 进一步的,所述对所述历史风力发电数据进行归一化处理,获得归一化特征数据包括:将所述待预测风电厂所在区域的历史数值天气数据做平方以及三次方,将平方以及三次方后的待预测风电厂所在区域的历史数值天气数据作为两类新的特征,将两类新的特征以及所述历史风力发电数据进行归一化处理,获得归一化特征数据;[0078] 具体的,为丰富神经网络的特征输出内容,基于风功率密度、风能密度计算原理,分别将数值天气数据做平方和三次方,将平方和三次方后的数值天气数据作为新的两类特征,将两类新的特征以及原先的数值天气数据以及历史风电功率数据进行归一化处理,得到归一化特征数据。[0079] 进一步的,所述获取历史风力发电数据包括:根据预设的采样时间间隔获取待预测风电厂的风电功率,获取每个风电功率采样时间点的与风电功率相关的气象信息,所述与风电功率相关的气象信息包括风速、风向、气温、气压、湿度;[0080] 具体的,以15分钟的采样间隔时间获取风电功率数据,同时获取每个获取到的每个时间点的风电功率对应的数值天气数据,所述数据天气数据是影响风电功率的气象信息,所述气象信息包括风速、风向、气温、气压以及湿度等。[0081] 进一步的,所述获取历史风力发电数据还包括:对所述历史风力发电数据进行预处理;所述预处理包括:查找历史风力发电数据中的缺失值,剔除历史风力发电数据中的问题值,将剔除的问题值和查找到的缺失值进行插值操作补全;[0082] 具体的,由于数据在采集过程中存在漏采、误采以及误报等现象,对风电功率预测模型的训练产生影响,因此需要对原始数据进行预处理,所述预处理包括:剔除采集数据中的问题值,寻找采集数据中的缺失值,将已经剔除的问题值和缺失值进行插值操作补全。[0083] 一种分散式风电功率预测系统,所述系统基于所述的一种分散式风电功率预测方法,所述系统包括informer模型,所述informer模型包括编码器以及译码器,所述编码器包括多个编码结构,所述编码结构包括多头稀疏自注意力模块以及自注意力蒸馏模块,所述译码器包括两个一样的多头稀疏自注意力模块;[0084] 具体的,本方案所使用的informer模型包括编码器以及译码器,所述编码器包括多个编码结构,所述编码结构包括多头稀疏自注意力模块以及自注意力蒸馏模块,多个编码结构堆叠提升模型的鲁棒性,编码器采用自注意力蒸馏机制,通过卷积核最大池化大幅减少维度和网络的参数,传统的self‑attention输入为(query,key,value),表示为:[0085][0086] 其中 d是输入维度;[0087] 第i个query对所有key的关注度定义为概率p(ki|qi),定义第i个querysparsity评估为:[0088][0089] 其中,第一项qi是在所有key的Log‑Sum‑Exp(LSE),第二项是arithmetic均值;[0090] 而稀疏自注意力机制表示为:[0091][0092] 其中 是和q相同大小的稀疏矩阵,并且它只包含在稀疏评估M(q,M)下top‑u的queries,其中,u的大小通过一个采样参数来决定,u=c*lnLq。[0093] 如附图6所示的编码器结构示意图,本方案采用的编码器通过加入卷积层和最大池化层减少维度和网络参数量。作为概率自注意机制的自然结果,编码器的特征映射具有价值v的冗余组合,使用蒸馏操作对具有主导特征的优势特征进行特权,在下一层生成聚焦的自注意特征映射,它大幅削减了输入的时间维度,如上图中注意力块的n个头的权重矩阵,“蒸馏”过程从第j层向前推进到j+1层,用公式表示为:[0094][0095] 其中,[·]AB包含多头稀疏自注意和注意块中的基本运算,Conv1d(·)利用ELU(·)激活函数在时间维上进行1维卷积滤波器,这也是本申请采用的informer模型可以解决现有的模型对于预测长时间序列效果往往比较差的问题的关键之一。[0096] 本方案采用的译码器一次前向计算输出所有预测结果。本实施例使用标准的decoder结构,由两个一样的multiheadattention层,但是,生成式inference被用来缓解速度瓶颈,使用下面的向量输入decoder:[0097][0098] 其中, 是starttoken,是一个分界点,将Maskedmulti‑headattention应用于ProbSparseself‑attention,将mask的点积设置为‑∞。[0099] 如附图3所示,所述装置包括:[0100] 数据获取模块1:用于获取历史风力发电数据;[0101] 特征数据获取模块2:用于对历史风力发电数据进行归一化处理,获得归一化特征数据;[0102] 时间序列数据集合获取模块3:用于对归一化特征数据通过卷积层和全连接层处理,得到时间序列数据集合;[0103] 最终预测模型获取模块4:用于通过时间序列数据集合对informer模型进行训练得到最终预测模型;[0104] 具体的,通过数据获取模块1获取历史风力发电数据,通过特征数据获取模块2对历史风力发电数据进行归一化处理,得到归一化特征数据,通过时间序列数据集合获取模块3对归一化特征数据通过卷积处理以及全连接处理得到采样点,将所有的采样点进行集合得到时间序列数据集合,最终预测模型获取模块4通过时间序列数据集合对上述所述的informer模型进行训练,选取输出的预测值最接近真实值的informer模型作为最终预测模型,通过最终预测模型对电力系统中分散式风电功率进行预测,提前得知风电功率的预测值。[0105] 一种存储介质,所述存储介质存储有计算机程序,所述计算机程序被处理器执行时,实现所述的分散式风电功率预测方法中的各个步骤;[0106] 具体的,所述存储介质可以是只读存储器,磁盘或光盘等,或其任意的组合。[0107] 可以理解的是,上述各实施例中相同或相似部分可以相互参考,在一些实施例中未详细说明的内容可以参见其他实施例中相同或相似的内容。[0108] 需要说明的是,在本申请的描述中,术语“第一”、“第二”等仅用于描述目的,而不能理解为指示或暗示相对重要性。此外,在本申请的描述中,除非另有说明,“多个”、“多”的含义是指至少两个。[0109] 应该理解,当元件被称为“固定于”或“设置于”另一个元件,它可以直接在另一个元件上或者可能同时存在居中元件;当一个元件被称为“连接”另一个元件,它可以是直接连接到另一个元件或者可能同时存在居中元件,此外,这里使用的“连接”可以包括无线连接;使用的措辞“和/或”包括一个或更多个相关联的列出项的任一单元和全部组合。[0110] 流程图中或在此以其他方式描述的任何过程或方法描述可以被理解为:表示包括一个或更多个用于实现特定逻辑功能或过程的步骤的可执行指令的代码的模块、片段或部分,并且本申请的优选实施方式的范围包括另外的实现,其中可以不按所示出或讨论的顺序,包括根据所涉及的功能按基本同时的方式或按相反的顺序,来执行功能,这应被本申请的实施例所属技术领域的技术人员所理解。[0111] 应当理解,本申请的各部分可以用硬件、软件、固件或它们的组合来实现。在上述实施方式中,多个步骤或方法可以用存储在存储器中且由合适的指令执行系统执行的软件或固件来实现。例如,如果用硬件来实现,和在另一实施方式中一样,可用本领域公知的下列技术中的任一项或他们的组合来实现:具有用于对数据信号实现逻辑功能的逻辑门电路的离散逻辑电路,具有合适的组合逻辑门电路的专用集成电路,可编程门阵列(PGA),现场可编程门阵列(FPGA)等。[0112] 本技术领域的普通技术人员可以理解实现上述实施例方法携带的全部或部分步骤是可以通过程序来指令相关的硬件完成,所述的程序可以存储于一种计算机可读存储介质中,该程序在执行时,包括方法实施例的步骤之一或其组合。[0113] 此外,在本申请各个实施例中的各功能单元可以集成在一个处理模块中,也可以是各个单元单独物理存在,也可以两个或两个以上单元集成在一个模块中。上述集成的模块既可以采用硬件的形式实现,也可以采用软件功能模块的形式实现。所述集成的模块如果以软件功能模块的形式实现并作为独立的产品销售或使用时,也可以存储在一个计算机可读取存储介质中。[0114] 上述提到的存储介质可以是只读存储器,磁盘或光盘等。[0115] 在本说明书的描述中,参考术语“一个实施例”、“一些实施例”、“示例”、“具体示例”、或“一些示例”等的描述意指结合该实施例或示例描述的具体特征、结构、材料或者特点包含于本申请的至少一个实施例或示例中。在本说明书中,对上述术语的示意性表述不一定指的是相同的实施例或示例。而且,描述的具体特征、结构、材料或者特点可以在任何的一个或多个实施例或示例中以合适的方式结合。[0116] 尽管上面已经示出和描述了本申请的实施例,可以理解的是,上述实施例是示例性的,不能理解为对本申请的限制,本领域的普通技术人员在本申请的范围内可以对上述实施例进行变化、修改、替换和变型。
专利地区:云南
专利申请日期:2022-05-11
专利公开日期:2024-07-26
专利公告号:CN114819377B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477