 产学研创新服务平台(全国)


一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法
更新时间:2026-10-01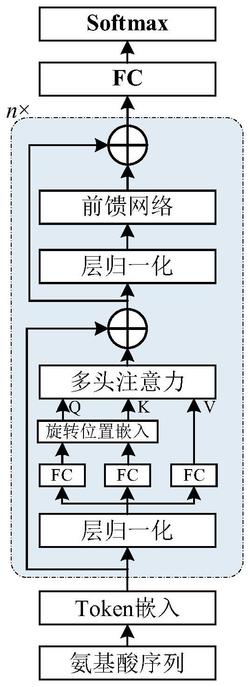 专利申请类型:发明专利;
地区:河南-开封;
源自:开封高价值专利检索信息库;
专利名称:一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法
专利类型:发明专利
专利申请号:CN202311439766.5
专利申请(专利权)人:河南大学
权利人地址:河南省开封市金明区东京大道和金明大道交叉口河南大学(金明校区)
专利发明(设计)人:杨伟,张蕾,刘春,李征
专利摘要:本发明公开一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法。基于transfomer模型,采用自监督学习技术从大规模蛋白质序列数据中学到有用的生物信息。为了降低蛋白质语言模型对显存的需求以方便部署,本发明首先把全连接层的权重矩阵表示成多个小矩阵的Kronecker积的和,然后设计了一种基于Eckhart‑Young定理的奇异值分解方法对小矩阵参数集进行初始化。本发明提出的设计方法可以在维持蛋白质语言模型建模能力的同时显著减少参数的数量。此外,基于本发明获得的预训练蛋白质语言模型可以为蛋白质结构预测、蛋白质折叠识别和蛋白质功能预测等任务提供富含生物信息的嵌入特征。
主权利要求:
1.一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法,其特征在于,包括:步骤1:采用UniRef50数据集作为训练数据,并进行训练数据预处理;
步骤2:基于预处理后的训练数据构建进行自监督学习的小批量数据;
步骤3:设计基于Kronecker积分解的参数高效蛋白质语言模型;所述蛋白质语言模型由多个transformer块堆叠而成,最后一个所述transformer块的输出被送入到全连接层和Softmax以进行多类分类,每个transformer块由一个多头注意力模块和一个前馈模块组成,所述多头注意力模块采用旋转位置嵌入方式为查询和键引入相对位置信息,所述前馈模块包括前馈网络,所述前馈网络通过堆叠两层全连接层和非线性激活函数而构成;
将每个全连接层的权重矩阵表示成多个小矩阵的Kronecker积的和:令 表示全连接层的权重矩阵,则基于Kronecker积将其表示为:其中, 和 是需要学习的参数矩阵,p和q都能被超参数 整除,m表示控制参数矩阵的个数;
步骤4:初始化模型参数;
所述步骤4包括:
对于每个全连接层,首先基于均匀分布 随机生成一个矩阵 然后基于W初始化 和
其中 表示矩阵Frobenius范数的平方;
对上式进行转化:
其中矩阵 是由矩阵W进行permute构造得到,vec(.)表示将矩阵按行优先顺序转化为向量;
根据Eckhart‑Young定理进行求解,若矩阵 的奇异值分解为 其中奇异值为σi,且σ1≥σ2≥…≥σmin{p,q},向量ui、vi分别为σi的左奇异向量、右奇异向量,则矩阵Ai和Bi的初始值为:其中φ(·)表示将向量按行优先顺序转化为对应形状的矩阵;
步骤5:基于自监督学习训练蛋白质语言模型。
2.根据权利要求1所述的一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法,其特征在于,所述训练数据预处理包括:对于长度大于510的蛋白质序列,只保留其前面的510个氨基酸残基,将蛋白质序列中所有的非标准氨基酸B、J、O、U和Z都替换为X。
3.根据权利要求1所述的一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法,其特征在于,所述步骤2包括:首先从训练数据中随机采样N个蛋白质序列形成一个小批次,计算N个蛋白质序列的最大长度maxL,然后在每个蛋白质序列的前、后分别添加标记和,使小批次中最长蛋白质序列的长度达到maxL+2,然后对小批次中的蛋白质序列进行随机屏蔽。
4.根据权利要求1所述的一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法,其特征在于,所述多头注意力模块和前馈模块均采用残差连接和层归一化。
5.根据权利要求1所述的一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法,其特征在于,对于多个transformer块,为了进一步降低参数的数量,所有处于相同位置的全连接层可以共享矩阵参数集
6.根据权利要求1所述的一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法,其特征在于,所述步骤5中,训练蛋白质语言模型的损失函数为:其中 分别表示给定的小批次输入数据 对应的标签矩阵
和二元屏蔽矩阵;Yij和Mij分别为 和 中的元素,Yij表示小批次中第i个序列中的第j个位置对应的标签,Mij=1表示小批次中第i个序列中的第j个位置被屏蔽,Mij=
0表示小批次中第i个序列中的第j个位置未被屏蔽;N表示批处理的大小;L表示最大蛋白质链的长度; 表示X输入到蛋白质语言模型后,模型输出的概率张量。
7.一种基于权利要求1‑6任一项所述方法得出的参数高效蛋白质语言模型在蛋白质结构预测、蛋白质折叠识别和蛋白质功能预测上的应用方法。 说明书 : 一种基于自监督学习和Kronecker积分解的参数高效蛋白质
语言模型设计方法技术领域[0001] 本发明属于计算生物学技术领域,涉及一种蛋白质语言模型设计方法,尤其涉及一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法。背景技术[0002] 蛋白质是由20种氨基酸组成的多功能生物大分子,其在许多生物过程中起着不可替代的作用。随着蛋白质测序技术的飞速发展,蛋白质序列的数量呈现指数级的增长。特别地,大规模蛋白质序列数据中隐含着重要的生物信息和进化相关的信息。近年来,自然语言领域中大模型BERT、RoBERTa、GPT‑3、GPT‑4和ChatGPT等的成功已经证实了自监督学习是一个可以从无标签序列数据中抽取信息的强大工具。如果把氨基酸看作字符或词,把蛋白质序列看作句子,则蛋白质序列数据库可以看作一种生命语言库。因此,自然语言领域中的自监督学习技术可以应用到蛋白质序列数据库以便学习序列数据中的生物信息。[0003] 基于自监督学习技术和transformer模型,目前已经提出了多个预训练的蛋白质语言模型。最具代表性的两个蛋白质语言模型是ESM‑1b[Rives,A.,etal.,Biologicalstructureandfunctionemergefromscalingunsupervisedlearningto250millionproteinsequences.ProceedingsoftheNationalAcademyofSciences,2021.118(15):p.e2016239118.]和ProtTrans[Elnaggar,A.,etal.,ProtTrans:TowardsCrackingtheLanguageofLifesCodeThroughSelf‑SupervisedDeepLearningandHighPerformanceComputing.IEEETransPatternAnalMachIntell,2021.14(8).]。多个实验已经证实从预训练蛋白质语言模型导出的嵌入特征能够显著提升下游任务如蛋白质二级结构预测、蛋白质折叠识别和蛋白质contact预测等的性能。近来,ESM‑2[Lin,Z.,etal.,Evolutionary‑scalepredictionofatomic‑levelproteinstructurewithalanguagemodel.Science,2023.379(6637):p.1123‑1130.]进一步展示了大模型能够为蛋白质结构预测提供较好的嵌入表示。特别地,具有150亿个参数的esm2_t48_15B_UR50D模型大小已经达到了60.52GB。具有32GB显存的TeslaV100也不能独立运行该模型。因此,为了方便部署,有必要在保持建模能力的同时开发出一种参数高效的轻量级蛋白质语言模型以降低对显存等资源的需求。发明内容[0004] 本发明针对现有蛋白质语言模型参数多、对GPU显存要求大和部署不方便的缺点,提出了一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法。该方法通过把全连接层的权重矩阵表示成多个Kronecker积的和,不仅能够保证transformer模型的建模能力,而且能够显著降低模型的参数数量。[0005] 为了实现上述目的,本发明采用以下技术方案:[0006] 本发明一方面提出一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法,包括:[0007] 步骤1:采用UniRef50数据集作为训练数据,并进行训练数据预处理;[0008] 步骤2:基于预处理后的训练数据构建进行自监督学习的小批量数据;[0009] 步骤3:设计基于Kronecker积分解的参数高效蛋白质语言模型;[0010] 步骤4:初始化模型参数;[0011] 步骤5:基于自监督学习训练蛋白质语言模型。[0012] 进一步地,所述训练数据预处理包括:[0013] 对于长度大于510的蛋白质序列,只保留其前面的510个氨基酸残基,将蛋白质序列中所有的非标准氨基酸B、J、O、U和Z都替换为X。[0014] 进一步地,所述步骤2包括:[0015] 首先从训练数据中随机采样N个蛋白质序列形成一个小批次,计算N个蛋白质序列的最大长度maxL,然后在每个蛋白质序列的前、后分别添加标记和,使小批次中最长蛋白质序列的长度达到maxL+2,然后对小批次中的蛋白质序列进行随机屏蔽。[0016] 进一步地,所述蛋白质语言模型由多个transformer块堆叠而成,最后一个所述transformer块的输出被送入到全连接层和Softmax以进行多类分类,每个transformer块由一个多头注意力模块和一个前馈模块组成,所述多头注意力模块采用旋转位置嵌入方式为查询和键引入相对位置信息,所述前馈模块包括前馈网络,所述前馈网络通过堆叠两层全连接层和非线性激活函数而构成。[0017] 进一步地,所述多头注意力模块和前馈模块均采用残差连接和层归一化。[0018] 进一步地,将每个全连接层的权重矩阵表示成多个小矩阵的Kronecker积的和:[0019] 令 表示全连接层的权重矩阵,则基于Kronecker积将其表示为:[0020][0021] 其中, 和 是需要学习的参数矩阵,p和q都能被超参数整除,m表示控制参数矩阵的个数。[0022] 进一步地,对于多个transformer块,为了进一步降低参数的数量,所有处于相同位置的全连接层可以共享矩阵参数集[0023] 进一步地,所述步骤4包括:[0024] 对于每个全连接层,首先基于均匀分布 随机生成一个矩阵然后基于W初始化 和[0025][0026] 其中 表示矩阵Frobenius范数的平方;[0027] 对上式进行转化:[0028][0029] 其中矩阵 是由矩阵W进行permute构造得到,vec(.)表示将矩阵按行优先顺序转化为向量;[0030] 根据Eckhart‑Young定理对上述优化问题进行求解,若矩阵 的奇异值分解为其中奇异值为σi,且σ1≥σ2≥…≥σmin{p,q},向量ui、vi分别为σi的左奇异向量、右奇异向量,则矩阵Ai和Bi的初始值为:[0031][0032] 其中φ(·)表示将向量按行优先顺序转化为对应形状的矩阵。[0033] 进一步地,所述步骤5中,训练蛋白质语言模型的损失函数为:[0034][0035] 其中 分别表示给定的小批次输入数据 对应的标签矩阵和二元屏蔽矩阵;Yij和Mij分别为 和 中的元素,Yij表示小批次中第i个序列中的第j个位置对应的标签,Mij=1表示小批次中第i个序列中的第j个位置被屏蔽,Mij=0表示小批次中第i个序列中的第j个位置未被屏蔽;N表示批处理的大小;L表示最大蛋白质链的长度; 表示X输入到蛋白质语言模型后,模型输出的概率张量。[0036] 本发明还提出一种基于上述任一所述方法得出的参数高效蛋白质语言模型在蛋白质结构预测、蛋白质折叠识别和蛋白质功能预测上的应用。[0037] 与现有技术相比,本发明具有的有益效果:[0038] 本发明公开了一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法。基于transfomer模型的强大建模能力,该方法采用自监督学习技术能够从大规模蛋白质序列数据中学到有用的生物信息。特别地,为了降低蛋白质语言模型对显存的需求以方便部署,本发明首先把全连接层的权重矩阵表示成多个小矩阵的Kronecker积的和,然后设计了一种基于Eckhart‑Young定理的奇异值分解方法对小矩阵参数集进行初始化。本发明提出的设计方法可以在维持蛋白质语言模型建模能力的同时显著减少参数的数量。此外,基于本发明获得的预训练蛋白质语言模型可以为蛋白质结构预测、蛋白质折叠识别和蛋白质功能预测等任务提供富含生物信息的嵌入特征。附图说明[0039] 图1为本发明实施例一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法的基本流程图;[0040] 图2为本发明实施例的参数高效蛋白质语言模型的网络架构示意图。具体实施方式[0041] 下面结合附图和具体的实施例对本发明做进一步的解释说明:[0042] 如图1所示,一种基于自监督学习和Kronecker积分解的参数高效蛋白质语言模型设计方法,包括:[0043] 步骤1:训练数据预处理。本发明采用非冗余蛋白质序列数据集UniRef50(https://ftp.uniprot.org/pub/databases/uniprot/uniref/uniref50/uniref50.fasta.gz)作为训练数据,其是基于50%的序列一致性阈值对UniRef100数据集进行聚类获得的。目前,UniRef50数据集包含6000多万个蛋白质序列,每个序列是由20种标准氨基酸(A、C、D、E、F、G、H、I、K、L、M、N、P、Q、R、S、T、V、W和Y)和6种非标准氨基酸(B、J、O、U、X和Z)组成的。蛋白质序列的长度可以达到几十、几百、几千甚至上万。为了训练蛋白质语言模型,需要对UniRef50数据集进行预处理。首先,对于长度大于510的蛋白质序列,只保留其前面的510个氨基酸残基。这是因为较长的序列不仅会要求较大的显存,而且会增加前向传播和反向传播的时间。其次,将蛋白质序列中所有的非标准氨基酸B、J、O、U和Z都替换为X。这是因为非标准氨基酸出现的次数很少,把所有非标准氨基酸合并成一个token类型并不会降低模型的性能。[0044] 步骤2:构建进行自监督学习的mini‑batch。为了基于预处理后的UniRef50数据集进行自监督学习,需要首先从数据集中随机采样N个蛋白质序列形成一个mini‑batch,然后对mini‑batch中的蛋白质序列进行随机屏蔽。自监督学习的目标是基于氨基酸序列中未屏蔽的上下文信息预测被屏蔽的氨基酸类别。特别地,mini‑batch要求所有的蛋白质序列具有相同的长度。为此,首先计算N个蛋白质序列的最大长度maxL,然后在每个蛋白质序列的前面和后面分别添加token和。这样mini‑batch中最长蛋白质序列的长度达到了maxL+2。对于其他的蛋白质序列,我们对其填充多个
以使其长度也达到maxL+2。基于步骤2的设置保证了mini‑batch长度维度的最大值是512。此外,对于每个蛋白质序列,本发明随机选择20%的位置进行屏蔽。特别地,若被屏蔽的位置对应的token不是氨基酸,则不进行屏蔽。对于被屏蔽的氨基酸,在90%的情况下其被替换为,在10%的情况下其被与其具有不同类型的随机氨基酸取代。[0045] 步骤3:设计基于Kronecker积分解的参数高效蛋白质语言模型。图2给出了本发明采用的蛋白质语言模型网络架构。从图2中可以看出,蛋白质语言模型主要由n个transformer块堆叠而成。每个transformer块由一个多头注意力模块和一个前馈模块组成。对于多头注意力模块,其采用旋转位置嵌入方式为查询Q和键K引入相对位置信息。特别地,与其他位置嵌入方式相比,旋转位置嵌入具有更强的长度外推能力。对于前馈模块,其中的前馈网络可以通过堆叠两层全连接层和非线性激活函数而构成。此外,多头注意力模块和前馈模块都采用了残差连接和层归一化。最后一个transformer块的输出被送入到全连接层FC和Softmax以进行21类的多类分类。显然,蛋白质语言模型的参数主要集中在全连接层中。[0046] 为了获得参数高效的蛋白质语言模型,本发明将每个全连接层的权重矩阵表示成多个小矩阵的Kronecker积的和。这种表示的优点能在保持模型建模能力的同时显著降低模型的参数量。具体地,令 表示某个全连接层的权重矩阵,则基于Kronecker积可以将其表示为:[0047][0048] 其中, 和 是需要学习的参数矩阵。这里,我们假定p和q都能被超参数 整除。例如,当p和q的值为1024,而r和m的值为32时,则通过Kronecker积分解可以将权重矩阵W的参数量减少为原来的1/16。此外,通过参数共享可以进一步降低蛋白质语言模型的参数数量。对于n个transformer块,所有处于相同位置的全连接层可以共享矩阵参数集 这样近乎可以减少一半的参数,每个全连接层只需要保存和学习矩阵参数集[0049] 步骤4:初始化模型参数。对于设计的参数高效蛋白质语言模型,其嵌入层和归一化层中的参数可以采用深度学习框架PyTorch或TensorFlow中的默认方法进行初始化。而对于引入Kronecker积分解后的全连接层,需要为矩阵参数集 和 设计一种有效的初始化方法。为此,对于每个全连接层,本发明首先基于均匀分布 随机生成一个矩阵 然后基于W初始化 和 具体地,参数矩阵组 的初始化可以形式为如下的广义Kronecker分解问题:[0050][0051] 其中 表示矩阵Frobenius范数的平方。对于上式,其可进一步转化为下面的形式:[0052][0053] 其中矩阵 是由矩阵W进行permute构造得到,vec(.)表示将矩阵按行优先顺序转化为向量。[0054] 根据Eckhart‑Young定理对上述优化问题进行求解,若矩阵 的奇异值分解为其中奇异值为σ1≥σ2≥…≥σmin{p,q},则矩阵Ai和Bi的初始值为:[0055][0056] 其中φ(·)表示将向量按行优先顺序转化为对应形状的矩阵。对于共享矩阵参数集 的情形,可以分别求出 的初始值,然后基于共享的次数求平均。[0057] 步骤5:基于自监督学习训练蛋白质语言模型。对于给定的mini‑batch输入数据令其对应的标签矩阵和二元屏蔽矩阵分别为 和 其中Yij∈[0,1,...,20],Mij=1表示mini‑batch中第i个序列中的第j个位置被屏蔽;否则的话Mij=0。假定X输入到蛋白质语言模型后,模型输出的概率张量为 则训练蛋白质语言模型的损失函数可以定义为:[0058][0059] 基于该损失函数,我们采用谷歌公司最近提出的优化器Lion训练蛋白质语言模型。与优化器AdamW相比,Lion不仅需要较少的显存,而且具有更好的泛化能力和更快的计算速度。训练时,mini‑batch的大小设置为2048、学习率设置为1e‑5。为了获得不同大小的参数高效蛋白质语言模型,可以分别基于m等于16、32、64和128进行训练。对于通过训练获得的模型,其最后的两层FC和Softmax将被删除。删除最后两层后的模型通常称为预训练的蛋白质语言模型,其可用于许多下游任务如蛋白质三级结构预测、蛋白质二级结构预测、蛋白质折叠识别、蛋白质定位预测和蛋白质功能预测等。[0060] 本发明还提出一种基于上述任一所述方法得出的参数高效蛋白质语言模型在蛋白质结构预测、蛋白质折叠识别和蛋白质功能预测上的应用。[0061] 以上所示仅是本发明的优选实施方式,应当指出,对于本技术领域的普通技术人员来说,在不脱离本发明原理的前提下,还可以做出若干改进和润饰,这些改进和润饰也应视为本发明的保护范围。
专利地区:河南
专利申请日期:2023-10-31
专利公开日期:2024-09-13
专利公告号:2024-09-13
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西弈聪软件信息技术股份有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




