 产学研创新服务平台(全国)


基于AI人脸识别的直播换脸系统及方法发明专利
更新时间:2026-01-11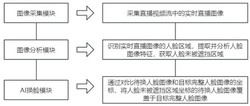 专利申请类型:发明专利;
地区:辽宁-锦州;
源自:锦州高价值专利检索信息库;
专利名称:基于AI人脸识别的直播换脸系统及方法
专利类型:发明专利
专利申请号:CN202411029599.1
专利申请(专利权)人:辽宁明远和邦跨境电商有限公司
权利人地址:辽宁省锦州市松山新区大学科技园黄海大街46-2号3层
专利发明(设计)人:张丹峰,娄明,庄文祥,侯亚群,于亭亭
专利摘要:本发明涉及一种基于AI人脸识别的直播换脸系统及方法,通过人脸检测算法定位实时直播图像的人脸区域,同时识别人脸区域的关键特征点,获得人脸区域图像;将所获得的每一帧人脸区域图像缩放到相同的尺寸大小;以人脸区域图像中心作为原点,建立图像直角坐标系;将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域;通过排除人脸遮挡区域的坐标,确定人脸未被遮挡区域;通过对比待换人脸图像和目标完整人脸图像的坐标,将人脸未被遮挡区域坐标的待换人脸图像覆盖于目标完整人脸图像。本发明解决了换脸技术中出现遮挡物后依旧难以保留人脸特效,导致换脸效果差的问题。
主权利要求:
1.一种基于AI人脸识别的直播换脸系统,其特征在于:包括图像采集模块、图像分析模块和AI换脸模块,所述图像采集模块、图像分析模块和AI换脸模块通信连接,其中:所述图像采集模块,用于采集直播视频流中的实时直播图像;
所述图像分析模块,用于识别实时直播图像的人脸区域,提取并分析人脸图像特征,获取人脸未被遮挡区域,包括以下步骤:S1、人脸检测:采用人脸检测算法定位实时直播图像的人脸区域,同时识别人脸区域的关键特征点,获得人脸区域图像,所述关键特征点包括眼睛、鼻子、嘴巴、耳朵、脸部和头发;
S2、图像尺寸标准化:将所获得的每一帧人脸区域图像缩放到相同的尺寸大小;
S3、建立图像坐标系:以人脸区域图像中心作为原点,建立图像直角坐标系;
S4、识别人脸遮挡特征:将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域,所述目标完整人脸图像是指未被遮挡时的人脸区域图像;所述目标完整人脸图像,配置为在直播流中距离出现遮挡人脸情况前最近一帧的图像;
S5、确定人脸未被遮挡区域:通过排除人脸遮挡区域的坐标,确定人脸未被遮挡区域;
所述AI换脸模块,用于通过对比待换人脸图像和目标完整人脸图像的坐标,将人脸未被遮挡区域坐标的待换人脸图像覆盖于目标完整人脸图像;其中,将所获得的每一帧人脸区域图像缩放到相同的尺寸大小,将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比;
所述AI换脸模块,还应用了3D处理技术,具体为建立目标人脸的三维坐标,当直播人员发生转头或转脸时,待换人脸图像通过跟踪目标人脸的三维坐标对目标完整人脸图像进行换脸操作,包括以下步骤:T1、基于检测得到人脸区域的关键特征点,使用3D建模技术构建目标人脸的三维模型;
T2、实时跟踪目标人脸,并预估其在三维空间中的姿态变化;
T3、待换人脸图像根据目标人脸的三维坐标和预估姿态进行相应处理,以适应目标人脸的形状和角度;
T4、结合待换人脸图像和目标完整人脸图像的三维坐标信息,进行换脸操作;
T5、对换脸结果进行细节调整和优化,包括颜色、光照和纹理的调整。
2.根据权利要求1所述的一种基于AI人脸识别的直播换脸系统,其特征在于:步骤S1中,所述人脸检测算法,配置为Viola‑Jones算法、卷积神经网络、HOG算法、MTCNN算法或YOLO算法。
3.根据权利要求1所述的一种基于AI人脸识别的直播换脸系统,其特征在于:步骤S2中,所述将所获得的每一帧人脸区域图像缩放到相同的尺寸大小,还记录了对图像的缩放比例。
4.根据权利要求1所述的一种基于AI人脸识别的直播换脸系统,其特征在于:步骤S4中,所述将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域,包括以下步骤:S41、特征提取:对人脸区域图像和完整人脸图像进行图像特征提取,建立特征向量表示每个坐标点;
S42、特征比较:将人脸区域图像中的特征数据与完整人脸图像中对应坐标的特征数据进行比较,计算特征数据之间的差异程度;
S43、遮挡区域检测:若坐标点的特征数据差异超过设定阈值,则认定坐标点存在遮挡;
S44、遮挡区域标记:标记检测到的遮挡区域,通过在图像上绘制边界框或者在坐标点附近添加标记来表示。
5.根据权利要求4所述的一种基于AI人脸识别的直播换脸系统,其特征在于:步骤S41中,所述图像特征,包括每个坐标点的颜色值、亮度值和梯度信息。
6.根据权利要求4所述的一种基于AI人脸识别的直播换脸系统,其特征在于:步骤S42中,所述计算特征数据之间的差异程度,具体通过计算人脸区域图像中的特征数据与完整人脸图像中对应坐标的特征数据之间的欧氏距离。
7.根据权利要求1所述的一种基于AI人脸识别的直播换脸系统,其特征在于:所述AI换脸模块,还配置特征融合技术。
8.根据权利要求7所述的一种基于AI人脸识别的直播换脸系统,其特征在于:所述特征融合技术,包括点对点对准、纹理融合、光照一致性处理、骨骼动画融合和表情融合。
9.一种基于AI人脸识别的直播换脸方法,应用于如权利要求1‑8任一项所述的一种基于AI人脸识别的直播换脸系统,包括以下步骤:采集直播视频流中的实时直播图像;
采用人脸检测算法定位实时直播图像的人脸区域,同时识别人脸区域的关键特征点,获得人脸区域图像,所述关键特征点包括眼睛、鼻子、嘴巴、耳朵、脸部和头发;
将所获得的每一帧人脸区域图像缩放到相同的尺寸大小;
以人脸区域图像中心作为原点,建立图像直角坐标系;
将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域,所述目标完整人脸图像是指未被遮挡时的人脸区域图像;
通过排除人脸遮挡区域的坐标,确定人脸未被遮挡区域;
通过对比待换人脸图像和目标完整人脸图像的坐标,将人脸未被遮挡区域坐标的待换人脸图像覆盖于目标完整人脸图像。 说明书 : 基于AI人脸识别的直播换脸系统及方法技术领域[0001] 本发明属于人工智能技术领域,涉及一种基于AI人脸识别的直播换脸系统及方法。背景技术[0002] 换脸技术是一种人工智能图像处理技术,能够将一个人的脸部信息提取出来,然后将其与另一个人的脸部信息进行匹配,从而生成一个新的具有两者特征结合的人脸图像。将换脸技术应用于一些娱乐直播中,可以给观众带来新奇的体验。[0003] 目前,大部分的直播换脸更多是将新生成的人脸直接覆盖在目标人脸中,然而这种方式在出现遮挡物挡到部分人脸后,往往会由于识别不到完整的目标人脸而取消特效,导致直播换脸的效果大大降低。因此,如何在出现遮挡物后依旧保留剩余人脸部分的特效成为解决问题的关键。发明内容[0004] 为解决现有技术中存在的上述问题,本发明提供了一种基于AI人脸识别的直播换脸系统及方法。[0005] 本发明的目的可以通过以下技术方案实现:[0006] 第一方面,本申请提供了一种基于AI人脸识别的直播换脸系统,包括图像采集模块、图像分析模块和AI换脸模块,所述图像采集模块、图像分析模块和AI换脸模块通信连接,其中:[0007] 所述图像采集模块,用于采集直播视频流中的实时直播图像;[0008] 所述图像分析模块,用于识别实时直播图像的人脸区域,提取并分析人脸图像特征,获取人脸未被遮挡区域;[0009] 所述AI换脸模块,用于通过对比待换人脸图像和目标完整人脸图像的坐标,将人脸未被遮挡区域坐标的待换人脸图像覆盖于目标完整人脸图像。[0010] 进一步地,所述AI换脸模块,还应用了3D处理技术,具体为建立目标人脸的三维坐标,当直播人员发生转头或转脸时,待换人脸图像通过跟踪目标人脸的三维坐标对目标完整人脸图像进行换脸操作,包括以下步骤:[0011] T1、基于检测得到人脸区域的关键特征点,使用3D建模技术构建目标人脸的三维模型;[0012] T2、实时跟踪目标人脸,并预估其在三维空间中的姿态变化;[0013] T3、待换人脸图像根据目标人脸的三维坐标和预估姿态进行相应处理,以适应目标人脸的形状和角度;[0014] T4、结合待换人脸图像和目标完整人脸图像的三维坐标信息,进行换脸操作;[0015] T5、对换脸结果进行细节调整和优化,包括颜色、光照和纹理的调整。[0016] 进一步地,所述识别实时直播图像的人脸区域,提取并分析人脸图像特征,获取人脸未被遮挡区域,包括以下步骤:[0017] S1、人脸检测:采用人脸检测算法定位实时直播图像的人脸区域,同时识别人脸区域的关键特征点,获得人脸区域图像,所述关键特征点包括眼睛、鼻子、嘴巴、耳朵、脸部和头发;[0018] S2、图像尺寸标准化:将所获得的每一帧人脸区域图像缩放到相同的尺寸大小;[0019] S3、建立图像坐标系:以人脸区域图像中心作为原点,建立图像直角坐标系;[0020] S4、识别人脸遮挡特征:将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域,所述目标完整人脸图像是指未被遮挡时的人脸区域图像;[0021] S5、确定人脸未被遮挡区域:通过排除人脸遮挡区域的坐标,确定人脸未被遮挡区域。[0022] 进一步地,步骤S1中,所述人脸检测算法,配置为Viola‑Jones算法、卷积神经网络、HOG算法、MTCNN算法或YOLO算法。[0023] 进一步地,步骤S2中,所述将所获得的每一帧人脸区域图像缩放到相同的尺寸大小,还记录了对图像的缩放比例。[0024] 进一步地,步骤S4中,所述目标完整人脸图像,配置为在直播流中距离出现遮挡人脸情况前最近一帧的图像。[0025] 进一步地,步骤S4中,所述将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域,包括以下步骤:[0026] S41、特征提取:对人脸区域图像和完整人脸图像进行图像特征提取,建立特征向量表示每个坐标点;[0027] S42、特征比较:将人脸区域图像中的特征数据与完整人脸图像中对应坐标的特征数据进行比较,计算特征数据之间的差异程度;[0028] S43、遮挡区域检测:若坐标点的特征数据差异超过设定阈值,则认定坐标点存在遮挡;[0029] S44、遮挡区域标记:标记检测到的遮挡区域,通过在图像上绘制边界框或者在坐标点附近添加标记来表示。[0030] 进一步地,步骤S41中,所述图像特征,包括每个坐标点的颜色值、亮度值和梯度信息。[0031] 进一步地,步骤S42中,所述计算特征数据之间的差异程度,具体通过计算人脸区域图像中的特征数据与完整人脸图像中对应坐标的特征数据之间的欧氏距离。[0032] 进一步地,所述AI换脸模块,配置特征融合技术。[0033] 进一步地,所述特征融合技术,包括点对点对准、纹理融合、光照一致性处理、骨骼动画融合和表情融合。[0034] 第二方面,本申请提供了一种基于AI人脸识别的直播换脸方法,应用于如上所述的一种基于AI人脸识别的直播换脸系统,包括以下步骤:[0035] 采集直播视频流中的实时直播图像;[0036] 采用人脸检测算法定位实时直播图像的人脸区域,同时识别人脸区域的关键特征点,获得人脸区域图像,所述关键特征点包括眼睛、鼻子、嘴巴、耳朵、脸部和头发;[0037] 将所获得的每一帧人脸区域图像缩放到相同的尺寸大小;[0038] 以人脸区域图像中心作为原点,建立图像直角坐标系;[0039] 将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域,所述目标完整人脸图像是指未被遮挡时的人脸区域图像;[0040] 通过排除人脸遮挡区域的坐标,确定人脸未被遮挡区域;[0041] 通过对比待换人脸图像和目标完整人脸图像的坐标,将人脸未被遮挡区域坐标的待换人脸图像覆盖于目标完整人脸图像。[0042] 本发明的有益效果:[0043] 通过采集直播视频流中的实时直播图像;采用人脸检测算法定位实时直播图像的人脸区域,同时识别人脸区域的关键特征点,获得人脸区域图像;将所获得的每一帧人脸区域图像缩放到相同的尺寸大小;以人脸区域图像中心作为原点,建立图像直角坐标系;将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域;通过排除人脸遮挡区域的坐标,确定人脸未被遮挡区域;通过对比待换人脸图像和目标完整人脸图像的坐标,将人脸未被遮挡区域坐标的待换人脸图像覆盖于目标完整人脸图像。本发明解决了换脸技术中出现遮挡物后依旧难以保留人脸特效,导致换脸效果差的问题。附图说明[0044] 为了便于本领域技术人员理解,下面结合附图对本发明作进一步的说明。[0045] 图1为本发明中一种基于AI人脸识别的直播换脸系统的结构图。具体实施方式[0046] 为更进一步阐述本发明为实现预定发明目的所采取的技术手段及功效,以下结合附图及较佳实施例,对依据本发明的具体实施方式、结构、特征及其功效,详细说明如后。[0047] 请参阅图1,第一方面,本申请提供了一种基于AI人脸识别的直播换脸系统,包括图像采集模块、图像分析模块和AI换脸模块,所述图像采集模块、图像分析模块和AI换脸模块通信连接,其中:[0048] 所述图像采集模块,用于采集直播视频流中的实时直播图像;[0049] 在本实施例中,图像采集模块通常是直播换脸系统中的一个重要组成部分,它的作用是从直播视频流中实时捕获图像。通过这个模块,系统能够持续地获取直播视频中的实时图像数据,为后续的人脸识别、特征提取和换脸处理提供数据基础。这个模块需要快速、准确地捕获视频流中的图像,以确保换脸效果的实时性与流畅性。[0050] 所述图像分析模块,用于识别实时直播图像的人脸区域,提取并分析人脸图像特征,获取人脸被遮挡的区域;[0051] 在本实施例中,通过图像分析模块能够准确地定位人脸位置,分析人脸特征,并推断出可能被遮挡的部分。这些功能使系统能够更全面地理解人脸信息,即使部分人脸被遮挡也能够处理。这种综合分析为系统在人脸遮挡情况下提供了更多处理和修正的可能性,提高了系统的鲁棒性和表现效果。这样,即使人脸被遮挡,系统仍能有效地应用特效,保持换脸效果的稳定性和准确性。[0052] 进一步地,所述识别实时直播图像的人脸区域,提取并分析人脸图像特征,获取人脸被遮挡的区域,包括以下步骤:[0053] S1、人脸检测:采用人脸检测算法定位实时直播图像的人脸区域,同时识别人脸区域的关键特征点,获得人脸区域图像,所述关键特征点包括眼睛、鼻子、嘴巴、耳朵、脸部和头发;[0054] 在本实施例中,人脸检测算法可帮助系统在实时直播图像中识别人脸,可用于人脸检测算法包括Viola‑Jones算法、卷积神经网络(CNN)、HOG算法、MTCNN算法和YOLO算法。Viola‑Jones算法使用Haar‑like特征来检测人脸,它首先将图像转换为积分图像以加速计算,然后通过AdaBoost算法训练级联的弱分类器,以逐步减少假阳率,最终确定人脸区域;CNN是一种深度学习结构,通过卷积层、池化层和全连接层来学习特征,在人脸检测中,CNN可以通过训练大量数据集来学习图像特征,从而实现准确的人脸检测;HOG算法通过计算图像中局部区域的梯度直方图来描述图像特征,在人脸检测中,这些梯度直方图可以用来表示人脸的形状和边缘,从而检测人脸区域;MTCNN是一种联合检测网络,包含了三个级联的CNN模型,分别用于粗略人脸框检测、人脸关键点定位和人脸框的精细调整,它能够同时完成人脸检测和人脸关键点定位任务;YOLO是一种实时目标检测算法,能够快速而准确地检测图像中的多个物体,在人脸检测中,YOLO可以用来定位整个图像中的人脸并标注其位置。[0055] S2、图像尺寸标准化:将所获得的每一帧人脸区域图像缩放到相同的尺寸大小;[0056] 进一步地,步骤S2中,所述将所获得的每一帧人脸区域图像缩放到相同的尺寸大小,还记录了对图像的缩放比例。[0057] 在实际工作中,人脸大小会随着主播距离镜头的远近而发生变化,这会导致所获得的人脸区域图像难以比较,因此本实施例对图像进行标准化处理,即将所获得的每一帧人脸区域图像缩放到相同的尺寸大小,并记录缩放比例,记录缩放比例是为了后续处理中能够按照缩放比例对缩放过的图像进行还原,使处理的图像符合实际直播中的大小。[0058] S3、建立图像坐标系:以人脸区域图像中心作为原点,建立图像直角坐标系;[0059] 需要注意的是,建立图像直角坐标系是为了使人脸各区域赋予坐标值,使系统能够快速定位到人脸各区域,对人脸被遮挡的部分进行处理。[0060] 建立图像直角坐标系时,通常以人脸区域图像的中心点为原点,确定水平和垂直方向的坐标轴。首先,确定人脸区域的中心坐标,可以通过人脸检测和关键点定位技术来获取;然后,将人脸中心点作为坐标系的原点,通常选择人脸的水平中轴线作为坐标系的水平方向,垂直于中轴线的方向作为垂直方向,分别构建x和y坐标轴;接着,为了实现对人脸各区域的定位,可以将人脸图像分割成不同的区域,如左眼、右眼、鼻子、嘴巴等,并为每个区域赋予具体的坐标值。通过坐标系,可以准确记录每个区域的位置信息,方便系统对人脸特征进行分析和处理。在处理人脸被遮挡的情况下,建立坐标系可以帮助系统识别遮挡区域的位置,并对其进行处理。建立图像直角坐标系为系统提供了方便快捷的定位和处理手段,有助于提高人脸识别和图像处理的准确性和效率。[0061] S4、识别人脸遮挡特征:将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域,所述目标完整人脸图像是指未被遮挡时的人脸区域图像;[0062] 在检测人脸遮挡时,将被遮挡的人脸图像与最近帧中未被遮挡的人脸图像进行比较,这样可以更准确地确定遮挡区域。通过比较接近的当前帧的未遮挡人脸图像,可以更有效地检测出遮挡部分,并有助于实时处理和修复遮挡区域,提高人脸识别和图像质量。[0063] 当进行人脸遮挡区域检测时,首先需要在人脸区域图像和完整人脸图像中获取特征数据。这些特征数据可能包括人脸关键点的位置、颜色分布、纹理信息等。通过比较这些特征数据,可以确定人脸区域图像中的遮挡区域。具体而言,以下是详细步骤:[0064] S41、特征提取:对人脸区域图像和完整人脸图像进行特征提取,提取每个坐标点的颜色值、亮度值、梯度信息等特征,建立特征向量表示每个坐标点;[0065] S42、特征比较:将人脸区域图像中的特征数据与完整人脸图像中对应坐标的特征数据进行比较,例如欧氏距离、相似度度量等,计算特征数据之间的差异程度;[0066] S43、遮挡区域检测:若某个坐标点的特征数据差异超过设定阈值,则认定坐标点存在遮挡;[0067] S44、遮挡区域标记:标记检测到的遮挡区域,通过在图像上绘制边界框或者在坐标点附近添加标记来表示。[0068] S5、确定人脸未被遮挡区域:通过排除人脸遮挡区域的坐标,确定人脸未被遮挡区域。[0069] 进一步地,所述目标完整人脸图像,配置为在直播流中距离出现遮挡人脸情况前最近一帧的图像。[0070] 所述AI换脸模块,用于通过对比待换人脸图像和目标完整人脸图像的坐标,将人脸未被遮挡区域坐标的待换人脸图像覆盖于目标完整人脸图像。[0071] AI换脸模块通常可以根据人脸未被遮挡的区域,将对应坐标的待换人脸图像覆盖在原始人脸图像的对应区域,从而实现人脸换脸的效果。通过对齐待换人脸图像和原始图像的关键点坐标,以及通过特征融合等技术,可以实现自然流畅的换脸效果。[0072] 进一步地,所述AI换脸模块,还应用了3D处理技术,具体为建立目标人脸的三维坐标,当直播人员发生转头或转脸时,待换人脸图像通过跟踪目标人脸的三维坐标对目标完整人脸图像进行换脸操作,包括以下步骤:[0073] T1、基于检测得到人脸区域的关键特征点,使用3D建模技术构建目标人脸的三维模型;通过这一步骤,系统可以获得目标人脸在三维空间中的几何形状和位置信息。[0074] T2、实时跟踪目标人脸,并预估其在三维空间中的姿态变化;通过持续的跟踪和姿态估计,系统能够准确捕捉目标人脸的动态变化。[0075] T3、待换人脸图像根据目标人脸的三维坐标和预估姿态进行相应处理,以适应目标人脸的形状和角度;所述处理包括对待换脸图像进行变形、旋转、缩放等操作,使其与目标人脸更好地匹配。[0076] T4、结合待换人脸图像和目标完整人脸图像的三维坐标信息,进行换脸操作;通过融合两者的特征,实现将待换脸图像自然地嵌入到目标人脸的位置上。[0077] T5、对换脸结果进行细节调整和优化,包括颜色、光照和纹理的调整。[0078] 结合3D处理技术的AI换脸操作在技术效果上具有显著优势。首先,通过建立目标人脸的三维模型,可以更精确地捕捉人脸的形状、轮廓和特征,实现更高逼真度的换脸效果;其次,实时跟踪和姿态估计能够确保换脸效果在目标人脸变化姿势时依然稳定自然;同时,细节优化的处理可以提升换脸效果的细腻度和真实感,包括光影效果、纹理细节等方面。这些优势共同作用下,结合3D处理技术的AI换脸操作不仅能够提升视觉效果的逼真度和吸引力,还能满足用户对于更多创意和互动体验的需求,为视频制作和直播场景带来更丰富多彩的可能性和体验。[0079] 进一步地,所述AI换脸模块,配置特征融合技术。[0080] 进一步地,所述特征融合技术,包括点对点对准、纹理融合、光照一致性处理、骨骼动画融合和表情融合。[0081] 特征融合是一种人工智能技术,常用于图像处理和计算机视觉领域。在换脸等任务中,特征融合技术通过将不同人脸的特征融合在一起,实现自然的合成效果。这种技术通常会分析人脸的特征点、纹理、光照等信息,然后将待融合的人脸特征与原始人脸特征进行匹配和融合。通过特征融合,可以实现人脸换脸等任务中人脸合成的效果,使合成后的图像看起来更加逼真和符合视觉感知。[0082] 特征融合技术主要包括以下几种方法:[0083] 1)点对点对准:通过将待换人脸图像和原始人脸图像进行点对点对准(如面部关键点对齐),确保两者的对应特征点位置准确匹配;[0084] 2)纹理融合:将待换人脸图像的纹理信息融合到原始人脸图像中,以呈现更逼真的合成效果;[0085] 3)光照一致性处理:考虑人脸合成中的光照条件,对合成后的图像进行光照一致性处理,使得合成效果更加真实;[0086] 4)骨骼动画融合:在视频换脸等任务中,结合骨骼动画技术,使待换人脸图像的表情和动作与原始人脸图像保持一致;[0087] 5)表情融合:根据原始人脸的表情特征,将待换人脸图像的表情特征融合进去,实现表情自然过渡。[0088] 这些特征融合方法通常结合使用,以实现更加逼真和自然的人脸合成效果。在应用中,根据具体需求选择合适的特征融合方法,可以提高合成效果的质量和逼真度。[0089] 第二方面,本申请提供了一种基于AI人脸识别的直播换脸方法,应用于如上所述的一种基于AI人脸识别的直播换脸系统,包括以下步骤:[0090] 采集直播视频流中的实时直播图像;[0091] 采用人脸检测算法定位实时直播图像的人脸区域,同时识别人脸区域的关键特征点,获得人脸区域图像,所述关键特征点包括眼睛、鼻子、嘴巴、耳朵、脸部和头发;[0092] 将所获得的每一帧人脸区域图像缩放到相同的尺寸大小;[0093] 以人脸区域图像中心作为原点,建立图像直角坐标系;[0094] 将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域,所述目标完整人脸图像是指未被遮挡时的人脸区域图像;[0095] 通过排除人脸遮挡区域的坐标,确定人脸未被遮挡区域;[0096] 通过对比待换人脸图像和目标完整人脸图像的坐标,将人脸未被遮挡区域坐标的待换人脸图像覆盖于目标完整人脸图像。[0097] 本发明的有益效果:[0098] 通过采集直播视频流中的实时直播图像;采用人脸检测算法定位实时直播图像的人脸区域,同时识别人脸区域的关键特征点,获得人脸区域图像;将所获得的每一帧人脸区域图像缩放到相同的尺寸大小;以人脸区域图像中心作为原点,建立图像直角坐标系;将人脸区域图像各坐标的特征数据与目标完整人脸图像进行对比,得到特征数据出现差异的坐标,确定为人脸遮挡区域;通过排除人脸遮挡区域的坐标,确定人脸未被遮挡区域;通过对比待换人脸图像和目标完整人脸图像的坐标,将人脸未被遮挡区域坐标的待换人脸图像覆盖于目标完整人脸图像。本发明解决了换脸技术中出现遮挡物后依旧难以保留人脸特效,导致换脸效果差的问题。[0099] 以上所述,仅是本发明的较佳实施例而已,并非对本发明作任何形式上的限制,虽然本发明已以较佳实施例揭示如上,然而并非用以限定本发明,任何本领域技术人员,在不脱离本发明技术方案范围内,当可利用上述揭示的技术内容做出些许更动或修饰为等同变化的等效实施例,但凡是未脱离本发明技术方案内容,依据本发明的技术实质对以上实施例所作的任何简介修改、等同变化与修饰,均仍属于本发明技术方案的范围内。
专利地区:辽宁
专利申请日期:2024-07-30
专利公开日期:2024-10-01
专利公告号:2024-10-01
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。




