产学研创新服务平台(全国)


音频处理方法及相关装置实用新型专利
更新时间:2026-11-01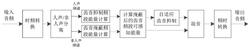 专利申请类型:实用新型专利;
地区:广东-深圳;
源自:深圳高价值专利检索信息库;
专利名称:音频处理方法及相关装置
专利类型:实用新型专利
专利申请号:CN202310990548.4
专利申请(专利权)人:荣耀终端有限公司
权利人地址:广东省深圳市福田区香蜜湖街道东海社区红荔西路8089号深业中城6号楼A单元3401
专利发明(设计)人:发明人:许剑峰
专利摘要:本申请实施例提供的音频处理方法及相关装置,涉及终端技术领域。方法包括:电子设备获取第一音频信号;电子设备分离出第一音频信号的人声成分和非人声成分;电子设备对人声成分中的齿音进行能量抑制;电子设备根据非人声成分与齿音抑制后的人声成分进行混音,得到第二音频信号。这样,可以实现对齿音的抑制,同时还可以避免对非人声成分的损伤,从而减少音色失真,提升用户体验。
主权利要求:
1.一种音频处理方法,其特征在于,所述方法包括:
电子设备获取第一音频信号;
所述电子设备分离出所述第一音频信号的人声成分和非人声成分;
所述电子设备对所述人声成分中的齿音进行能量抑制;
所述电子设备根据所述非人声成分与齿音抑制后的人声成分进行混音,得到第二音频信号;
所述电子设备对所述人声成分中的齿音进行能量抑制,包括:
所述电子设备根据可感知能量EV’(i)和所述人声成分的频谱,对所述人声成分中的齿音进行能量抑制;
其中,所述可感知能量EV’(i)为所述非人声成分中齿音频带的能量对所述人声成分中齿音频带的能量进行掩蔽后,所述第一音频信号中齿音频带的能量;所述齿音频带包括多个齿音子频带,i为齿音子频带序号;所述可感知能量EV’(i)与第一能量EV(i)成正比,所述可感知能量EV’(i)与第二能量EU(i)成反比,所述第一能量EV(i)为所述人声成分中齿音频带的能量,所述第二能量EU(i)为所述非人声成分中齿音频带的能量。
2.根据权利要求1所述的方法,其特征在于,所述电子设备获取第一音频信号之后,包括:所述电子设备将所述第一音频信号从时域信号变换到频域信号;
所述电子设备分离出所述第一音频信号的人声成分和非人声成分,包括:所述电子设备在频域中分离出所述第一音频信号的所述人声成分和所述非人声成分;
所述电子设备对所述人声成分中的齿音进行能量抑制,包括:所述电子设备在频域中对所述人声成分中的齿音进行能量抑制;
所述电子设备根据所述非人声成分与齿音抑制后的人声成分进行混音,得到第二音频信号,包括:所述电子设备在频域中根据所述非人声成分与所述齿音抑制后的人声成分进行混音之后,所述电子设备将所述混音信号从频域信号变换到时域信号,得到所述第二音频信号。
3.根据权利要求1或2所述的方法,其特征在于,所述可感知能量满足下述公式:其中,EV’(i)为所述可感知能量的值,EV(i)为所述第一能量的值,EU(i)为所述第二能量的值,ε为所述可感知能量的控制参数。
4.根据权利要求3所述的方法,其特征在于,不同的齿音子频带i对应的所述可感知能量的控制参数ε不同。
5.根据权利要求4所述的方法,其特征在于,所述电子设备对所述人声成分中的齿音进行能量抑制,满足下述公式:其中,V’(k)为所述齿音抑制后的人声成分的频谱,V(k)为所述人声成分的频谱,EV’(i)为所述可感知能量的值,m为抑制程度参数,thev(i)为第i个齿音频带的齿音能量抑制阈值。
6.根据权利要求4所述的方法,其特征在于,不同的齿音子频带i对应的抑制程度参数m不同,所述电子设备对所述人声成分中的齿音进行能量抑制,满足下述公式:其中,V’(k)为所述齿音抑制后的人声成分的频谱,V(k)为所述人声成分的频谱,EV’(i)为所述可感知能量的值,m(i)为抑制程度参数,thev(i)为第i个齿音频带的齿音能量抑制阈值。
7.根据权利要求4所述的方法,其特征在于,所述电子设备对所述人声成分中的齿音进行能量抑制之前,包括:所述电子设备根据所述人声成分中是否包括齿音设置标志位,所述标志位包括第一值或第二值,所述第一值表示所述人声成分中存在齿音,所述第二值表示所述人声成分中不存在齿音;
所述电子设备对所述人声成分中的齿音进行能量抑制包括:若所述标志位为所述第一值,则所述电子设备对所述人声成分中的齿音进行能量抑制。
8.根据权利要求7所述的方法,其特征在于,还包括:
若所述标志位为所述第二值,则所述电子设备不对所述人声成分中的齿音进行能量抑制。
9.根据权利要求8所述的方法,其特征在于,所述电子设备对所述人声成分中的齿音进行能量抑制,满足下述公式:其中,V’(k)为所述齿音抑制后的人声成分的频谱,V(k)为所述人声成分的频谱,EV’(i)为可感知能量的值,m(i)为抑制程度参数,thev(i)为第i个齿音频带的齿音能量抑制阈值,flag为所述标志位。
10.根据权利要求1所述的方法,其特征在于,所述电子设备根据所述非人声成分与齿音抑制后的人声成分进行混音之前,所述方法包括:所述电子设备对所述非人声成分和所述齿音抑制后的人声成分进行时延对齐。
11.根据权利要求10所述的方法,其特征在于,所述电子设备对所述非人声成分和所述齿音抑制后的人声成分进行时延对齐,包括:所述电子设备在所述非人声成分之前缓存一段时长的静音,所述时长为对所述人声成分进行齿音抑制时产生的时延时长。
12.一种电子设备,其特征在于,包括:存储器和处理器,所述存储器用于存储计算机程序,所述处理器用于执行所述计算机程序,以执行如权利要求1‑11任一项所述的方法。
13.一种计算机可读存储介质,其特征在于,所述计算机可读存储介质存储有指令,当所述指令被执行时,使得计算机执行如权利要求1‑11任一项所述的方法。 说明书 : 音频处理方法及相关装置[0001] 本申请是分案申请,原申请的申请号是202310309529.0,原申请日是2023年3月28日,原申请的全部内容通过引用结合在本申请中。技术领域[0002] 本申请涉及终端技术领域,尤其涉及音频处理方法及相关装置。背景技术[0003] 用户在使用电子设备上网课、看视频、听歌曲时,播放的音频中可能存在人声中的齿音,使语音的清晰度和可懂度降低,从而降低人声音质。[0004] 一种实现中,电子设备可以对输入音频进行增益抑制,但是仍然会产生较多的音色失真。发明内容[0005] 本申请实施例提供的音频处理方法及相关装置,电子设备可以先对输入音频进行人声/非人声分离,得到人声成分和非人声成分,进而电子设备可以对人声成分进行齿音抑制,这样,可以实现对齿音的抑制,同时还可以避免对非人声成分的损伤,从而减少音色失真,提升用户体验。[0006] 第一方面,本申请实施例提供的音频处理方法,方法包括:[0007] 电子设备获取第一音频信号;电子设备分离出第一音频信号的人声成分和非人声成分;电子设备对人声成分中的齿音进行能量抑制;电子设备根据非人声成分与齿音抑制后的人声成分进行混音,得到第二音频信号。这样,可以实现对齿音的抑制,同时还可以避免对非人声成分的损伤,从而减少音色失真,提升用户体验。[0008] 一种可能的实现中,电子设备获取第一音频信号之后,包括电子设备将第一音频信号从时域信号变换到频域信号;电子设备分离出第一音频信号的人声成分和非人声成分,包括电子设备在频域中分离出第一音频信号的人声成分和非人声成分;电子设备对人声成分中的齿音进行能量抑制,包括电子设备在频域中对人声成分中的齿音进行能量抑制;电子设备根据非人声成分与齿音抑制后的人声成分进行混音,得到第二音频信号,包括电子设备在频域中根据非人声成分与齿音抑制后的人声成分进行混音之后,电子设备将混音信号从频域信号变换到时域信号,得到第二音频信号。这样,由于在频域中进行齿音抑制可以不产生额外延迟,进而可以减少对非人声进行时延对齐处理的过程,从而节省算力。[0009] 一种可能的实现中,电子设备对人声成分中的齿音进行能量抑制,包括电子设备根据可感知能量和人声成分的频谱,对人声成分中的齿音进行能量抑制;其中,可感知能量为第一音频信号中齿音频带的可感知能量,可感知能量与第一能量成正比,可感知能量与第二能量成反比,第一能量为人声成分中齿音频带的能量,第二能量为非人声成分中齿音频带的能量。这样,由于考虑了非人声成分对齿音的掩蔽效应,该效应对于不明显的齿音,可以进行较小的能量抑制或者不进行能量抑制,保证了原有第一音频信号的音质。[0010] 一种可能的实现中,可感知能量满足下述公式:[0011][0012] 其中,EV’(i)为可感知能量的值,EV(i)为第一能量的值,EU(i)为第二能量的值,i为齿音子频带序号,齿音频带包括多个齿音子频带,ε为可感知能量的控制参数。这样,通过在可感知能量公式中引入ε可以控制掩蔽效应的程度,保证音质,提升用户体验。[0013] 一种可能的实现中,不同的齿音子频带i对应的可感知能量的控制参数ε不同。这样,在不同的频带采用不同的参数来控制掩蔽效应的程度,可以减少掩蔽效应对音频信号的影响,从而提升用户体验。[0014] 一种可能的实现中,电子设备对人声成分中的齿音进行能量抑制,满足下述公式:[0015][0016] 其中,V’(k)为齿音抑制后的人声成分的频谱,V(k)为人声成分的频谱,EV’(i)为可感知能量的值,m为抑制程度参数,thev(i)为第i个齿音频带的齿音能量抑制阈值。这样,可以避免对齿音频段的人声信号进行太大的抑制,产生明显的音色失真。[0017] 一种可能的实现中,不同的齿音子频带i对应的抑制程度参数m不同,电子设备对人声成分中的齿音进行能量抑制,满足下述公式:[0018][0019] 其中,V’(k)为齿音抑制后的人声成分的频谱,V(k)为人声成分的频谱,EV’(i)为可感知能量的值,m(i)为抑制程度参数,thev(i)为第i个齿音频带的齿音能量抑制阈值。这样,在不同的频带采用不同的参数来控制对齿音频带抑制程度的上限,可以减少电子设备对齿音抑制程度的影响,进而提升用户体验。[0020] 一种可能的实现中,电子设备对人声成分中的齿音进行能量抑制之前,包括电子设备根据人声成分中是否包括齿音设置标志位,标志位包括第一值或第二值,第一值表示人声成分中存在齿音,第二值表示人声成分中不存在齿音;电子设备对人声成分中的齿音进行能量抑制包括:若标志位为第一值,则电子设备对人声成分中的齿音进行能量抑制。这样,电子设备可以先根据标志位确定是否对人声成分中的齿音进行能量抑制,可以更为准确的判断齿音频带中是否存在齿音,从而提升齿音抑制的准确度。[0021] 一种可能的实现中,若标志位为第二值,则电子设备不对人声成分中的齿音进行能量抑制。这样,电子设备对于不存在齿音的频段,可以不进行齿音抑制,减少不必要的计算,节省算力。[0022] 一种可能的实现中,电子设备对人声成分中的齿音进行能量抑制,满足下述公式:[0023][0024] 其中,V’(k)为齿音抑制后的人声成分的频谱,V(k)为人声成分的频谱,EV’(i)为可感知能量的值,m(i)为抑制程度参数,thev(i)为第i个齿音频带的齿音能量抑制阈值,flag为标志位。这样,电子设备可以更为准确的判断齿音频带中是否存在齿音,对于不存在齿音的频段,电子设备可以不进行齿音抑制,从而提升齿音抑制的准确度,提升用户体验。[0025] 一种可能的实现中,电子设备根据非人声成分与齿音抑制后的人声成分进行混音之前,方法包括:电子设备对非人声成分和齿音抑制后的人声成分进行时延对齐。这样,可以减少由于对人声信号进行齿音抑制而导致的时延。[0026] 一种可能的实现中,电子设备对非人声成分和齿音抑制后的人声成分进行时延对齐,包括电子设备在非人声成分之前缓存一段时长的静音,时长为对人声成分进行齿音抑制时产生的时延时长。这样,电子设备通过在非人声成分之前缓存一段时长的静音,可以使人声信号和非人声信号的相对时延是相同的,从而减少由于对人声信号进行齿音抑制而导致的时延,提升用户体验。[0027] 第二方面,本申请实施例提供一种音频处理的装置,该装置可以是终端设备,也可以是终端设备内的芯片或者芯片系统。该装置可以包括处理单元。处理单元用于实现第一方面或第一方面的任意一种可能的实现方式中终端设备执行的与处理相关的任意方法。当该装置是终端设备时,该处理单元可以是处理器。该装置还可以包括存储单元,该存储单元可以是存储器。该存储单元用于存储指令,该处理单元执行该存储单元所存储的指令,以使该终端设备实现第一方面或第一方面的任意一种可能的实现方式中描述的方法。当该装置是终端设备内的芯片或者芯片系统时,该处理单元可以是处理器。该处理单元执行存储单元所存储的指令,以使该终端设备实现第一方面或第一方面的任意一种可能的实现方式中描述的方法。该存储单元可以是该芯片内的存储单元(例如,寄存器、缓存等),也可以是该终端设备内的位于该芯片外部的存储单元(例如,只读存储器、随机存取存储器等)。[0028] 一种可能的实现方式中,处理单元,用于获取第一音频信号;还用于分离出第一音频信号的人声成分和非人声成分;还用于对人声成分中的齿音进行能量抑制;还用于根据非人声成分与齿音抑制后的人声成分进行混音,得到第二音频信号。[0029] 一种可能的实现方式中,处理单元,用于将第一音频信号从时域信号变换到频域信号;还用于将混音信号从频域信号变换到时域信号。[0030] 一种可能的实现方式中,处理单元,用于根据可感知能量和人声成分的频谱,对人声成分中的齿音进行能量抑制。[0031] 一种可能的实现方式中,可感知能量满足下述公式:[0032][0033] 一种可能的实现方式中,不同的齿音子频带i对应的可感知能量的控制参数ε不同。[0034] 一种可能的实现方式中,处理单元,用于对人声成分中的齿音进行能量抑制,满足下述公式:[0035][0036] 一种可能的实现方式中,不同的齿音子频带i对应的抑制程度参数m不同,处理单元,用于对人声成分中的齿音进行能量抑制,满足下述公式:[0037][0038] 一种可能的实现方式中,处理单元,用于根据人声成分中是否包括齿音设置标志位,具体还用于若标志位为第一值,对人声成分中的齿音进行能量抑制。[0039] 一种可能的实现方式中,处理单元,用于若标志位为第二值,不对人声成分中的齿音进行能量抑制。[0040] 一种可能的实现方式中,处理单元,用于对人声成分中的齿音进行能量抑制,满足下述公式:[0041][0042] 一种可能的实现方式中,处理单元,用于对非人声成分和齿音抑制后的人声成分进行时延对齐。[0043] 一种可能的实现方式中,处理单元,用于在非人声成分之前缓存一段时长的静音。[0044] 第三方面,本申请实施例提供一种终端设备,包括处理器和存储器,存储器用于存储代码指令,处理器用于运行代码指令,以执行第一方面或第一方面的任意一种可能的实现方式中描述的音频处理方法。[0045] 第四方面,本申请实施例提供一种计算机可读存储介质,计算机可读存储介质中存储有计算机程序或指令,当计算机程序或指令在计算机上运行时,使得计算机执行第一方面或第一方面的任意一种可能的实现方式中描述的音频处理方法。[0046] 第五方面,本申请实施例提供一种包括计算机程序的计算机程序产品,当计算机程序在计算机上运行时,使得计算机执行第一方面或第一方面的任意一种可能的实现方式中描述的音频处理方法。[0047] 第六方面,本申请提供一种芯片或者芯片系统,该芯片或者芯片系统包括至少一个处理器和通信接口,通信接口和至少一个处理器通过线路互联,至少一个处理器用于运行计算机程序或指令,以执行第一方面或第一方面的任意一种可能的实现方式中描述的音频处理方法。其中,芯片中的通信接口可以为输入/输出接口、管脚或电路等。[0048] 在一种可能的实现中,本申请中上述描述的芯片或者芯片系统还包括至少一个存储器,该至少一个存储器中存储有指令。该存储器可以为芯片内部的存储单元,例如,寄存器、缓存等,也可以是该芯片的存储单元(例如,只读存储器、随机存取存储器等)。[0049] 应当理解的是,本申请的第二方面至第六方面与本申请的第一方面的技术方案相对应,各方面及对应的可行实施方式所取得的有益效果相似,不再赘述。附图说明[0050] 图1为本申请实施例提供的一种电子设备的结构示意图;[0051] 图2为本申请实施例提供的一种电子设备的软件结构示意图;[0052] 图3为本申请实施例提供的一种电子设备对输入音频进行增益抑制的示意图;[0053] 图4为本申请实施例提供的一种频域中电子设备对齿音进行抑制的示意图;[0054] 图5为本申请实施例提供的一种音频处理方法的示意图;[0055] 图6为本申请实施例提供的一种基于NN网络方法进行人声/非人声分离的示意图;[0056] 图7为本申请实施例提供的另一种音频处理方法的示意图;[0057] 图8为本申请实施例提供的另一种音频处理方法的示意图;[0058] 图9为本申请实施例提供的另一种音频处理方法的示意图;[0059] 图10为本申请实施例提供的一种具体的音频处理方法的示意图;[0060] 图11为本申请实施例提供的一种芯片的结构示意图。具体实施方式[0061] 为了便于清楚描述本申请实施例的技术方案,以下,对本申请实施例中所涉及的部分术语和技术进行简单介绍:[0062] 1、术语[0063] 在本申请的实施例中,采用了“第一”、“第二”等字样对功能和作用基本相同的相同项或相似项进行区分。例如,第一芯片和第二芯片仅仅是为了区分不同的芯片,并不对其先后顺序进行限定。本领域技术人员可以理解“第一”、“第二”等字样并不对数量和执行次序进行限定,并且“第一”、“第二”等字样也并不限定一定不同。[0064] 需要说明的是,本申请实施例中,“示例性的”或者“例如”等词用于表示作例子、例证或说明。本申请中被描述为“示例性的”或者“例如”的任何实施例或设计方案不应被解释为比其他实施例或设计方案更优选或更具优势。确切而言,使用“示例性的”或者“例如”等词旨在以具体方式呈现相关概念。[0065] 本申请实施例中,“至少一个”是指一个或者多个,“多个”是指两个或两个以上。“和/或”,描述关联对象的关联关系,表示可以存在三种关系,例如,A和/或B,可以表示:单独存在A,同时存在A和B,单独存在B的情况,其中A,B可以是单数或者复数。字符“/”一般表示前后关联对象是一种“或”的关系。“以下至少一项(个)”或其类似表达,是指的这些项中的任意组合,包括单项(个)或复数项(个)的任意组合。例如,a,b,或c中的至少一项(个),可以表示:a,b,c,a‑b,a‑‑c,b‑c,或a‑b‑c,其中a,b,c可以是单个,也可以是多个。[0066] 2、电子设备[0067] 本申请实施例的电子设备也可以为任意形式的终端设备,例如,电子设备可以包括具有音频功能的手持式设备、车载设备等。例如,一些电子设备为:手机(mobilephone)、平板电脑、掌上电脑、笔记本电脑、移动互联网设备(mobileinternetdevice,MID)、可穿戴设备,虚拟现实(virtualreality,VR)设备、增强现实(augmentedreality,AR)设备、工业控制(industrialcontrol)中的无线终端、无人驾驶(selfdriving)中的无线终端、远程手术(remotemedicalsurgery)中的无线终端、智能电网(smartgrid)中的无线终端、运输安全(transportationsafety)中的无线终端、智慧城市(smartcity)中的无线终端、智慧家庭(smarthome)中的无线终端、蜂窝电话、无绳电话、会话启动协议(sessioninitiationprotocol,SIP)电话、无线本地环路(wirelesslocalloop,WLL)站、个人数字助理(personaldigitalassistant,PDA)、具有无线通信功能的手持设备、计算设备或连接到无线调制解调器的其它处理设备、车载设备、可穿戴设备,5G网络中的电子设备或者未来演进的公用陆地移动通信网络(publiclandmobilenetwork,PLMN)中的电子设备等,本申请实施例对此并不限定。[0068] 作为示例而非限定,在本申请实施例中,该电子设备还可以是可穿戴设备。可穿戴设备也可以称为穿戴式智能设备,是应用穿戴式技术对日常穿戴进行智能化设计、开发出可以穿戴的设备的总称,如眼镜、手套、手表、服饰及鞋等。可穿戴设备即直接穿在身上,或是整合到用户的衣服或配件的一种便携式设备。可穿戴设备不仅仅是一种硬件设备,更是通过软件支持以及数据交互、云端交互来实现强大的功能。广义穿戴式智能设备包括功能全、尺寸大、可不依赖智能手机实现完整或者部分的功能,例如:智能手表或智能眼镜等,以及只专注于某一类应用功能,需要和其它设备如智能手机配合使用,如各类进行体征监测的智能手环、智能首饰等。[0069] 此外,在本申请实施例中,电子设备还可以是物联网(internetofthings,IoT)系统中的电子设备,IoT是未来信息技术发展的重要组成部分,其主要技术特点是将物品通过通信技术与网络连接,从而实现人机互连,物物互连的智能化网络。[0070] 本申请实施例中的电子设备也可以称为:用户设备(userequipment,UE)、移动台(mobilestation,MS)、移动终端(mobileterminal,MT)、接入终端、用户单元、用户站、移动站、移动台、远方站、远程终端、移动设备、用户终端、终端、无线通信设备、用户代理或用户装置等。[0071] 在本申请实施例中,电子设备或各个网络设备包括硬件层、运行在硬件层之上的操作系统层,以及运行在操作系统层上的应用层。该硬件层包括中央处理器(centralprocessingunit,CPU)、内存管理单元(memorymanagementunit,MMU)和内存(也称为主存)等硬件。该操作系统可以是任意一种或多种通过进程(process)实现业务处理的计算机操作系统,例如,Linux操作系统、Unix操作系统、Android操作系统、IOS操作系统或windows操作系统等。该应用层包含浏览器、通讯录、文字处理软件、即时通信软件等应用。[0072] 示例性的,图1示出了电子设备的结构示意图。[0073] 电子设备可以包括处理器110,外部存储器接口120,内部存储器121,通用串行总线(universalserialbus,USB)接口130,充电管理模块140,电源管理模块141,电池142,天线1,天线2,移动通信模块150,无线通信模块160,音频模块170,扬声器170A,受话器170B,麦克风170C,耳机接口170D,传感器模块180,按键190,马达191,指示器192,摄像头193,显示屏194,以及用户标识模块(subscriberidentificationmodule,SIM)卡接口195等。其中传感器模块180可以包括压力传感器180A,陀螺仪传感器180B,气压传感器180C,磁传感器180D,加速度传感器180E,距离传感器180F,接近光传感器180G,指纹传感器180H,温度传感器180J,触摸传感器180K,环境光传感器180L,骨传导传感器180M等。[0074] 可以理解的是,本发明实施例示意的结构并不构成对电子设备的具体限定。在本申请另一些实施例中,电子设备可以包括比图示更多或更少的部件,或者组合某些部件,或者拆分某些部件,或者不同的部件布置。图示的部件可以以硬件,软件或软件和硬件的组合实现。[0075] 处理器110可以包括一个或多个处理单元,例如:处理器110可以包括应用处理器(applicationprocessor,AP),调制解调处理器,图形处理器(graphicsprocessingunit,GPU),图像信号处理器(imagesignalprocessor,ISP),控制器,视频编解码器,数字信号处理器(digitalsignalprocessor,DSP),基带处理器,和/或神经网络处理器(neural‑networkprocessingunit,NPU)等。其中,不同的处理单元可以是独立的器件,也可以集成在一个或多个处理器中。[0076] 控制器可以根据指令操作码和时序信号,产生操作控制信号,完成取指令和执行指令的控制。[0077] 处理器110中还可以设置存储器,用于存储指令和数据。在一些实施例中,处理器110中的存储器为高速缓冲存储器。该存储器可以保存处理器110刚用过或循环使用的指令或数据。如果处理器110需要再次使用该指令或数据,可从上述存储器中直接调用。避免了重复存取,减少了处理器110的等待时间,因而提高了系统的效率。[0078] 在一些实施例中,处理器110可以包括一个或多个接口。接口可以包括集成电路(inter‑integratedcircuit,I2C)接口,集成电路内置音频(inter‑integratedcircuitsound,I2S)接口,脉冲编码调制(pulsecodemodulation,PCM)接口,通用异步收发传输器(universalasynchronousreceiver/transmitter,UART)接口,移动产业处理器接口(mobileindustryprocessorinterface,MIPI),通用输入输出(general‑purposeinput/output,GPIO)接口,SIM卡接口,和/或USB接口等。[0079] 可以理解的是,本发明实施例示意的各模块间的接口连接关系,只是示意性说明,并不构成对电子设备的结构限定。在本申请另一些实施例中,电子设备也可以采用上述实施例中不同的接口连接方式,或多种接口连接方式的组合。[0080] 外部存储器接口120可以用于连接外部存储卡,例如MicroSD卡,实现扩展电子设备的存储能力。外部存储卡通过外部存储器接口120与处理器110通信,实现数据存储功能。例如将音乐,视频等文件保存在外部存储卡中。[0081] 内部存储器121可以用于存储计算机可执行程序代码,可执行程序代码包括指令。内部存储器121可以包括存储程序区和存储数据区。其中,存储程序区可存储操作系统,至少一个功能所需的应用程序(比如声音播放功能,图像播放功能等)等。存储数据区可存储电子设备使用过程中所创建的数据(比如音频数据,电话本等)等。此外,内部存储器121可以包括高速随机存取存储器,还可以包括非易失性存储器,例如至少一个磁盘存储器件,闪存器件,通用闪存存储器(universalflashstorage,UFS)等。处理器110通过运行存储在内部存储器121的指令,和/或存储在设置于处理器中的存储器的指令,执行电子设备的各种功能应用以及数据处理。例如,可以执行本申请实施例的方法。[0082] 电子设备通过GPU,显示屏194,以及应用处理器等实现显示功能。GPU为图像处理的微处理器,连接显示屏194和应用处理器。GPU用于执行数学和几何计算,用于图形渲染。处理器110可包括一个或多个GPU,其执行程序指令以生成或改变显示信息。电子设备可以通过ISP,摄像头193,视频编解码器,GPU,显示屏194以及应用处理器等实现拍摄功能。[0083] 电子设备可以通过音频模块170,扬声器170A,受话器170B,麦克风170C,耳机接口170D,以及应用处理器等实现音频功能。例如音频播放或录音等。[0084] 音频模块170用于将数字音频信息转换成模拟音频信号输出,也用于将模拟音频输入转换为数字音频信号。扬声器170A,也称“喇叭”,用于将音频电信号转换为声音信号,电子设备中可以包括1个或N个扬声器170A,N为大于1的正整数。电子设备可以通过扬声器170A收听音乐、视频,或收听免提通话等。受话器170B,也称“听筒”,用于将音频电信号转换成声音信号。当电子设备接听电话或语音信息时,可以通过将受话器170B靠近人耳接听语音。麦克风170C,也称“话筒”或“传声器”,用于将声音信号转换为电信号。耳机接口170D用于连接有线耳机。[0085] 图2是本申请实施例的电子设备的软件结构框图。分层架构将软件分成若干个层,每一层都有清晰的角色和分工。层与层之间通过软件接口通信。在一些实施例中,将Android系统分为五层,从上至下分别为应用程序层,应用程序框架层,安卓运行时(Androidruntime)和系统库,硬件抽象层,以及内核层。[0086] 应用程序层可以包括一系列应用程序包。如图2所示,应用程序包可以包括音频应用、视频应用、社交应用等应用程序。应用程序可以包括系统应用和三方应用。[0087] 应用程序框架层为应用程序层的应用程序提供应用编程接口(applicationprogramminginterface,API)和编程框架。应用程序框架层包括一些预先定义的函数。[0088] 如图2所示,应用程序框架层可以包括窗口管理器、资源管理器、通知管理器、内容提供器和视图系统等。[0089] 窗口管理器用于管理窗口程序。窗口管理器可以获取显示屏大小,判断是否有状态栏、锁定屏幕、触摸屏幕、拖拽屏幕、截取屏幕等。[0090] 资源管理器为应用程序提供各种资源,例如本地化字符串、图标、图片、布局文件、视频文件等等。[0091] 通知管理器使应用程序可以在状态栏中显示通知信息,可以用于传达告知类型的消息,可以短暂停留后自动消失,无需用户交互。比如通知管理器被用于告知下载完成,消息提醒等。通知管理器还可以是以图表或者滚动条文本形式出现在系统顶部状态栏的通知,例如后台运行的应用程序的通知,还可以是以对话窗口形式出现在屏幕上的通知。例如在状态栏提示文本信息、发出提示音、电子设备振动、指示灯闪烁等。[0092] 内容提供器用于在不同的应用程序之间实现数据共享的功能,允许一个程序访问另一个程序中的数据,同时还能保证被访问的数据的安全性。[0093] 视图系统可以负责应用程序的界面绘制和事件处理。[0094] Androidruntime包括核心库和虚拟机。Androidruntime负责安卓系统的调度和管理。[0095] 核心库包含两部分:一部分是java语言需要调用的功能函数,另一部分是安卓的核心库。[0096] 应用程序层和应用程序框架层运行在虚拟机中。虚拟机将应用程序层和应用程序框架层的java文件执行为二进制文件。虚拟机用于执行对象生命周期的管理,堆栈管理,线程管理,安全和异常的管理,以及垃圾回收等功能。[0097] 系统库可以包括多个功能模块。例如:媒体库(medialibraries)、函数库(functionlibraries)、音视频处理库等。[0098] 媒体库支持多种常用的音频,视频格式回放和录制,以及静态图像文件等。媒体库可以支持多种音视频编码格式,例如:MPEG4,H.264,MP3,AAC,AMR,JPG,PNG等。[0099] 函数库为开发者提供多种服务的API接口,方便开发者快速集成并实现各种功能。[0100] 硬件抽象层是介于内核层和Androidruntime之间的抽象出来的一层结构。硬件抽象层可以是对硬件驱动的一个封装,为上层应用的调用提供统一接口。[0101] 内核层是硬件和软件之间的层。内核层可以包括音频驱动、视频驱动、摄像头驱动等。[0102] 本申请实施例仅以安卓系统举例来说明,在其他操作系统中(例如Windows系统,IOS系统等),只要各个功能模块实现的功能和本申请的实施例类似,也能实现本申请的方案。[0103] 需要说明的是,本申请实施例对输入音频进行的频段抑制、时频转换、人声/非人声分离、齿音抑制、时延对齐、掩蔽效应计算、混音、频时转换等处理,可以在电子设备的多个软件架构层实现。例如,电子设备的应用层中涉及音视频相关的应用程序可以进行上述处理,此外,电子设备的系统库中的音视频处理库、硬件抽象层的音视频模块,以及驱动层的音视频驱动均可以进行上述处理,进而实现对输入音频中齿音的抑制。具体实现齿音抑制的软件层级,本申请实施例不作具体限定。[0104] 用户在使用电子设备上网课、看视频、听歌曲时,播放的音频中可能存在人声中的齿音,使语音的清晰度和可懂度降低,从而降低人声音质。其中,齿音可以理解为当发音声母是j、q、x、zh、ch、sh、z、c、s时,舌尖顶住上门牙,气流和牙齿发生摩擦,产生齿音。[0105] 由于音频中齿音的频率范围在4kHz~10kHz之间,属于中高频段,是人耳比较敏感的区域,容易带来刺耳的听感。一方面,一些电子设备采用侧出音的方式,使得在4.3kHz和9kHz~10kHz附近形成明显的峰谷,导致音频中的齿音较为明显,影响听感。另一方面,用户在使用耳机时,由于耳机贴合耳朵,齿音也会随着距离的缩短而增大,也会导致音频中的齿音较为明显,降低人声音质。[0106] 一种实现中,如图3所示,电子设备可以对输入音频的4kHz~10kHz和/或5kHz~12kHz的齿音频段进行固定增益的抑制。其中,该输入音频中包括人声成分和非人声成分,非人声成分可以包括鸟叫声、乐器声、特效声,以及噪声等。电子设备对输入音频进行固定增益的抑制包括对人声成分和非人声成分均进行抑制。示例性的,电子设备可以通过一个或多个无限脉冲响应(infiniteimpulseresponse,IIR)滤波器/均衡器实现对输入音频的抑制。然而,该实现可以导致非人声成分的频段也受到抑制,产生较多的音色失真。[0107] 另一种实现中,如图4所示,电子设备可以把输入音频从时域信号转换成频域信号,该输入音频中包括人声成分和非人声成分。在频域中可以对输入信号进行能量包络、过零率,和/或齿音频带能量等分析,然后根据分析结果对齿音频带能量进行自适应抑制。其中,能量包络以及过零率等可以指示频带中的信号为齿音的可能性,当指示频带信号为齿音时,电子设备可以对齿音进行频带能量的计算。若齿音频带能量较大,说明齿音较为明显,可以对齿音进行抑制。然而,该实现没有考虑对非人声成分的影响,可能会把一些非人声成分当成齿音进行抑制,产生较多的音色失真。[0108] 有鉴于此,本申请实施例提供的音频处理方法,电子设备可以先对输入音频进行人声/非人声分离,得到人声成分和非人声成分,进而电子设备可以对人声成分进行齿音抑制,这样,可以实现对齿音的抑制,同时还可以避免对非人声成分的损伤,从而减少音色失真,提升用户体验。[0109] 具体的,图5示出了本申请实施例提供的音频处理方法。其中,该音频处理方法可以包括人声/非人声分离、齿音抑制,以及混音等处理方法。[0110] (1)人声/非人声分离。[0111] 电子设备可以对输入音频进行人声/非人声分离,可能的实现中,电子设备可以采用传统信号处理方法对输入音频进行人声/非人声分离,例如传统信号处理方法可以包括基于相关度分析的信号处理方法,语音活动检测(voiceactivitydetection,VAD)方法等。电子设备还可以采用基于神经网络(neuralnetworks,NN)方法对输入音频进行人声/非人声分离,具体人声/非人声分离的实现方法,本申请实施例不作限定。[0112] 下面以基于NN网络方法为例,说明对输入音频进行人声/非人声分离的过程。[0113] 如图6所示,基于NN网络方法对输入音频进行人声/非人声分离可以包括(a)训练侧和(b)提取侧。其中,训练侧可以理解为NN网络的训练过程,NN网络通过对大量人声数据的训练,实现对人声数据的学习,可以不断提高NN网络提取人声的准确性。提取侧可以理解为使用NN网络的过程,可以实现人声/非人声分离。[0114] (a)训练侧。[0115] NN网络方法可以对人声信号进行时频转换得到频域的人声信号,该频域的人声信号可以有对应的真实数据掩码(ground‑truth掩码),该ground‑truth掩码可以理解为准确的人声数据,可以作为衡量训练数据准确性的标准。[0116] 可能的实现中,时频转换可以采用快速傅里叶变换(fast fouriertransformation,FFT)、离散傅里叶变换(discretefouriertransform,DFT)、修改的离散余弦变换(modifieddiscretecosinetransform,MDCT)等方法实现。以DFT方法为例,时频转换可以满足下述公式:[0117][0118] 其中,x(n)可以是输入时域信号,N可以是DFT每次处理输入时域信号的连续时域样点数,通常连续时域样点数可以是一帧或两帧左右的信号,X(k)是输出的复数频谱信号,可以包括实部和虚部:[0119] X(k)=XR(k)+jXI(k)。[0120] 对实部和虚部计算平方求和,再开方,则可以得到频谱幅度:[0121][0122] 在训练时,该NN网络方法可以在人声数据中加入其它非人声数据,例如非人声数据可以包括鸟叫声、乐器声、特效声,以及噪声等数据,生成混合信号,并对该混合信号进行时频转换得到频域的混合信号。该频域的混合信号可以基于NN网络模型的人声提取方法得到人声掩码。其中,基于NN网络模型的人声提取方法可以包括基于深度滤波的全频带音频低复杂度语音增强框架(DeepFilterNet)的方法、负载均衡(Dmucs)方法,以及卷积时域音频分离网络(convolutionaltime‑domainaudioseparationnetwork,ConvTasNet)方法等,具体电子设备采取的人声提取方法,本申请实施例不作限定。[0123] 可以理解的是,基于NN网络模型的人声提取方法得到的人声掩码可以为混合信号中人声信号占比的权重,该人声掩码可以理解为NN网络对人声数据训练的结果。[0124] 进一步,损失函数可以计算ground‑truth掩码和人声掩码之间的误差,并将该误差反馈给NN网络。NN网络可以进行反向推理,对NN网络的掩码权重进行更新,使得人声掩码不断接近ground‑truth掩码,也就是说使得NN网络得到的人声数据逐渐接近真实的人声数据,不断提高NN网络的计算准确性。[0125] (b)提取侧。[0126] NN网络方法可以对混合信号进行时频转换得到频域的混合信号,该频域的混合信号通过NN网络模型可以得到人声掩码。将频域的混合信号乘以人声掩码,则可以得到频域的人声信号。在得到频域的人声信号后,将频域的混合信号减去频域的人声信号,则可以得到频域的非人声信号。[0127] 也就是说,经过该NN网络方法对输入音频进行人声/非人声分离的提取,可以把混合信号频谱X(k)分解成人声信号频谱V(k)和非人声信号频谱U(k),可以满足下述关系:[0128] X(k)=V(k)+U(k)k=0,1...N‑1。[0129] 进一步,通过对频域的人声信号进行频时转换,可以输出时域的人声信号;经过对频域的非人声信号进行频时转换,可以输出时域的非人声信号。这样,该NN网络方法可以实现输入音频的人声/非人声分离。[0130] 可能的实现中,频时转换可以采用时频转换的逆过程实现。以DFT方法为例,DFT方法的逆过程可以是反离散傅里叶变换(inversediscretefouriertransform,IDFT),满足下述公式:[0131][0132] 其中,X(k)是输入的复数频谱信号,N可以是DFT每次处理输入频域信号的连续频域样点数,x(n)可以是输出的时域信号。[0133] (2)齿音抑制。[0134] 在分离出人声成分后,电子设备可以仅对人声成分进行齿音抑制,具体齿音抑制的方法可以包括上述图3对应的时域音频处理方法,以及上述图4对应的频域音频处理方法,电子设备也可以采用其他齿音抑制的方法,本申请实施例不作限定。[0135] (3)混音。[0136] 在对人声成分完成齿音抑制后,电子设备可以将非人声成分和齿音抑制后的人声成分进行混音处理,得到齿音抑制后的输出信号。[0137] 示例性的的,若非人声信号频谱为U(k),齿音抑制后的人声信号频谱为V’(k),则经过混音处理后,可以得到齿音抑制后的混合频谱X’(k),满足下述公式:[0138] X′(k)=V′(k)+U(k)k=0,1...,N‑1。[0139] 这样,通过对输入音频进行人声/非人声分离、齿音抑制,以及混音等处理方法,可以实现对齿音的抑制,同时还可以避免对非人声成分的损伤,从而减少音色失真,提升用户体验。[0140] 可以理解的是,若采用上述图3对应的时域音频处理方法,可能会对输入的音频信号引入一定的时延,例如通过IIR滤波器进行齿音抑制时,会引入若干样点的时延;或者把时域的人声信号转换到频域的人声信号,对频域的人声信号进行齿音抑制后,再将频域的人声信号转换为时域的人声信号,通常会引入一帧左右的时延。[0141] 对于这种情况,图7示出了本申请实施例提供的另一种音频处理方法,可以针对音频处理方法中存在的时延问题进行处理。电子设备可以在图5对应的实施例的基础上,对非人声信号加入时延对齐处理。电子设备可以通过对非人声信号进行缓存样点来实现时延对齐处理,具体的,电子设备可以在非人声成分之前缓存一段时长的静音,该时长可以为对人声成分进行齿音抑制时产生的时延时长。电子设备还可以使用其他方式现实时延对齐处理。具体的时延对齐处理方法,本申请实施例不作限定。这样,可以使得人声信号和非人声信号的相对时延是相同的,从而减少由于对人声信号进行齿音抑制而导致的时延。[0142] 可以理解的是,如果人声/非人声分离和齿音抑制都是在频域实现,则电子设备可以不对非人声进行时延对齐处理。这是由于在频域中进行齿音抑制时,电子设备可以不需要经过滤波器实现,因此不会由于滤波器进行齿音抑制而产生时延。[0143] 因此,图8示出了本申请实施例提供的另一种音频处理方法,在人声/非人声分离和齿音抑制之前,电子设备可以先对输入音频进行时频变换,且不对非人声进行时延对齐处理。这样,在频域中进行齿音抑制可以不产生额外延迟,减少了对非人声进行时延对齐处理的过程,从而节省算力。[0144] 需要说明的是,在上述图3以及图4对应的音频处理方法中,没有考虑非人声成分对人声成分齿音频带的掩蔽效应,即在齿音频带上,如果非人声成分能量比人声成分大很多,这时齿音可能不会被用户听到,或者听起来并不明显,因此没有必要对齿音进行抑制。[0145] 有鉴于此,图9示出了本申请实施例提供了另一种音频处理方法,电子设备可以结合考虑非人声成分对人声成分齿音频带的掩蔽效应,然后进行齿音抑制,这样,对于齿音不明显的音频,电子设备可以不对齿音进行抑制处理,使得齿音不明显的音频可以不会受到抑制,从而尽可能的保证音色。[0146] 具体的,电子设备在对输入音频进行时频变换,以及在频域进行人声和非人声分离后,电子设备可以在齿音频段对人声部分进行齿音抑制频段能量计算,以及对非人声部分进行齿音掩蔽频段能量计算,然后可以计算出掩蔽后的齿音频带可感知能量。[0147] 可以理解的是,输入音频的频带可以分成若干子带,例如电子设备可以根据bark谱、等效矩阵带宽(equivalentrectangularbandwidth,ERB)、倍频程、1/3倍频程、均匀子带宽度等方法将频带分成若干子带。以输入信号是48kHz采样率,帧长480样点,DFT输入样点数为960点,分频带方法是bark谱为例,如下述表1所示,电子设备可以将输入音频的频域信号分成24个子带(对应表1中的bark子带序号0~23)。其中,和齿音相关的频带可以包括5个(对应表1中的齿音分析子带序号0~4),总的齿音分析频带范围可以包括4kHz~10.5kHz(对应表1中的子带起始频率4000Hz~子带截止频率10500Hz)。[0148] 表1[0149][0150] 电子设备可以对齿音抑制频带的人声频谱V(k)进行能量计算,齿音抑制频带的人声能量EV(i)可以满足下述公式:[0151][0152] 其中,i可以表示齿音分析子带序号,可以分别取值为0~4的整数。[0153] 电子设备可以对齿音抑制频带的非人声频谱U(k)进行能量计算,齿音抑制频带的非人声能量EU(i)可以满足下述公式:[0154][0155] 其中,i可以表示齿音分析子带序号,可以分别取值为0~4的整数。[0156] 在计算出齿音抑制频带的人声能量EV(i)和非人声能量EU(i)后,电子设备可以计算出掩蔽后的齿音频带可感知能量EV’(i),齿音频带可感知能量EV’(i)可以满足下述公式:[0157][0158] 其中,ε可以是正实数,例如ε可以取值为0.0001,0.003,0.09,0.5,1.0等。ε可以作为参数来控制掩蔽效应的程度。示例性的,ε取值较小时,计算出的可感知能量EV’(i)值相对较小,非人声成分对人声成分的掩蔽效应相对明显,齿音相对不明显;ε取值较大时,计算出的可感知能量EV’(i)值相对较大,非人声成分对人声成分的掩蔽效应相对不明显,齿音相对明显。[0159] 可以理解的是,电子设备对输入音频信号进行离散采样时,可以得到音频信号的各个样点,这些样点可以用2的某个次方表示,例如用2的16次方表示该音频信号时,该音频信号样点的最大取值范围为正负2的15次方,可以用M表示该最大取值,该M也可以理解为输入时域信号x(n)的取值范围的上限,例如该上限可以为2的15次方。为了避免ε值太大,齿音太明显,电子设备可以设置ε可能取值的上限。ε的上限可以小于输入时域信号x(n)的最大值M,例如ε的上限可以小于或等于M/10。[0160] 此外,ε的取值还与电子设备的硬件有关,不同的电子设备可以对上述的ε取值进行不同的调整。ε可以由电子设备预先进行设置,具体ε的取值,本申请实施例不作限定。[0161] 对于不同的频带,非人声成分对人声成分的掩蔽效应可能不同,因此,电子设备可以在不同的频带采用不同的ε取值,即ε可以改为ε(i)。这种情况下,齿音频带可感知能量EV’(i)可以满足下述公式:[0162][0163] 其中,i可以表示齿音分析子带序号,可以分别取值为0~4的整数,ε(i)可以是正实数。可以理解的是,i的取值不同,对应ε(i)的值可以不相同。[0164] 对于理想的发声器件,由于频率越高,人耳听力对于音频信号越不敏感,也就对齿音越不敏感,因此,当i的取值较大时,频率也相对较大,ε(i)的值总体也可以随之变大。[0165] 同理,电子设备可以设置ε(i)的上限小于或等于M/10。ε(i)的取值还与电子设备的硬件有关,不同的电子设备可以对ε(i)取值进行不同的调整。ε(i)可以由电子设备预先进行设置,具体ε(i)的取值,本申请实施例不作限定。[0166] 由于扬声器发声器件一般不是特别理想,可能会在某些特定较高频带(例如8.5kHz~10.5kHz)加重齿音,因此也不排除在某些特定较高频带上(例如8.5kHz~10.5kHz),ε(i)的取值(例如ε(4)取值为1.2)反而比较低频带上(例如7kHz~8kHz)ε(i)的取值(例如ε(3)取值为2.3)小。[0167] 这样,在不同的频带采用不同的参数来控制掩蔽效应的程度,可以减少掩蔽效应对音频信号的影响,从而提升用户体验。[0168] 在计算出掩蔽后的齿音频带可感知能量EV’(i)后,电子设备可以根据EV’(i)的值对齿音频带进行自适应抑制处理,具体的,齿音频带抑制后的人声信号频谱V’(k)可以满足下述公式:[0169][0170] 其中,i可以表示齿音分析子带序号,可以分别取值为0~4的整数,thev(i)是第i个齿音频带的齿音能量抑制阈值。thev(i)的取值可以由电子设备预先进行设置,可能的实现方式中,可以将一些容易产生齿音的音频序列在电子设备上进行播放,对于齿音较为明显的音频序列,可以统计这些音频序列的齿音子带频带(序号为i)上的能量,进而获得thev(i)的初始值,例如可以取这些音频序列的频带能量的中位数,或者可以取这些音频序列的频带能量的均值。此外,还可以基于该thev(i)初始值,在电子设备上的进行微调,如果仍然存在较为明显的齿音现象,则可以调低thev(i),否则可以稍微调高thev(i)。具体thev(i)的取值,本申请实施例不作限定。[0171] 由上述公式可知,当可感知能量EV’(i)小于thev(i)阈值时,说明齿音频带的可感知能量EV’(i)较小,齿音相对不明显,因此,电子设备可以不对人声成分频谱V(k)进行能量抑制。当可感知能量EV’(i)大于thev(i)阈值,且可感知能量EV’(i)大于4倍的thev(i)阈值时,说明齿音频带的可感知能量EV’(i)较大,齿音相对较为明显,因此,电子设备可以对人声成分频谱V(k)进行较小的能量抑制。当可感知能量EV’(i)大于4倍的thev(i)阈值时,说明齿音频带的可感知能量EV’(i)很大,齿音明显,因此,电子设备可以对人声成分频谱V(k)进行较大的能量抑制,例如齿音频带抑制后的人声信号频谱V’(k)可以为齿音频带抑制前人声成分频谱V(k)的一半。[0172] 可以理解的是,上述公式中,thev(i)的4倍可以作为EV’(i)值的判断条件,然而,由于不同的电子设备可能有不同的阈值设置,thev(i)的4倍固定取值降低了对齿音频带进行自适应抑制处理的灵活性,因此,电子设备可以对thev(i)的倍数进行灵活取值。示例性的,电子设备可以通过参数m来控制对齿音频带抑制程度的上限,这样,可以避免对齿音频段的人声信号进行太大的抑制,产生明显的音色失真。具体与参数m相关的齿音频带抑制后的人声信号频谱V’(k)可以满足下述公式:[0173][0174] 其中,m可以为大于1的正实数,例如m可以取值为1.0001,2,3,3.2,4.7等。例如m如果取值为3,则表示对指齿音频带的抑制最多可以为3倍。[0175] 可以理解的是,如果m的取值较小,对于齿音的抑制越不明显,如果m的取值较大,对于齿音的抑制越明显。为了避免对齿音频段的人声信号进行太大的抑制,产生明显的音色失真,m的取值不能太大,可能的实现中,m可以取值在1‑10以内。这样,可以使得电子设备对齿音抑制控制在合理的范围内,从而使得用户有较好的听觉体验。[0176] 此外,m的取值还与电子设备的硬件有关,不同的电子设备可以对m取值进行不同的调整。m的取值可以由电子设备预先进行设置,具体m的取值,本申请实施例不作限定。[0177] 此外,由于不同的频带,其齿音需要的抑制上限的程度可能不相同,因此,电子设备可以在不同的频带对m进行不同的取值,即m可以改为m(i)。这种情况下,具体与m(i)相关的齿音频带抑制后的人声信号频谱V’(k)可以满足下述公式:[0178][0179] 其中,i可以表示齿音分析子带序号,可以分别取值为0~4的整数,m(i)可以是正实数。可以理解的是,i的取值不同,对应m(i)的值则可以不相同。同理,电子设备可以设置m(i)的取值范围在1‑10以内。m(i)的取值还与电子设备的硬件有关,不同的电子设备可以对m(i)取值进行不同的调整。可能的实现中,m(i)可以先在2的附近取值,针对不同的电子设备,可以再进行调整,直到齿音不明显为止。m(i)可以由电子设备预先进行设置,具体m(i)的取值,本申请实施例不作限定。[0180] 这样,在不同的频带采用不同的参数来控制对齿音频带抑制程度的上限,可以减少电子设备对齿音抑制程度的影响,进而提升用户体验。[0181] 另外需要说明的是,齿音频带能量大,并不代表声音成分一定是齿音,例如有些人的浊音和齿音可能会有重叠。为了提升齿音抑制的准确度,本申请实施例可以对人声成分的齿音频段引入特定频谱平坦度特征(specificspectrumflatnessmeasure,SSFM)。SSFM可以满足下述公式:[0182][0183] 其中,k可以是齿音频带的个数,k为正整数,例如k可以取值为5。[0184] 可能的实现中,SSFM值可以和阈值thr比较,用于确定是否存在齿音。示例性的,若SSFM值大于阈值thr,则可以认为存在齿音,标记flag为1;若SSFM值小于或等于阈值thr,则可以认为不存在齿音,标记flag为0,具体flag可以满足下述公式:[0185][0186] 其中,thr可以是大于1的正实数,例如thr可以取值为4.0,5.8,10,11.3等。thr的取值可以由电子设备预先进行设置,具体thr的取值,本申请实施例不作限定。[0187] 具体与flag相关的齿音频带抑制后的人声信号频谱V’(k)可以满足下述公式:[0188][0189] 当flag为0时,可以认为不存在齿音,则电子设备可以不对齿音频带进行抑制。当flag为1时,可以认为存在齿音,则电子设备可以对齿音频带进行抑制。这样,电子设备可以更为准确的判断齿音频带中是否存在齿音,对于不存在齿音的频段,电子设备可以不进行齿音抑制,从而提升齿音抑制的准确度。[0190] 在齿音抑制处理完成后,电子设备可以对人声部分和非人声部分进行混音处理以及频时转换处理,进而得到输出音频。具体的混音处理以及频时转换处理,可以参照上述图5对应的实施例中的相关描述,不再赘述。[0191] 下面通过具体的实施例对本申请实施例的方法进行详细说明。下面的实施例可以相互结合或独立实施,对于相同或相似的概念或过程可能在某些实施例中不再赘述。[0192] 图10示出了本申请实施例的音频处理方法。方法包括:[0193] S1001、电子设备获取第一音频信号。[0194] 本申请实施例中,第一音频信号可以理解为电子设备的输入音频信号。[0195] S1002、电子设备分离出第一音频信号的人声成分和非人声成分。[0196] 本申请实施例中,电子设备可以采用传统信号处理方法或者基于NN方法等不同的方法对输入音频进行人声/非人声分离。具体人声/非人声分离的实现方法可以参照上述图5对应的实施例中(1)人声/非人声分离部分的相关描述,不再赘述。[0197] S1003、电子设备对人声成分中的齿音进行能量抑制。[0198] 本申请实施例中,电子设备对人声成分中的齿音进行能量抑制可以包括上述图3对应的时域音频处理方法,以及上述图4对应的频域音频处理方法,电子设备也可以采用其他齿音抑制的方法,本申请实施例不作限定。[0199] S1004、电子设备根据非人声成分与齿音抑制后的人声成分进行混音,得到第二音频信号。[0200] 本申请实施例中,混音方法可以参照上述图5对应的实施例中(3)混音部分的相关描述,不再赘述。第二音频信号可以理解为电子设备的输出音频信号。[0201] 可以理解的是,非人声成分可以是上述步骤S1002中电子设备分离出的非人声成分,也可以是电子设备对分离出的非人声成分进行过一些处理后的非人声成分,该处理包括对非人声成分增益的放大或缩小等,本申请实施例对该处理不作限定。[0202] 此外,电子设备根据非人声成分与齿音抑制后的人声成分进行混音,可以包括:根据非人声成分频谱与齿音抑制后的人声成分频谱的和进行混音;或者根据非人声成分和齿音抑制后的人声成分进行不同加权进行混音;或者根据非人声成分和齿音抑制后的人声成分的和的倍数进行混音,具体电子设备根据非人声成分与齿音抑制后的人声成分进行混音的计算过程,本申请实施例不做限定。[0203] 电子设备先对输入音频进行人声/非人声分离,得到人声成分和非人声成分,进而电子设备可以对人声成分进行齿音抑制,这样,可以实现对齿音的抑制,同时还可以避免对非人声成分的损伤,从而减少音色失真,提升用户体验。[0204] 可选的,在图10对应的实施例的基础上,在步骤S1001的电子设备获取第一音频信号之后,可以包括:电子设备将第一音频信号从时域信号变换到频域信号;电子设备分离出第一音频信号的人声成分和非人声成分可以包括:电子设备在频域中分离出第一音频信号的人声成分和非人声成分;电子设备对人声成分中的齿音进行能量抑制可以包括:电子设备在频域中对人声成分中的齿音进行能量抑制;电子设备根据非人声成分与齿音抑制后的人声成分进行混音,得到第二音频信号,可以包括:电子设备在频域中根据非人声成分与齿音抑制后的人声成分进行混音之后,电子设备将混音信号从频域信号变换到时域信号,得到第二音频信号。[0205] 本申请实施例中,电子设备对第一音频信号进行时频变换,使得人声/非人声分离和齿音抑制都在频域实现,这样,由于在频域中进行齿音抑制可以不产生额外延迟,进而可以减少对非人声进行时延对齐处理的过程,从而节省算力。[0206] 可选的,在图10对应的实施例的基础上,步骤S1003的电子设备对人声成分中的齿音进行能量抑制,可以包括:电子设备根据可感知能量和人声成分的频谱,对人声成分中的齿音进行能量抑制;其中,可感知能量为第一音频信号中齿音频带的可感知能量,可感知能量与第一能量成正比,可感知能量与第二能量成反比,第一能量为人声成分中齿音频带的能量,第二能量为非人声成分中齿音频带的能量。[0207] 本申请实施例中,对人声成分中的齿音进行能量抑制与可感知能量和人声成分的频谱相关,例如当可感知能量较小时,说明齿音相对不明显,电子设备可以对人声成分进行较小的能量抑制或者不进行能量抑制;当可感知能量较大时,说明齿音相对明显,电子设备可以对人声成分进行较大的能量抑制。[0208] 可感知能量与人声成分中齿音频带的能量成正比,可感知能量与非人声成分中齿音频带的能量成反比。当人声成分中齿音频带的能量较大时,说明齿音较为明显,此时可感知能量也较大;当非人声成分中齿音频带的能量较大时,非人声成分可以掩蔽齿音,使得齿音变得不明显,此时可感知能量也较小。[0209] 本申请实施例考虑了非人声成分对齿音的掩蔽效应,该效应对于不明显的齿音,可以进行较小的能量抑制或者不进行能量抑制,保证了原有第一音频信号的音质。[0210] 可选的,在图10对应的实施例的基础上,可以包括:可感知能量满足下述公式:[0211][0212] 其中,EV’(i)为可感知能量的值,EV(i)为第一能量的值,EU(i)为第二能量的值,i为齿音子频带序号,齿音频带包括多个齿音子频带,ε为可感知能量的控制参数。[0213] 本申请实施例中,可感知能量公式可以参考上述图9对应的实施例中可感知能量的相关描述,不再赘述。通过在可感知能量公式中引入ε可以控制掩蔽效应的程度,保证音质,提升用户体验。[0214] 可选的,在图10对应的实施例的基础上,可以包括:不同的齿音子频带i对应的可感知能量的控制参数ε不同。[0215] 本申请实施例中,不同的齿音子频带i对应的可感知能量的控制参数ε不同,可以使用ε(i)来表示,具体的ε(i)可以参考上述图9对应的实施例中ε(i)的相关描述,不再赘述。这样,在不同的频带采用不同的参数来控制掩蔽效应的程度,可以减少掩蔽效应对音频信号的影响,从而提升用户体验。[0216] 可选的,在图10对应的实施例的基础上,步骤S1003的电子设备对人声成分中的齿音进行能量抑制,可以满足下述公式:[0217][0218] 其中,V’(k)为齿音抑制后的人声成分的频谱,V(k)为人声成分的频谱,EV’(i)为可感知能量的值,m为抑制程度参数,thev(i)为第i个齿音频带的齿音能量抑制阈值。[0219] 本申请实施例中,能量抑制公式可以参照上述图9对应的实施例中带有m的能量抑制公式的相关描述,不再赘述。电子设备通过参数m来控制对齿音频带抑制程度的上限,这样,可以避免对齿音频段的人声信号进行太大的抑制,产生明显的音色失真。[0220] 可选的,在图10对应的实施例的基础上,不同的齿音子频带i对应的抑制程度参数m不同,步骤S1003的电子设备对人声成分中的齿音进行能量抑制,可以满足下述公式:[0221][0222] 其中,V’(k)为齿音抑制后的人声成分的频谱,V(k)为人声成分的频谱,EV’(i)为可感知能量的值,m(i)为抑制程度参数,thev(i)为第i个齿音频带的齿音能量抑制阈值。[0223] 本申请实施例中,能量抑制公式可以参照上述图9对应的实施例中带有m(i)的能量抑制公式的相关描述,不再赘述。这样,在不同的频带采用不同的参数来控制对齿音频带抑制程度的上限,可以减少电子设备对齿音抑制程度的影响,进而提升用户体验。[0224] 可选的,在图10对应的实施例的基础上,步骤S1003的电子设备对人声成分中的齿音进行能量抑制之前,可以包括:电子设备根据人声成分中是否包括齿音设置标志位,标志位包括第一值或第二值,第一值表示人声成分中存在齿音,第二值表示人声成分中不存在齿音;电子设备对人声成分中的齿音进行能量抑制可以包括:若标志位为第一值,则电子设备对人声成分中的齿音进行能量抑制。[0225] 本申请实施例中,人声成分中是否包括齿音可以根据频谱平坦度特征SSFM进行判断,也可以根据其他方式判断,本申请实施例不作限定。具体SSFM可以参照上述图9对应的实施例中的相关描述,不再赘述。[0226] 标志位可以表示人声成分中是否包括齿音,标志位的取值可以为第一值或第二值,可以理解的是,第一值或第二值的数据类型可以为整型、布尔类型、字符串等类型,本申请实施例不作限定。示例性的,第一值或第二值可以为整型,例如第一值为1表示存在齿音,电子设备可以对人声成分中的齿音进行能量抑制;第二值为0表示不存在齿音,电子设备可以不对人声成分中的齿音进行能量抑制。具体第一值或第二值的取值,本申请实施例不作限定。[0227] 这样,电子设备可以先根据标志位确定是否对人声成分中的齿音进行能量抑制,可以更为准确的判断齿音频带中是否存在齿音,从而提升齿音抑制的准确度。[0228] 可选的,在图10对应的实施例的基础上,还可以包括:若标志位为第二值,则电子设备不对人声成分中的齿音进行能量抑制。[0229] 本申请实施例中,电子设备对于不存在齿音的频段,可以不进行齿音抑制,减少不必要的计算,节省算力。[0230] 可选的,在图10对应的实施例的基础上,步骤S1003的电子设备对人声成分中的齿音进行能量抑制,可以满足下述公式:[0231][0232] 其中,V’(k)为齿音抑制后的人声成分的频谱,V(k)为人声成分的频谱,EV’(i)为可感知能量的值,m(i)为抑制程度参数,thev(i)为第i个齿音频带的齿音能量抑制阈值,flag为标志位。[0233] 本申请实施例中,能量抑制公式可以参照上述图9对应的实施例中带有flag标志位的能量抑制公式的相关描述,不再赘述。这样,电子设备可以更为准确的判断齿音频带中是否存在齿音,对于不存在齿音的频段,电子设备可以不进行齿音抑制,从而提升齿音抑制的准确度,提升用户体验。[0234] 可选的,在图10对应的实施例的基础上,步骤S1004的电子设备根据非人声成分与齿音抑制后的人声成分进行混音之前,方法可以包括:电子设备对非人声成分和齿音抑制后的人声成分进行时延对齐。[0235] 本申请实施例中,时延对齐可以参照上述图7对应的实施例中的相关描述,不再赘述。时延对齐可以使得人声信号和非人声信号的相对时延是相同的,从而减少由于对人声信号进行齿音抑制而导致的时延。[0236] 可选的,在图10对应的实施例的基础上,电子设备对非人声成分和齿音抑制后的人声成分进行时延对齐,可以包括:电子设备在非人声成分之前缓存一段时长的静音,时长为对人声成分进行齿音抑制时产生的时延时长。[0237] 本申请实施例中,电子设备通过在非人声成分之前缓存一段时长的静音,可以使人声信号和非人声信号的相对时延是相同的,从而减少由于对人声信号进行齿音抑制而导致的时延,提升用户体验。[0238] 需要说明的是,本申请所涉及的用户信息(包括但不限于用户设备信息、用户个人信息等)和数据(包括但不限于用于分析的数据、存储的数据、展示的数据等),均为经用户授权或者经过各方充分授权的信息和数据,并且相关数据的收集、使用和处理需要遵守相关国家和地区的相关法律法规和标准,并提供有相应的操作入口,供用户选择授权或者拒绝。[0239] 上述主要从方法的角度对本申请实施例提供的方案进行了介绍。为了实现上述功能,其包含了执行各个功能相应的硬件结构和/或软件模块。本领域技术人员应该很容易意识到,结合本文中所公开的实施例描述的各示例的方法步骤,本申请能够以硬件或硬件和计算机软件的结合形式来实现。某个功能究竟以硬件还是计算机软件驱动硬件的方式来执行,取决于技术方案的特定应用和设计约束条件。专业技术人员可以对每个特定的应用来使用不同方法来实现所描述的功能,但是这种实现不应认为超出本申请的范围。[0240] 本申请实施例可以根据上述方法示例对实现该方法的装置进行功能模块的划分,例如可以对应各个功能划分各个功能模块,也可以将两个或两个以上的功能集成在一个处理模块中。集成的模块既可以采用硬件的形式实现,也可以采用软件功能模块的形式实现。需要说明的是,本申请实施例中对模块的划分是示意性的,仅仅为一种逻辑功能划分,实际实现时可以有另外的划分方式。[0241] 如图11示为本申请实施例提供的一种芯片的结构示意图。芯片1100包括一个或两个以上(包括两个)处理器1101、通信线路1102、通信接口1103和存储器1104。[0242] 在一些实施方式中,存储器1104存储了如下的元素:可执行模块或者数据结构,或者他们的子集,或者他们的扩展集。[0243] 上述本申请实施例描述的方法可以应用于处理器1101中,或者由处理器1101实现。处理器1101可能是一种集成电路芯片,具有信号的处理能力。在实现过程中,上述方法的各步骤可以通过处理器1101中的硬件的集成逻辑电路或者软件形式的指令完成。上述的处理器1101可以是通用处理器(例如,微处理器或常规处理器)、数字信号处理器(digitalsignalprocessing,DSP)、专用集成电路(applicationspecificintegratedcircuit,ASIC)、现成可编程门阵列(field‑programmablegatearray,FPGA)或者其他可编程逻辑器件、分立门、晶体管逻辑器件或分立硬件组件,处理器1101可以实现或者执行本申请实施例中的公开的各处理相关的方法、步骤及逻辑框图。[0244] 结合本申请实施例所公开的方法的步骤可以直接体现为硬件译码处理器执行完成,或者用译码处理器中的硬件及软件模块组合执行完成。其中,软件模块可以位于随机存储器、只读存储器、可编程只读存储器或带电可擦写可编程存储器(electricallyerasableprogrammablereadonlymemory,EEPROM)等本领域成熟的存储介质中。该存储介质位于存储器1104,处理器1101读取存储器1104中的信息,结合其硬件完成上述方法的步骤。[0245] 处理器1101、存储器1104以及通信接口1103之间可以通过通信线路1102进行通信。[0246] 在上述实施例中,存储器存储的供处理器执行的指令可以以计算机程序产品的形式实现。其中,计算机程序产品可以是事先写入在存储器中,也可以是以软件形式下载并安装在存储器中。[0247] 本申请实施例还提供一种计算机程序产品包括一个或多个计算机指令。在计算机上加载和执行计算机程序指令时,全部或部分地产生按照本申请实施例的流程或功能。计算机可以是通用计算机、专用计算机、计算机网络或者其他可编程装置。计算机指令可以存储在计算机可读存储介质中,或者从一个计算机可读存储介质向另一计算机可读存储介质传输,例如,计算机指令可以从一个网站站点、计算机、服务器或数据中心通过有线(例如同轴电缆、光纤、数字用户线(digitalsubscriberline,DSL)或无线(例如红外、无线、微波等)方式向另一个网站站点、计算机、服务器或数据中心进行传输。计算机可读存储介质可以是计算机能够存储的任何可用介质或者是包括一个或多个可用介质集成的服务器、数据中心等数据存储设备。例如,可用介质可以包括磁性介质(例如,软盘、硬盘或磁带)、光介质(例如,数字通用光盘(digitalversatiledisc,DVD))、或者半导体介质(例如,固态硬盘(solidstatedisk,SSD))等。[0248] 本申请实施例还提供一种计算机可读存储介质。上述实施例中描述的方法可以全部或部分地通过软件、硬件、固件或者其任意组合来实现。计算机可读介质可以包括计算机存储介质和通信介质,还可以包括任何可以将计算机程序从一个地方传送到另一个地方的介质。存储介质可以是可由计算机访问的任何目标介质。[0249] 作为一种可能的设计,计算机可读介质可以包括紧凑型光盘只读储存器(compactdiscread‑onlymemory,CD‑ROM)、RAM、ROM、EEPROM或其它光盘存储器;计算机可读介质可以包括磁盘存储器或其它磁盘存储设备。而且,任何连接线也可以被适当地称为计算机可读介质。例如,如果使用同轴电缆,光纤电缆,双绞线,DSL或无线技术(如红外,无线电和微波)从网站,服务器或其它远程源传输软件,则同轴电缆,光纤电缆,双绞线,DSL或诸如红外,无线电和微波之类的无线技术包括在介质的定义中。如本文所使用的磁盘和光盘包括光盘(CD),激光盘,光盘,数字通用光盘(digitalversatiledisc,DVD),软盘和蓝光盘,其中磁盘通常以磁性方式再现数据,而光盘利用激光光学地再现数据。[0250] 本申请实施例是参照根据本申请实施例的方法、设备(系统)、和计算机程序产品的流程图和/或方框图来描述的。应理解可由计算机程序指令实现流程图和/或方框图中的每一流程和/或方框、以及流程图和/或方框图中的流程和/或方框的结合。可提供这些计算机程序指令到通用计算机、专用计算机、嵌入式处理机或其他可编程数据处理设备的处理单元以产生一个机器,使得通过计算机或其他可编程数据处理设备的处理单元执行的指令产生用于实现在流程图一个流程或多个流程和/或方框图一个方框或多个方框中指定的功能的装置。
专利地区:广东
专利申请日期:2023-03-28
专利公开日期:2024-10-18
专利公告号:CN117079659B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西中科云创信息科技有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477