 产学研创新服务平台(全国)


一种基于表型曲线的作物生长模型优化方法及系统
更新时间:2026-07-23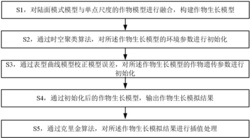 专利申请类型:发明专利;
源自:北京高价值专利检索信息库;
专利名称:一种基于表型曲线的作物生长模型优化方法及系统
专利类型:发明专利
专利申请号:CN202410658550.6
专利申请(专利权)人:中化现代农业有限公司
权利人地址:北京市西城区复兴门内大街28号818室
专利发明(设计)人:秦志珩,王宏斌,郭朝贺,杨子龙,黄海强,魏佳爽,张晓阳,刘志强,张馨宇
专利摘要:本发明涉及一种基于表型曲线的作物生长模型优化方法及系统,属于数据处理领域,包括:对陆面模式模型与单点尺度的作物模型进行融合,构建作物生长模型,可以实现区域范围的连续模拟;通过时空聚类算法,对作物生长模型的环境参数进行初始化;通过初始化后的作物生长模型,输出作物生长模拟结果;通过克里金算法,对作物生长模拟结果进行插值处理。本发明中,对陆面模式模型与单点尺度的作物模型进行融合,构建作物生长模型,可以实现区域范围的连续模拟,考虑了作物模型自身的特性,避免直接使用空间化数据,降低了系统误差,通过克里金算法,对离散的作物生长模拟结果进行空间连续插值处理,实现了模拟结果的空间化。
主权利要求:
1.一种基于表型曲线的作物生长模型优化方法,其特征在于,包括:S1,对陆面模式模型与单点尺度的作物模型进行融合,构建作物生长模型;
S2,通过时空聚类算法,对所述作物生长模型的环境参数进行初始化;
S3,通过表型曲线模型校正模型误差,对所述作物生长模型的作物遗传参数进行初始化;
S4,通过初始化后的作物生长模型,输出作物生长模拟结果;
S5,通过克里金算法,对所述作物生长模拟结果进行插值处理;
其中,所述S2具体包括:
S201,通过时空聚类算法,进行区域划分;
S202,对于每个划分区域,通过贝叶斯规则,估算环境参数的后验概率分布:;
其中,θ表示环境参数, 表示观测数据y在0到T时刻的后验概率分布,表示在环境参数随机分布条件下的模型模拟的似然, 表示环境参数的初始化先验概率分布;
S203,根据环境参数的后验概率分布,通过拉丁超立方采样,创建不同的环境参数组合;
S204,以环境参数组合作为所述作物生长模型的输入参数,通过所述作物生长模型生成作物生长模拟数据;
S205,以所述作物生长模拟数据与实际的作物生长观测数据之间的误差,构建代价函数:;
其中,C表示代价函数,exp()表示以自然常数e为底的指数函数,RMSE表示模拟值与真值的均方根误差,σ0表示收集作物生长观测数据时的观测误差;
S206,通过Metropolis‑Hastings算法,根据收敛率,确定最优环境参数;
所述收敛率具体为:
;
c
其中,α表示收敛率,θ 表示迭代模型时创建的候选环境参数,θi表示第i次迭代模型时的环境参数;
S207,根据所述最优环境参数,对所述作物生长模型的环境参数进行初始化;
其中,所述S3具体包括:
S301,构建遥感曲线;
S302,对所述遥感曲线进行校正;
S303,根据校正后的遥感曲线,构建基于作物遗传参数的表型曲线模型:;
其中,g表示基于作物遗传参数的表型曲线模型,k表示空间位置,t表示时间,xt表示时序协变量, 表示作物模型所需的作物遗传参数的向量,sk(t)表示空间位置k处的校正后的遥感曲线,表示近似符号;
所述作物遗传参数包括:生育期性状参数、表型数量特征参数;
所述表型数量特征参数具体为不同生育期的变化范围:;
其中, 表示表型数量特征e的参数集,T(a)、T(b)表示第a、b个时间点, 、表示相对应的关键生育期节点,fe(t)表示表型的数量特征e的时间函数;
S304,通过作物表型的协变量响应特征模型,对基于作物遗传参数的表型曲线模型进行改进:;
其中, 表示作物表型的协变量响应特征模型,协变量响应特征模型具体为CERES作物生长模型, 表示协变量参数;
S305,以作物遗传参数作为所述表型曲线模型的输入参数,通过所述表型曲线模型生成作物生长曲线;
S306,以生成的作物生长曲线与改进后的遥感曲线之间的误差最小为目标,确定各空间位置最优作物遗传参数;
S307,引入观测误差,对所述最优作物遗传参数进行校正;
S308,通过校正后的最优作物遗传参数,对所述作物生长模型的作物遗传参数进行初始化。
2.根据权利要求1所述的基于表型曲线的作物生长模型优化方法,其特征在于,所述S1具体为:基于Noah‑PM模型,以植被面积指数作为模拟过程量,引入CERES作物模型的动态生长过程,构建作物生长模型;
所述Noah‑PM模型是一种陆面过程模型,结合了Noah陆面模式和Penman‑Monteith公式。
3.根据权利要求1所述的基于表型曲线的作物生长模型优化方法,其特征在于,所述S201具体包括:S2011,获取时空数据,所述时空数据包括:气象数据和遥感数据;
S2012,根据所述时空数据,确定出中心对象和邻域对象;
S2013,计算当前邻域对象与中心对象之间的特征距离;
S2014,判断当前邻域对象与中心对象之间的特征距离是否小于预设距离;若是,将当前邻域对象分类至中心对象的区域类别中。
4.根据权利要求1所述的基于表型曲线的作物生长模型优化方法,其特征在于,所述S301具体包括:S3011,获取多源遥感数据;
S3012,对多源遥感数据进行协同融合,得到遥感时序数据;
S3013,对所述遥感时序数据进行过滤处理;
S3014,对过滤处理后的遥感时序数据,进行双逻辑曲线拟合:;
其中,s表示遥感曲线,t表示时间,vmin表示作物种植前的NDVI低值,v1是作物生育期中NDVI最高值与种植前低值之差,v2是作物生育期中NDVI最高值与收获后值之差,m1和n1分别为作物快速生长阶段的时序变化曲线的峰位和斜率,m2和n2分别为作物衰老阶段的峰位和斜率。
5.根据权利要求1所述的基于表型曲线的作物生长模型优化方法,其特征在于,所述S302具体包括:S3021,根据所述遥感曲线,对生长率模型进行拟合:;
其中,LAI表示植被面积指数,LAImax表示植被面积指数最大值,LAI0表示植被面积指数起始值,r表示生长率;
S3022,对生长率模型进行辐射影响校正:;
其中,A表示振幅,表示相位;
S3023,对生长率模型进行温度影响校正:;
;
其中,fT()表示温度校正函数,T()表示温度函数,TL表示作物生长最低温,TH表示作物生长最高温,TAL表示TL对应的Arrhenius温度,TAH表示TH对应的Arrhenius温度;
S3024,对生长率模型进行墒情影响校正:;
其中,c、d、v表示作物吸收土壤水分相关的参数,c表示作物的土壤水分最大吸收速率,d表示作物水通道蛋白酶的活性参数,v表示作物水分吸收结构体表面与其体积的比值,W()表示土壤墒情函数。
6.根据权利要求1所述的基于表型曲线的作物生长模型优化方法,其特征在于,所述S307具体包括:S3071,确定遥感曲线对第j年第k个空间位置上的响应:;
;
其中, 表示遥感曲线对第j年第k个空间位置上的响应,μ表示截距,g表示表型曲线模型的结果,vj表示第j年的主效应, 表示观测误差, 表示空间误差, 表示时序观测误差, 表示年际间误差;
S3072,对于第j年的t时刻的观测数据,通过SpATS算法,构建平滑双变量曲面模型,以确定作物模型的主效应和以及行列方向上的随机效应,并且表型数据的空间效应适用于作物参数:;
;
其中, 分别表示空间行列方向上的独立效应, 表示行列交互效应, 分别表示第t刻时间在行列方向上的影响效应,表示第t刻时间的行列交互效应, 表示第j年第k个空间位置上第n个作物参数的估计值, 表示第j年第n个作物参数的初始值, 分别表示第n个作物参数在空间行列方向的效应, 表示第n个作物参数的行列交互效应, 表示空间误差, 表示第n个作物参数的空间误差;
S3073,量化年际差异带来的不稳定性,对观测田块的作物参数聚合为一个值 ,然后使用ASReml‑R算法对年际间的差异进行校正:;
其中, 表示第j年的第n个作物参数, 表示第n个作物参数的拟合方程截距,表示第n个作物参数在第j年的主效应, 表示第n个作物参数, 表示第n个作物参数的主效应, 表示第n个作物参数与第j年的交互效应, 表示第n个作物参数在第j年的统计残差。
7.根据权利要求1所述的基于表型曲线的作物生长模型优化方法,其特征在于,所述S5具体包括:S501,以作物生长模拟结果中的植被面积指数作为主变量,以反演的植被面积指数作为协变量,作为克里金算法拟合半变异函数的参考数据,构造的空间和时间半变异函数:;
;
其中, 表示空间半变异函数, 表示时间半变异函数, 表示时空矩阵在空间变化方向的个数, 表示时间矩阵在时间变化方向的个数, 表示时空矩阵在t时刻p位置上的值, 表示空间变化量, 表示时间变化量, 表示矩阵在t时刻 位置上的值, 表示矩阵在 时刻p位置上的值;
S502,根据空间和时间半变异函数,通过克里金算法,拟合计算得出权重矩阵;
S503,根据所述权重矩阵,对所述作物生长模拟结果进行插值处理:;
其中, 表示t0时刻在位置x0处的预测值,T表示主变量的影像时相个数,Ni表示主变量的有效像素数,V表示协变量的影像时相个数,Mk表示协变量的有效像素数, 表示主变量在第i个时相的第j个有效像素上的权重, 表示协变量在第k个时相的第l个有效像素上的权重,Z1表示主变量,Z2表示协变量, 表示主变量于ti时刻在位置pij处的值, 表示协变量于vk时刻在位置ukl处的值。
8.一种基于表型曲线的作物生长模型优化系统,其特征在于,包括:存储器和一个或多个处理器;
所述存储器中存储有一个或多个应用程序,所述一个或多个应用程序适于由所述一个或多个处理器执行以实现权利要求1至7任一项所述的基于表型曲线的作物生长模型优化方法。 说明书 : 一种基于表型曲线的作物生长模型优化方法及系统技术领域[0001] 本发明属于数据处理领域,尤其涉及一种基于表型曲线的作物生长模型优化方法及系统。背景技术[0002] 作物模型可以通过模拟来帮助理解许多复杂的作物生长过程。开发之初,作物模型主要是根据特定的空间尺度或农田区域来设计的单点模型。但随着新的空间数据被提供,它们也越来越多应用在不同的区域和空间尺度上。对于作物空间化的需要主要有两个方面。一方面是模型的跨域迁移,比如在特定地点的作物管理应用中,由于精准农业需要,需要对不同田块进行差异化和变量化的管理。另一方面是模型的跨尺度应用,比如揭示和理解空间异质性时,作物模型局限于特定的空间尺度,因此使用上采样和下采样来理解不同空间尺度的模拟过程。因此,作物模型的空间化直接影响到作物模型的迁移应用和可拓展性。为了使作物模型空间化,可以在模型的输入输出阶段的空间化;也可以修改作物模型的流程框架来完成空间化。[0003] 然而,现有的作物模型是基于点尺度的模型,无法实现区域范围的连续模拟。现有的作物模型大多采用输入输出的空间化方法,本质为地理数据的预测,脱离了作物模型自身的特性,因此具有较大的系统误差。主要原因在于现有的作物模型直接使用的空间化数据,空间化数据的误差会直接传递到模型中。发明内容[0004] 鉴于以上现有技术的不足,发明的目的在于提供一种基于表型曲线的作物生长模型优化方法及系统,可以对陆面模式模型与单点尺度的作物模型进行融合,构建作物生长模型,可以实现区域范围的连续模拟,考虑了作物模型自身的特性,通过时空聚类算法,对所述作物生长模型的环境参数进行初始化,通过表型曲线模型校正模型误差,对所述作物生长模型的作物遗传参数进行初始化,之后通过初始化后的作物生长模型,输出作物生长模拟结果,避免直接使用空间化数据,降低了系统误差。[0005] 本发明的第一方面,提出了一种基于表型曲线的作物生长模型优化方法,包括:[0006] S1,对陆面模式模型与单点尺度的作物模型进行融合,构建作物生长模型;[0007] S2,通过时空聚类算法,对所述作物生长模型的环境参数进行初始化;[0008] S3,通过表型曲线模型校正模型误差,对所述作物生长模型的作物遗传参数进行初始化;[0009] S4,通过初始化后的作物生长模型,输出作物生长模拟结果;[0010] S5,通过克里金算法,对所述作物生长模拟结果进行插值处理。[0011] 本发明的第二方面,提出了一种基于表型曲线的作物生长模型优化系统,包括:存储器和一个或多个处理器。[0012] 存储器中存储有一个或多个应用程序,一个或多个应用程序适于由一个或多个处理器执行以实现第一方面的基于表型曲线的作物生长模型优化方法。[0013] 本发明的第三方面,提出了一种计算机可读存储介质,其上存储有计算机程序,该计算机程序能够被处理器加载和执行以第一方面的基于表型曲线的作物生长模型优化方法。[0014] 本发明有益效果如下:[0015] 本发明的方法和系统,对陆面模式模型与单点尺度的作物模型进行融合,构建作物生长模型,可以实现区域范围的连续模拟,考虑了作物模型自身的特性,通过时空聚类算法,对所述作物生长模型的环境参数进行初始化,实现了区域尺度的参数空间化,提升了模型的多环境适应性,通过表型曲线模型校正模型误差,对所述作物生长模型的作物遗传参数进行初始化,之后通过初始化后的作物生长模型,输出作物生长模拟结果,避免直接使用空间化数据,降低了系统误差,通过克里金算法,对离散的作物生长模拟结果进行空间连续插值处理,实现了模拟结果的空间化。附图说明[0016] 附图仅用于示出具体实施例的目的,而并不认为是对本发明的限制,在整个附图中,相同的参考符号表示相同的部件。显而易见地,下面描述中的附图仅仅是本发明实施例中记载的一些实施例,对于本领域普通技术人员来讲,还可以根据这些附图获得其他的附图。[0017] 图1为本发明实施例提供的一种基于表型曲线的作物生长模型优化方法的流程示意图;[0018] 图2为本发明实施例提供的一种基于表型曲线的作物生长模型优化系统的结构示意图。具体实施方式[0019] 为了使本领域的人员更好地理解本发明实施例中的技术方案,下面将结合附图对本发明的技术方案进行清楚、完整地描述,显然,所描述的实施例是本发明一部分实施例,而不是全部的实施例。应该理解,这些描述只是示例性的,并非用于限定本发明的范围。基于本发明的实施例,本领域普通技术人员在没有做出创造性劳动前提下所获得的所有其他实施例,都应当属于本发明保护的范围。[0020] 此外,在以下说明中,省略了对公知结构和技术的描述,以避免不必要地混淆本发明公开的概念。[0021] 在本发明的描述中,需要说明的是,除非另有明确的规定和限定,术语“中心”、“上”、“下”、“左”、“右”、“竖直”、“水平”、“内”、“外”等指示的方位或位置关系为基于附图所示的方位或位置关系,仅是为了便于描述本发明和简化描述,而不是指示或暗示所指的装置或元件必须具有特定的方位、以特定的方位构造和操作,因此不能理解为对本发明的限制。此外,术语“第一”、“第二”、“第三”仅用于描述目的,而不能理解为指示或暗示相对重要性。术语“安装”、“相连”、“连接”应做广义理解,例如,可以是固定连接,也可以是可拆卸连接,或一体地连接;可以是机械连接,也可以是电连接;可以是直接相连,也可以通过中间媒介间接相连,可以是两个元件内部的连通。对于本领域的普通技术人员而言,可以具体情况理解上述术语在本发明中的具体含义。[0022] 这里将详细地对示例性实施例进行说明,其示例表示在附图中。下面的描述涉及附图时,除非另有表示,不同附图中的相同数字表示相同或相似的要素。以下示例性实施例中所描述的实施方式并不代表与本发明相一致的所有实施方式。相反,它们仅是与如所附权利要求书中所详述的、本发明的一些方面相一致的方法和系统的例子。[0023] 本发明提出了一种基于表型曲线的作物生长模型优化方法及系统,为解决了现有的作物模型是基于点尺度的模型,无法实现区域范围的连续模拟。现有的作物模型大多采用输入输出的空间化方法,本质为地理数据的预测,脱离了作物模型自身的特性,因此具有较大的系统误差等问题。[0024] 方法实施例[0025] 参考说明书附图1,示出了本发明实施例提供的一种基于表型曲线的作物生长模型优化方法的流程示意图。[0026] 本发明实施例提供的一种基于表型曲线的作物生长模型优化方法,包括:[0027] 具体地,该方法包括步骤S1至步骤S5。[0028] S1,对陆面模式模型与单点尺度的作物模型进行融合,构建作物生长模型。[0029] 其中,陆面模式模型(LandSurfaceModel,LSM)是一种用于模拟地表过程的数值模型,它被广泛应用于气候、水文和生态系统研究中。LSM模型旨在描述地表的能量、水分和动量交换过程,以及地表和大气之间的相互作用。[0030] 其中,作物模型CGM(CEREScropgrowthmodel)是一个经典的作物生长模型,CGM模型旨在模拟主要粮食作物(如小麦、玉米、水稻等)的生长、发育和产量。[0031] 需要说明的是,传统的作物模型没有考虑作物对陆地‑大气相互作用的影响,这在跨区域的拓展中会对作物模拟产生较大影响,而陆面模式模型实现了关键的陆地‑大气相互作用过程,并且陆面模式模型是对地表空间的连续模拟。因此,为满足作物模型对空间化的需要,将作物模型与陆面模式模型进行结合。[0032] 在一种可能的实施方式中,S1具体为:基于Noah‑PM模型,以植被面积指数作为模拟过程量,引入CERES作物模型的动态生长过程,构建作物生长模型。[0033] 其中,Noah‑PM模型是一种陆面过程模型,旨在模拟和预测地表能量和水分交换过程,包括土壤水分运动、植被生长、蒸发蒸腾等。该模型结合了美国国家气象中心(NCEP)的Noah陆面模式和美国农业部的Penman‑Monteith公式,能够较准确地模拟地表能量和水分过程,是地球系统模型(ESM)中常用的一个组成部分。[0034] 其中,植被面积指数(LeafAreaIndex,简称LAI)是用于描述植被茂密程度的一个重要指标。它是指单位地面积上植被叶面积的总和,通常以叶面积与地面面积的比值来表示。LAI的数值范围通常在0到无穷大之间,表示地面单位面积上植被叶片的表面积。[0035] 其中,CERES作物模型是一个经典的作物生长模型。CERES代表“CropEstimationthroughResourceandEnvironmentSynthesis”(通过资源和环境综合进行作物估计)。该模型旨在模拟主要粮食作物(如小麦、玉米、水稻等)的生长、发育和产量。[0036] 进一步地,作物生长模型计算的植被面积指数,这反过来又直接影响地表辐射、光合作用过程、土壤湿度和地表能量通量,这种作物与陆地‑气候的相互影响反应了不同地区的农田气候特征,使用Noah‑PM模型对农田环境的陆面模式进一步调整,最终实现作物模型的空间化。[0037] 在本发明中,传统的作物模型通常只考虑了作物内部的生长过程,而忽略了作物与地表环境和大气之间的相互作用。融合了陆面模式模型的LSM后,作物模型可以更准确地考虑作物对地表能量、水分和动量的影响,从而更真实地反映作物的生长情况。同时,LSM模型具有对地表空间的连续模拟能力,能够在区域范围内模拟地表的能量和水分分布情况。通过将作物模型与LSM融合,可以将作物模拟扩展到空间尺度,实现对不同地区的作物生长情况进行连续模拟,从而更好地理解和预测作物在不同地理环境下的生长特征。[0038] 综上,将作物模型与陆面模式模型融合,可以综合考虑作物与地表环境和大气之间的相互作用,实现对作物生长的空间化模拟,提高模拟精度,并更好地应对气候变化等挑战,为农业生产和管理提供更科学的决策支持。[0039] S2,通过时空聚类算法,对作物生长模型的环境参数进行初始化。[0040] 其中,时空聚类算法是一种用于处理时空数据的聚类方法。它将考虑到数据点的时间和空间信息,以便将它们划分为具有相似特征的组。这种算法在许多领域中都有广泛的应用,包括地理信息系统(GIS)、气象学、环境科学等。[0041] 需要说明的是,据不同地区的空间变异特征,需要对模型进行区域化的调整。因此,在对模型进行参数率定前需要进行区划划分。此外,由于耦合模型包含了作物生理、物理模型和地表过程的复杂参数,模型的参数化设置极具挑战。根据地理学第一定律,区域范围内的地理环境具有相近地理特征。因此首先使用气象和遥感数据进行空间聚类,通过划分同质化种植区域作为代表样点,来降低对空间全域进行模型调参的计算成本。[0042] 在一种可能的实施方式中,S2具体包括子步骤S201至S207:[0043] S201,通过时空聚类算法,进行区域划分。[0044] 在一种可能的实施方式中,S201具体包括:[0045] S2011,获取时空数据。[0046] 其中,时空数据包括:气象数据和遥感数据。[0047] S2012,根据时空数据,确定出中心对象和邻域对象。[0048] S2013,计算当前邻域对象与中心对象之间的特征距离:[0049][0050] 其中,Dist表示中心对象与邻域对象之间的特征距离。 表示中心对象的特征值, 表示邻域对象的特征值,i表示表示x轴方向上的邻近数,j表示y轴方向上的邻近数,k表示z轴方向上的邻近数。[0051] S2014,判断当前邻域对象与中心对象之间的特征距离是否小于预设距离。若是,将当前邻域对象分类至中心对象的区域类别中。[0052] 可选地,最终的聚类的形状大体分为三种:圆柱簇、饼状簇和球形簇。[0053] 其中,圆柱簇簇在空间方向上的范围较小,但在时间方向上具有较大的范围,这代表了一种在空间中相对稳定但持续很长时间的情况;饼状簇在空间方向上具有较大的范围,但在时间方向上具有较小的范围,这代表了一种在空间上分布广泛但持续时间很短的情况;球状簇在空间和时间方向上具有相对均匀的分布表现。[0054] 在本发明中,不同类型的簇代表着不同的时空模式。通过将区域划分为这些不同类型的簇,可以更好地理解时空数据的模式和规律。同时,将区域划分为几种不同类型的簇可以简化对时空数据的解释。通过识别出这些基本模式,可以更轻松地解释数据中的复杂时空关系,为决策提供更直观和清晰的信息。[0055] 进一步地,通过聚类将具有相同地理环境特征的区域进行统一的模型模拟,再降低调参计算成本的同时,可以从聚类数据中准确获得当地的模型参数。[0056] S202,对于每个划分区域,通过贝叶斯规则,估算环境参数的后验概率分布:[0057][0058] 其中,θ表示环境参数, 表示观测数据yo在0到T时刻的后验概率分布, 表示在环境参数随机分布条件下的模型模拟的似然, 表示环境参数的初始化先验概率分布。[0059] 其中,贝叶斯规则是一种基于贝叶斯定理的概率推断方法,用于更新先验概率为后验概率,是概率统计学中重要的工具。[0060] 在本发明中,使用贝叶斯规则,将观测数据和先验知识结合起来,能够全面考虑不确定性,得到环境参数的后验概率分布。这有助于更好地理解参数估计的不确定性,并提高模型的可靠性。[0061] S203,根据环境参数的后验概率分布,通过拉丁方超采样,创建不同的环境参数组合。[0062] 其中,拉丁方超采样(LatinHypercubeSampling)是一种设计实验样本的方法,用于在多维参数空间内均匀地选择样本点,以代表参数空间中的不同组合。这种采样方法在工程、统计学、计算机模拟和优化等领域都得到了广泛应用。[0063] 在本发明中,拉丁方超采样方法可以在多维参数空间内均匀地选择样本点,从而高效地探索参数空间,确保覆盖了多样的参数组合,有助于找到全局最优解。[0064] S204,以环境参数组合作为作物生长模型的输入参数,通过作物生长模型生成作物生长模拟数据。[0065] S205,以作物生长模拟数据与实际的作物生长观测数据之间的误差,构建代价函数:[0066][0067] 其中,C表示代价函数,exp()表示以自然常数e为底的指数函数,RMSE表示模拟值与真值的均方根误差,σ0表示收集作物生长观测数据时的观测误差。[0068] 在本发明中,通过使用作物生长模型生成的模拟数据与实际观测数据之间的差异构建代价函数,可以有效评估模型的拟合程度,并通过Metropolis‑Hastings算法优化参数,从而更好地拟合实际情况。[0069] S206,通过Metropolis‑Hastings算法,根据收敛率,确定最优环境参数。[0070] 收敛率具体为:[0071][0072] 其中,α表示收敛率,θc表示迭代模型时创建的候选环境参数,θi表示第i次迭代模型时的环境参数。[0073] 其中,Metropolis‑Hastings算法是一种马尔科夫链蒙特卡洛(MCMC)方法,用于从复杂的概率分布中抽取样本。[0074] 需要说明的是,通过代价函数C计算实际的作物生长观测数据与作物生长模拟数据之间的差异。之后通过代价函数计算的收敛率来确定是否接受改组环境参数。基于不同组合参数生成的数据,使用Metropolis‑Hastings算法迭代计算最优环境参数。[0075] 在本发明中,Metropolis‑Hastings算法通过迭代计算,根据收敛率确定最优环境参数,能够在参数空间中快速、有效地搜索,并逐步逼近最优解。[0076] S207,根据最优环境参数,对作物生长模型的环境参数进行初始化。[0077] 在本发明中,根据最优环境参数,对作物生长模型的环境参数进行初始化,有助于提高模型的准确性和稳定性。[0078] S3,通过表型曲线模型校正模型误差,对作物生长模型的作物遗传参数进行初始化。[0079] 在一种可能的实施方式中,S3具体包括子步骤S301至S308:[0080] S301,构建遥感曲线。[0081] 在一种可能的实施方式中,S301具体包括:[0082] S3011,获取多源遥感数据。[0083] 其中,遥感数据可以来源于Sentinel‑2A/B—MSI传感器和Landsat‑8/9—OLI传感器。[0084] 其中,Sentinel‑2A/B—MSI(Multi‑SpectralInstrument)是欧洲空间局(ESA)的一对卫星传感器,它们搭载了MSI传感器,能够提供高空间分辨率、多光谱、全球覆盖的地球表面影像数据。[0085] 其中,Landsat‑8和Landsat‑9搭载了OLI(OperationalLandImager)传感器,是美国地质调查局(USGS)和NASA合作的一对卫星任务,旨在提供全球范围内的陆地观测数据,以支持地球科学研究、资源管理、环境监测和应对自然灾害等方面的应用。[0086] 在本发明中,结合Sentinel‑2A/B—MSI和Landsat‑8/9—OLI传感器的数据,可以获取更全面、高质量的遥感信息,提高了监测的准确性和可靠性。[0087] S3012,对多源遥感数据进行协同融合,得到遥感时序数据。[0088] 需要说明的是,将Sentinel‑2A/B的L2级地表反射率数据与Landsat‑8/9的L2级地表反射率数据进行协同融合,根据传感器自己的双向反射分布函数(BRDF)对反射率数据进行BRDF校正。然后,建立两传感器光谱响应函数(SRF)之间的回归关系,将OLI传感器的反射率数据协调至MSI传感器的波段数据。由于本发明的最小单元为田块,因此按田块范围对反射率数据进行聚合。最终,每个田块会产生两条时序数据,并将两条来自MSI传感器和OLI传感器的反射率按时间维度融合成一条时序数据。[0089] 在本发明中,通过对多源数据进行协同融合,得到了一条时序数据,这有助于维持连续性和一致性,便于后续处理和分析。[0090] S3013,对遥感时序数据进行过滤处理。[0091] 需要说明的是,由于传感器不稳定、大气环境、地表环境等因素的影响,遥感影响会产生异常数据,也相应在时序数据中产生不合理的震荡波动。为了消除异常值的干扰,并使时序数据的变化能够符合作物生长的特征规律,本发明针对遥感的NDVI指数构建了遥感时序数据重构方法。[0092] 其中,NDVI(NormalizedDifferenceVegetationIndex,归一化植被指数)是一种用来评估地表植被覆盖程度和生长状态的常用指标。它基于遥感数据,特别是红外波段和近红外波段的反射率,能够有效地反映出植被的光合作用和生长情况。[0093] 可选地,过滤处理包括对时序序列进行包络过滤和对时序序列进行谐波过滤。[0094] 其中,对时序序列进行包络过滤,是通过创建曲线包络可以过滤掉云遮挡造成的异常数据,保留下反应作物生长信息的高质量数据。避免了归一化植被指数的突然下降。[0095] 其中,对时序序列进行谐波过滤,经过多源数据的融合,在作物3‑4个月的生长周期中时序序列的长度大于15。使用6次谐波构建谐波拟合模型,以保证拟合结果更好兼顾原始数据的整体特征和细节特征,并在拟合过程中使用阈值法过滤掉因地表环境因素和传感器感光元件造成的细微震荡。[0096] 在本发明中,采用NDVI指数构建的时序数据重构方法,结合包络过滤和谐波过滤等技术,能够有效消除异常值的干扰,提高数据的可靠性和稳定性。[0097] S3014,对过滤处理后的遥感时序数据,进行双逻辑曲线拟合:[0098][0099] 其中,s表示遥感曲线,t表示时间,vmin表示作物种植前的NDVI低值,v1是作物生育期中NDVI最高值与种植前低值之差,v2是作物生育期中NDVI最高值与收获后低差,m1和n1分别为作物快速生长阶段的时序变化曲线的峰位和斜率,m2和n2分别为作物衰老阶段的峰位和斜率。[0100] 需要说明的是,作物的全生育生长包括了营养生长、生殖生长和衰老阶段。在营养生长阶段,作物会在第2至第4个物候期阶段快速生长,NDVI曲线的响应为快速上升;在生殖生长阶段,作物的生物量和叶面积指数逐渐稳定于最高水平,并会保持2‑3个物候期的时长,NDVI曲线的响应为在最高值持续较长的时间;在衰老阶段,作物生物量逐渐下降,而植被面积指数会随衰老的进程加速下降,NDVI曲线的响应为从最高值下降并且下降速率递增。为了表征这些特征,本文使用了双逻辑曲线对过滤后的数据进行拟合。[0101] 在本发明中,通过对过滤后的遥感时序数据进行双逻辑曲线拟合,可以更准确地描述作物生长过程中不同阶段的特征和变化规律,为作物生长状态的监测和分析提供了更可靠的基础。[0102] 进一步地,整合了多种遥感数据和分析方法,可以实现对作物生长过程的全面监测和分析,为农业生产、资源管理、环境监测等领域提供了重要的支持和参考。[0103] S302,对遥感曲线进行校正。[0104] 需要说明的是,本发明构建的遥感曲线已基本反映出LAI的全生育期变化特征,但为更好的体现作物自身生长特点与环境影响下的表型特征(G×M),对表型曲线进行了进一步构建和校正。[0105] 在一种可能的实施方式中,S302具体包括:[0106] S3021,根据遥感曲线,对生长率模型进行拟合:[0107][0108] 其中,LAI表示植被面积指数,LAImax表示植被面积指数最大值,LAI0表示植被面积指数起始值,r表示生长率。[0109] S3022,对生长率模型进行辐射影响校正:[0110][0111] 其中,A表示振幅, 表示相位。[0112] 需要说明的是,光照是作物生长的限制因素之一。每日LAI变化的生长率由具有振幅A和相位 的正弦函数进行辐射影响校正。[0113] S3023,对生长率模型进行温度影响校正:[0114][0115][0116] 其中,fT()表示温度校正函数,T()表示温度函数,TL表示作物生长最低温,TH表示作物生长最高温,TAL表示TL对应的Arrhenius温度,TAH表示TH对应的Arrhenius温度。[0117] S3024,对生长率模型进行墒情影响校正:[0118][0119] 其中,c、n、v表示作物吸收土壤水分相关的参数,c表示作物的土壤水分最大吸收速率,n表示作物水通道蛋白酶的活性参数,v表示作物水分吸收结构体表面与其体积的比值,W()表示土壤墒情函数。[0120] 需要说明的是,土壤墒情是作物生长的限制因素之一。作物从土壤吸收水分,受到水通道蛋白活性和扩散速率的限制,因此由Michaelis‑Menten函数描述墒情的影响。[0121] 其中,Michaelis‑Menten函数被用来描述土壤墒情对作物生长率的影响。通过将土壤墒情函数代入Michaelis‑Menten函数中,可以描述墒情对作物生长的限制效应。[0122] 在本发明中,通过对生长率模型进行拟合、辐射影响、温度影响和墒情影响等多方面的校正,得到的生长模型更加贴近实际情况。这样的模型能够更准确地预测作物的生长情况,为农业生产提供更精准的决策依据。同时生长率模型的校正考虑了光照、温度和土壤墒情等多种环境因素对作物生长的影响。这样可以全面地考虑作物生长过程中的各种外部条件,使得模型更具可靠性和适用性。[0123] S303,根据校正后的遥感曲线,构建基于作物遗传参数的表型曲线模型:[0124][0125] 其中,g表示基于作物遗传参数的表型曲线模型,k表示空间位置,t表示时间,xt表示时序协变量, 表示作物模型所需的作物遗传参数的向量,sk(t)表示空间位置k处的校正后的遥感曲线, 表示近似符号。[0126] 作物遗传参数包括:生育期性状参数、表型数量特征参数。[0127] 具体地,生育期性状参数可以包括物候期、最快生长时间点、开花时间等。表型数量特征参数可以包括拔节时的分蘖数、分蘖至拔节之间的平均冠层覆盖度等。[0128] 可选地,表型数量特征参数具体为不同生育期的变化范围:[0129][0130] 其中, 表示表型数量特征k的参数集,T(a)、T(b)表示第a、b个时间点,、 表示相对应的关键生育期节点,fk(t)表示表型的数量特征k的时间函数。[0131] 其中,生育期性状参数是基于作物表型曲线的变化率特征,本发明构建了作物物候期节点与表型曲线特征的经验对照关系。以玉米为例,对构建的表型曲线计算出4个曲率最小点和3个曲率最大点,7个特征点依次对应于玉米的三叶期、拔节期、15叶期、开花期、乳熟期、蜡熟期、收获期,其余关键生育期节点按照物候期时长数据库确定。[0132] 其中,作物生长的表型数量特征参数,描述了每个生育阶段中,表型参量的变化范围,也是此生育期阶段的累计值。本发明针对叶面积指数这个表型参量,表示作物生长的表型数量特征参数在不同生育期的变化范围。[0133] 需要说明的是,作物模型在不同区域具有空间异质性特征,为了能准确获取该特征,需要通过表型曲线将观测特征与作物模型机理特征建立联系。在观测特征方面,使用上一步所构建的观测表型曲线;在作物模型机理特征方面,使用CERES作物生长模型的叶面积指数模块模拟作物生长过程。[0134] 在本发明中,将正后的遥感曲线与作物模型的机理特征相结合,实现了观测数据和模型的有效融合。这样可以综合考虑实测数据和模型的物理机理,提高了模拟结果的可信度和适用性。同时,作物模型在不同区域可能存在空间异质性特征,即同一种作物在不同地区可能表现出不同的生长规律。通过基于作物遗传参数的表型曲线模型,能够准确地获取不同区域的空间异质性特征,使得作物生长模拟更为精准和可靠。[0135] 进一步地,通过引入作物遗传参数,将作物的生长特性纳入模型中进行描述。这样的参数化建模方法使得模型更加灵活和可调节,能够适应不同作物品种和不同生长环境的需求。同时,通过对作物生长过程中关键生育期节点的准确定义和描述,可以更加准确地捕捉到作物不同生育阶段的特征和变化规律,为农业生产提供了更可靠的参考和决策依据。[0136] S304,通过作物表型的协变量响应特征模型,对基于作物遗传参数的表型曲线模型进行改进:[0137][0138] 其中, 表示作物表型的协变量响应特征模型,协变量响应特征模型具体为CERES作物生长模型, 表示协变量参数。[0139] 需要说明的是,作物生长过程会受到各种环境协变量因素的影响,作物对环境因子的响应特征是组成作物生长模型机理性的关键。[0140] S305,以作物遗传参数作为表型曲线模型的输入参数,通过作表型曲线模型生成作物生长曲线。[0141] S306,以生成的作物生长曲线与改进后的遥感曲线之间的误差最小为目标,确定各空间位置最优作物遗传参数。[0142] S307,引入观测误差,对最优作物遗传参数进行校正。[0143] 需要说明的是,求解最优作物遗传参数后,需要分析遥感曲线和表型曲线模型的数值不确定性。遥感数据的观测误差以及作物模型参数的时间变异、空间变异并且受到环境协变量的影响,这些不稳定性都会导致观测值与模拟值出现差异,因此,需要引入观测误差,对最优作物遗传参数进行校正。[0144] 在一种可能的实施方式中,S307具体包括:[0145] S3071,确定遥感曲线对第j年第k个空间位置上的响应:[0146][0147][0148] 其中, 表示遥感曲线对第j年第k个空间位置上的响应,μ表示截距,g表示表型曲线模型的结果,vj表示第j年的主效应, 表示第j年和作物模型的交互作用,表示观测误差, 表示空间误差, 表示时序观测误差, 表示年际间误差。[0149] 其中,时序观测误差是指由于观测过程中的测量误差或不确定性而引入的随机误差。即使在相同的条件下,对同一对象进行重复观测也可能产生不同的观测值。时序观测误差通常用于描述观测值与其真实值之间的随机偏差。[0150] 其中,年际间误差是指由于未考虑或未建模的年际变异性而导致的模型残差中的随机成分。在时间序列数据分析中,相邻时间点之间可能存在年际相关性或趋势,但模型未能捕捉到这种年际变异性,导致模型的残差中存在年际结构。年际间误差通常用于描述这种残差中的年际相关性或趋势。[0151] 其中,时序观测误差是指由于观测过程中的测量误差或不确定性而引入的随机误差。即使在相同的条件下,对同一对象进行重复观测也可能产生不同的观测值。时序观测误差通常用于描述观测值与其真实值之间的随机偏差。[0152] S3072,对于第j年的t时刻的观测数据,通过SpATS算法,构建平滑双变量曲面模型,以确定作物模型的主效应和以及行列方向上的随机效应,并且表型数据的空间效应适用于作物参数:[0153][0154][0155] 其中, 分别表示空间行列方向上的独立效应,表示行列交互效应。 分别表示第t刻时间在行列方向上的影响效应,表示第t刻时间的行列交互响应, 表示第j年第k个空间位置上第n个作物参数的估计值, 表示第j年第n个作物参数的初始值,分别表示第n个作物参数在空间行列方向的效应, 表示第n个作物参数的交互效应, 表示表型的空间误差, 表示第n个参数的空间误差。S3073,量化年际差异带来的不稳定性,对观测田块的作物参数聚合为一个值 ,然后使用ASReml‑R算法对年际间的差异进行校正:[0156][0157] 其中, 表示第j年的第n个作物参数, 表示第n个作物参数的拟合方程截距,表示第n个作物参数在第j年的主效应, 表示第n个作物参数, 表示第n个作物参数的主效应, 表示第n个作物参数与第j年的交互效应, 表示第n个作物参数在第j年的统计残差。[0158] 在本发明中,引入观测误差、空间误差和年际间误差可以更准确地反映实际观测数据的特点和模型中未考虑的随机变异性。通过校正这些误差,可以提高作物生长模型对实际观测数据的拟合精度,从而增强模型的准确性和稳健性。同时,考虑到观测误差、空间误差和年际间误差,可以更全面地利用遥感数据和其他环境数据,充分挖掘数据中的信息,提高数据的利用效率和完整性。[0159] S308,通过校正后的最优作物遗传参数,对作物生长模型的作物遗传参数进行初始化。[0160] 在本发明中,通过对最优作物遗传参数进行校正和优化,可以更好地理解作物生长模型中不同参数的作用和影响,为农业生产提供更可操作的指导和决策支持。同时可以根据不同的作物类型、生长环境和观测条件进行灵活调整和适应,具有较强的适用性和通用性,可在不同的农业生产实践中进行应用和推广。[0161] 综上,通过引入观测误差、空间误差和年际间误差,对最优作物遗传参数进行校正和优化,可以提高作物生长模型的可靠性、准确性和适用性,为农业生产提供更有效的支持和指导。[0162] S4,通过初始化后的作物生长模型,输出作物生长模拟结果。[0163] S5,通过克里金算法,对作物生长模拟结果进行插值处理。[0164] 其中,克里金算法是一种地统计学方法,用于空间插值和地质建模。它基于地理空间上的点数据样本,通过对这些样本数据之间的空间相关性进行建模,来预测未知位置的数值。该算法的主要目标是通过已知点的数据值来估计未知位置的数值,从而实现空间上的插值。[0165] 在一种可能的实施方式中,S5具体包括子步骤S501至S503:[0166] S501,以作物生长模拟结果中的植被面积指数作为主变量,以反演的植被面积指数作为协变量,作为克里金算法拟合半变异函数的参考数据,构造的空间和时间半变异函数:[0167][0168][0169] 其中, 表示空间半变异函数, 表示时间半变异函数, 表示时空矩阵在空间变化方向的个数, 表示时间矩阵在时间变化方向的个数,表示时空矩阵在t时刻s位置上的值, 表示空间变化量, 表示时间变化量,表示矩阵在t时刻 位置上的值, 表示矩阵在时刻s位置上的值。S502,根据空间和时间半变异函数,通过克里金算法,拟合计算得出权重矩阵。[0170] 需要说明的是,克里金算法拟合了空间维度和时间维度上的半变异函数反演协方差矩阵,通过遥感反演的LAI数据用来拟合空间和时间上的半变异函数。同时根据拟合函数的临界上限确定了时空窗口的大小。[0171] 可选地,其中使用的时空窗口为850m范围的5日滑窗,每个窗口平均包含200个克里金主变量。[0172] S503,根据权重矩阵,对作物生长模拟结果进行插值处理:[0173][0174] 其中, 表示t0时刻在位置x0处的预测值,T表示主变量的影像时相个数,Ni表示主变量的有效像素数,V表示协变量的影像时相个数,Mk表示协变量的有效像素数, 表示主变量在第i个时相的第j个有效像素上的权重, 表示协变量在第k个时相的第l个有效像素上的权重,Z1表示主变量,Z2表示协变量, 表示主变量于ti时刻在位置Sij处的值, 表示协变量于vk时刻在位置ukl处的值。[0175] 需要说明的是,本发明使用逐日的10m分辨率植被面积指数表型数据作为克里金算法的协变量,通过半变异函数拟合计算得出权重矩阵,以对作物生长模型的模拟结果进行时空插值。[0176] 在本发明中,克里金算法可以利用地理空间上已知点的数据值来估计未知位置的数值,从而实现对作物生长模拟结果在空间上的连续性插值。这样可以填补空白区域,生成连续的空间表面,更好地展现作物生长的空间分布规律。同时,通过克里金算法对作物生长模拟结果进行时空插值,可以确保插值结果在时间上的一致性。这有助于生成连续的时序数据,更好地反映作物生长过程中的时间变化趋势,为决策提供更准确的时间信息。[0177] 进一步地,通过克里金算法对不同来源、不同时间、不同空间分辨率的作物生长模拟结果进行插值,可以实现数据的整合和统一,有助于将来自不同数据源的信息整合到同一个空间和时间框架中,提高了数据的可比性和可利用性。[0178] 本发明有益效果如下:[0179] 本发明的方法和系统,对陆面模式模型与单点尺度的作物模型进行融合,构建作物生长模型,可以实现区域范围的连续模拟,考虑了作物模型自身的特性,通过时空聚类算法,对所述作物生长模型的环境参数进行初始化,实现了区域尺度的参数空间化,提升了模型的多环境适应性,通过表型曲线模型校正模型误差,对所述作物生长模型的作物遗传参数进行初始化,之后通过初始化后的作物生长模型,输出作物生长模拟结果,避免直接使用空间化数据,降低了系统误差,通过克里金算法,对离散的作物生长模拟结果进行空间连续插值处理,实现了模拟结果的空间化。[0180] 系统实施例[0181] 参考说明书附图2,示出了本发明实施例提供的一种基于表型曲线的作物生长模型优化系统的结构示意图。[0182] 本发明提出一种基于表型曲线的作物生长模型优化系统30,包括:存储器303和一个或多个处理器301。[0183] 所述存储器303中存储有一个或多个应用程序,所述一个或多个应用程序适于由所述一个或多个处理器301执行以实现方法实施例所述的基于表型曲线的作物生长模型优化方法。[0184] 基于表型曲线的作物生长模型优化系统30包括:处理器301和存储器303。其中,处理器301和存储器303相连,如通过总线302相连。[0185] 该基于表型曲线的作物生长模型优化系统30的结构并不构成对本发明实施例的限定。[0186] 本发明有益效果如下:[0187] 本发明的方法和系统,对陆面模式模型与单点尺度的作物模型进行融合,构建作物生长模型,可以实现区域范围的连续模拟,考虑了作物模型自身的特性,通过时空聚类算法,对所述作物生长模型的环境参数进行初始化,实现了区域尺度的参数空间化,提升了模型的多环境适应性,通过表型曲线模型校正模型误差,对所述作物生长模型的作物遗传参数进行初始化,之后通过初始化后的作物生长模型,输出作物生长模拟结果,避免直接使用空间化数据,降低了系统误差,通过克里金算法,对离散的作物生长模拟结果进行空间连续插值处理,实现了模拟结果的空间化。[0188] 处理器301可以是CPU,通用处理器,DSP,ASIC,FPGA或者其他可编程逻辑器件、晶体管逻辑器件、硬件部件或者其任意组合。其可以实现或执行结合本发明公开内容所描述的各种示例性的逻辑方框,模块和电路。处理器301也可以是实现计算功能的组合,例如包含一个或多个微处理器组合,DSP和微处理器的组合等。[0189] 总线302可包括一通路,在上述组件之间传送信息。总线302可以是PCI总线或EISA总线等。总线302可以分为地址总线、数据总线、控制总线等。为便于表示,图中仅用一条粗线表示,但并不表示仅有一根总线或一种类型的总线。[0190] 存储器303可以是ROM或可存储静态信息和指令的其他类型的静态存储设备,RAM或者可存储信息和指令的其他类型的动态存储设备,也可以是EEPROM、CD‑ROM或其他光盘存储、光碟存储(包括压缩光碟、激光碟、光碟、数字通用光碟、蓝光光碟等)、磁盘存储介质或者其他磁存储设备、或者能够用于携带或存储具有指令或数据结构形式的期望的程序代码并能够由计算机存取的任何其他介质,但不限于此。[0191] 计算机可读存储介质实施例[0192] 本发明提出一种计算机可读存储介质,其上存储有计算机程序,该计算机程序能够被处理器加载和执行以第一方面所述的基于表型曲线的作物生长模型优化方法。[0193] 本发明申请人结合说明书附图对本发明的实施示例做了详细的说明与描述,但是本领域技术人员应该理解,以上实施示例仅为本发明的优选实施方案,详尽的说明只是为了帮助读者更好地理解本发明精神,而并非对本发明保护范围的限制,相反,任何基于本发明的发明精神所作的任何改进或修饰都应当落在本发明的保护范围之内。[0194] 最后应说明的是,以上实施例仅用以说明本发明实施例的技术方案,而非对其限制。尽管参照前述实施例对本发明进行了详细的说明,本领域的普通技术人员应当理解:其依然可以对前述各实施例所记载的技术方案进行修改,或者对其中部分技术特征进行等同替换;而这些修改或者替换,并不使相应技术方案的本质脱离本发明各实施例技术方案的精神和范围,任何熟悉本技术领域的技术人员在本发明公开的技术范围内,可轻易想到的变化或替换,都应涵盖在本发明的保护范围之内。
专利地区:北京
专利申请日期:2024-05-27
专利公开日期:2024-11-12
专利公告号:CN118313160B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。
本平台为商业科创服务平台 非政府政务服务网站
技术及运营:陕西弈聪软件信息技术股份有限公司
工信部备案号:陕ICP备16002714号-3
公安备案号: 陕公网安备61019402000311号
联系电话:+86-13679229477




