 产学研创新服务平台(全国)


基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法
更新时间:2026-10-01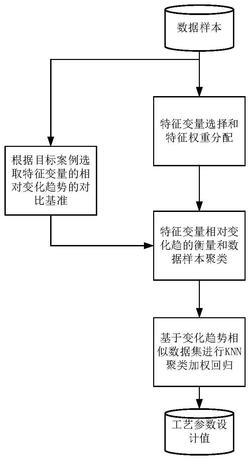 专利申请类型:发明专利;
地区:广西-南宁;
源自:南宁高价值专利检索信息库;
专利名称:基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法
专利类型:发明专利
专利申请号:CN202111369827.6
专利申请(专利权)人:广西大学
权利人地址:广西壮族自治区南宁市西乡塘区大学路100号
专利发明(设计)人:邓建新,谢彬,刘光明,王令,曾向明,贺德强,黄海宾,李先旺,吴秀松,刘港
专利摘要:本发明提供基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法,属于工艺参数设计技术领域,工艺参数设计方法首先基于相似原理对工艺参数的相关变量的相对变化趋势进行衡量。在此基础上提取与目标案例的相关变量相对变化趋势相似的样本数据,基于这些样本数据,进行KNN聚类并对聚类样本中的对应参数进行加权回归作为目标案例的工艺参数设计值。该设计方法基于已有的研究数据,充分参考利用了现有的相关研究成果,无需进行繁琐的实验研究且工艺参数的设计精度较高。相比于现有的工艺参数设计方法,节省了大量的时间成本和实验成本。该方法具有普适性,不仅适用于挤压铸造工艺参数的设计,对于其它类似领域的参数设计同样适用。
主权利要求:
1.基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法,其特征在于,所述方法包括如下步骤:步骤1:挤压铸造工艺数据表示,对于已有挤压铸造工艺参数数据集case,表示为case={Si|i=1,2,…,m},m为数据样本的个数,每个样本数据包含挤压铸造的工艺参数、材料成分数据和形状特征数据的属性变量,按照性质将样本属性划分为工艺参数的影响因素Xk,其中k=1,2,...,t,t表示工艺影响因素的个数,和工艺参数Yj,其中j=1,2,...,n,n表示工艺参数的个数,商品数据样本Si的对应属性数据分别为xik和yij,挤压铸造的工艺参数包括挤压压力、浇注温度和模具预热温度;
步骤2:得到所设计的工艺参数的相关影响属性,对所设计的目标挤压铸件的特定工艺参数Yj,称为目标工艺参数,对应值为yoj,工艺参数的影响因素Xk并非都是工艺参数Yj的相关影响因素,利用SVM‑RFE算法从Xk中选取直接影响该工艺参数的相关属性,设为Xc={X1,X2,...,Xs};
步骤3:选出挤压铸造工艺参数数据集case中目标工艺参数Yj及其相关属性Xc所对应的* *数据,表示为case,基于熵权法和数据集case计算步骤1选取的相关属性Xc={X1,X2,...,Xs}的权重,区分Xc={X1,X2,...,Xs}对Yj的影响程度,得到相关属性的权重记为W={w1,w2,...,ws};
步骤4:进行相关属性Xc的相对变化趋势的衡量和工艺数据筛选,将对应的挤压铸造工艺参数数据视为N维变量集合,不同工艺参数数据的差异可视为N维变量运动、变化和发展的结果,根据步骤2选取的相关属性Xc={X1,X2,...,Xs},计算衡量已有工艺参数数据和待设计的目标工艺参数的相关属性的相对变化趋势,并筛选出与待设计的目标工艺参数的相* * * *关属性相对变化趋势程度最相近的工艺参数数据,设为S ={S1 ,S2,...,Sp},p为聚类所得的工艺参数数据数量;
* * * *
步骤5:应用KNN算法,对步骤4得到的聚类结果S ={S1,S2,...,Sp}加权聚类,然后对聚类结果进行加权求和,得到求和结果即为所所需的工艺参数Yj;
KNN算法的聚类和加权回归处理过程为:
步骤5.1:对数据进行预处理,利用数据归一化方法消除不同相关属性之间不同纲量的影响,即为步骤2选取的s个相关属性,具体过程为:其中,xis为Xc中的第i行第s列;
步骤5.2:计算样本间的距离,根据步骤3得到的相关属性权重,通过计算加权欧氏距离*衡量属性空间Xc内S中的数据样本与目标铸件O的Xc各属性之间的距离dlO,(l=1,2,…,p),*′并根据距离的大小取K个与目标铸件O最近邻的工艺数据样本S ,最近邻即为距离最小,距离计算如下所示:*
其中,xlc为S中第l个样本的第c个属性值,oc为目标数据O中第c个属性值;
*′ *′
步骤5.3:把S 根据与目标样本之间的距离对S 各个聚类样本赋权,得到聚类样本的权重 样本权重计算如下式所示:*′
其中, 是S 第i′个样本的权重;
步骤5.4:根据步骤5.3所得样本权重,对所求的工艺参数进行加权求和,求和结果即为所设计的目标的工艺参数yoj的值,工艺参数计算如下式所示:
2.根据权利要求1所述的基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法,其特征在于:步骤2中,基于SVM‑RFE算法相关属性的选取过程为,基于PyCharm平台,从sklearn.feature_selection和sklearn.svm模块分别导入RFE和SVE功能模块,SVM‑RFE算法的具体过程为,以工艺参数的影响因素Xk和工艺参数Yj作为模型的输入数据,其中k=1,
2,...,t,使用特征变量训练模型,计算每个特征变量的重要性排序标准,剔除最不重要的K个特征,保留其余特征,并判断剩余特征数量达到简约要求,若果达到,从Xk中选取工艺参数Yj的相关属性Xc={X1,X2,...,Xs},如果没有达到重复计算。
3.根据权利要求1所述的基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法,其特征在于:步骤3中基于熵权法的相关属性的权重分配过程为:*
步骤3.1,将case*按下公式组成一个新的矩阵O:
*
步骤3.2:采用极差化法将O标准化得到新的矩阵π,然后对进行π归一化处理,极差化法和归一化方法如下式:* *
其中, 为O 中的第i行第s列元素; 为O 中的第s列;同理,bis为π中的第i行第s列元素,π’is为πis归一化的后的值;
步骤3.3:则Xc中第s个相关属性的信息熵定义为:
步骤3.4:工艺参数Yj有s个相关属性,则设定影响因素Xc对工艺参数Yj的影响权重为:Ec为影响因素Xc的信息熵。
4.根据权利要求1所述的基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法,其特征在于:步骤4中,相关属性的相对变化趋势的衡量和挤压铸造工艺数据筛选的处理过程如下:步骤4.1:记设计的目标铸件的目标工艺参数的相关属性Xc的数据为O={o1,o2,...,os},简称为目标数据,根据差异率,从case*中选取一组与其相对接近的数据为对比基准,*选择的原则是令基准C与O中的对位属性的值相差越小越好;
步骤4.2:为每个 添加一行与相关变量Xc维度相同的标签用于记录相关属性上对应数据{xi1,xi2,...,xis}相*
对基准的变化趋势,然后将case中除基准外的每一组挤压铸造工艺数据的相关属性数据*{xi1,xi2,...,xis}与基准C={c1,c2,...,cs}每个属性数据对应地进行一一比较,并加标记,若xi1≥c1,则 为+,反之为‑,同样比较,衡量目标数据相关属性O={o1,o2,...,os}相对*基准C={c1,c2,...,cs}的相对变化趋势,结果记为步骤4.3:将Ti与TO中的对应元素进行一一对比,判断Ti与TO中相关属性相对O={o1,o2,...,os}的变化趋势是否相同,若 与 同为+或同为‑,则将 改写为1,反之则将 改写为
0;
步骤4.4:按每组数据,对所有工艺数据的相关属性相对变化趋势的对比结果的标签Ti求和,得到STi,其计算如下所示:STi=ΣTi
STi的值为[0,s]中的一个整数,最大值为s,i为正整数;
步骤4.5:根据计算的STi,按整数数值大小划分STi等级,数值越大等级越高,相同数值STi划分为同一级,按级别降序,筛选取出前K1个等级的STi值其下标i所对应的case*中的工* * * *艺数据,K1为正整数,2≤K1≤s,记为S={S1,S2,...,Sp},p为所得的工艺数据样本数量。 说明书 : 基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法技术领域[0001] 本发明涉及领域,尤其涉及基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法。背景技术[0002] 挤压铸造工艺参数直接影响着铸件的力学性能和微观组织结构,合理的工艺参数是生产具有上述优势的挤压铸件的前提和关键。现有的挤压铸造工艺参数设计方法主要有完全基于实验研究获取工艺参参数、基于实验数据建模优化获取工艺参数和理论计算三种。完全基于实验研究获取工艺参数方法和基于实验数据建模优化获取工艺参数的方法都需要进行实验,依赖于实验数据,且每次只能针对单一材料和铸件进行实验,而材料成分组成和铸件几何形状多种多样,因此其适应性和柔性差(即使是数值模拟,更换铸件需要重新建模、设计模具,迭代,耗时长);且成本较高,获取工艺参数的时间较长。而对第三种方法,当前只有部分工艺参数设计公式,也多针对某一具有统一特性的一类铸件,局限性较大会,忽略了工艺参数之间的耦合作用,鲜有兼顾工艺参数间的相互作用,导致理论和实际存在较大误差。可见,现有工艺参数设计方法均有各自的缺点,难以满足挤压铸造工艺参数快速发展和评级应用的需求。[0003] 随着大数据时代的来临,数据成为一种生产资料,迫切需要加强对已有挤压铸造工艺数据的应用,及参考已有工艺参数数据构建数据驱动的工艺参数设计方法,以提高挤压铸造工艺参数的设计效率、降低成本。本专利正是顺应该背景,结合相似原理定义和KNN算法,基于挤压铸造的原理,提出了一种基于已有工艺数据的挤压铸造工艺参数设计方法。发明内容[0004] 本发明的目的在于提供基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法,解决背景技术中提到的技术问题。根据本发明的挤压铸造工艺参数设计方法,综合考虑了挤压铸造工艺参数的影响因素及其权重,实现了浇注温度的工艺参数设计。[0005] 为了实现上述目的,本发明采用的技术方案如下:[0006] 基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法,所述方法包括如下步骤:[0007] 步骤1:挤压铸造工艺数据表示,对于已有挤压铸造工艺参数数据集case,表示为case={Si|i=1,2,…,m},m为数据样本的个数,每个样本数据包含挤压铸造的工艺参数、材料成分数据和形状特征数据的属性变量,按照性质将样本属性划分为工艺参数的影响因素Xk,其中k=1,2,...,t,t表示工艺影响因素的个数,和工艺参数Yj,其中j=1,2,...,n),n表示工艺参数的个数,数据样本Si的对应属性数据分别为xik和yij,挤压铸造的工艺参数包括挤压压力、浇注温度和模具预热温度等。[0008] 步骤2:得到所设计的工艺参数的相关影响属性,对所设计的目标挤压铸件的特定工艺参数Yj,称为目标工艺参数,对应值为yoj,工艺参数的影响因素Xk并非都是工艺参数Yj的相关影响因素,利用SVM‑RFE算法从Xk中选取直接影响该工艺参数的相关属性,设为Xc={X1,X2,…,Xs};[0009] 步骤3:选出挤压铸造工艺参数数据集case中目标工艺参数Yj及其相关属性Xc所对* *应的数据,表示为case ,基于熵权法和数据集case 计算步骤1选取的相关属性Xc={X1,X2,…,Xs}的权重,区分Xc={X1,X2,…,Xs}对Yj的影响程度,得到相关属性的权重记为W={w1,w2,…,ws};[0010] 步骤4:进行相关属性Xc的相对变化趋势的衡量和工艺数据筛选,将对应的挤压铸造工艺参数数据视为N维变量集合,不同工艺参数数据的差异可视为N维变量运动、变化和发展的结果,根据步骤2选取的相关属性Xc={X1,X2,…,Xs},计算衡量已有工艺参数数据和待设计的目标工艺参数的相关属性的相对变化趋势,并筛选出与待设计的目标工艺参数的* * * *相关属性相对变化趋势程度最相近的工艺参数数据,设为S ={S1 ,S2 ,...,Sp},p为聚类所得的工艺参数数据数量;[0011] 步骤5:应用KNN算法,对步骤4得到的聚类结果S*={S1*,S2*,...,Sp*}加权聚类,然后对聚类结果进行加权求和,得到求和结果即为所所需的工艺参数Yj。[0012] 进一步地,步骤2中,基于SVM‑RFE算法相关属性的选取过程为,基于PyCharm平台,从sklearn.feature_selection和sklearn.svm模块分别导入RFE和SVE功能模块,SVM‑RFE算法的具体过程为,以工艺参数的影响因素Xk和工艺参数Yj作为模型的输入数据,其中k=1,2,...,t,使用特征变量训练模型,计算每个特征变量的重要性排序标准,剔除最不重要的K个特征,保留其余特征,并判断剩余特征数量达到简约要求,若达到,从Xk中选取工艺参数Yj的相关属性Xc={X1,X2,…,Xs},如果没有达到重复计算。[0013] 进一步地,步骤3中基于熵权法的相关属性的权重分配过程为:[0014] 步骤3.1,将case*按下公式组成一个新的矩阵O*:[0015][0016] 步骤3.2:采用极差化法将O*标准化得到新的矩阵π,然后对进行π归一化处理,极差化法和归一化方法如下式:[0017][0018]* *[0019] 其中, 为O 中的第i行第s列元素; 为O 中的第s列;同理,bis为π中的第i行第s列元素,πi's为πis归一化的后的值。[0020] 步骤3.3:则Xc中第s个相关属性的信息熵定义为:[0021][0022] 步骤3.4:工艺参数Yj有s个相关属性,则设定影响因素Xc对工艺参数Yj的影响权重为:[0023][0024] Ec为影响因素Xc的信息熵。[0025] 进一步地,步骤4中,相关属性的相对变化趋势的衡量和挤压铸造工艺数据筛选的处理过程如下:[0026] 步骤4.1:记设计的目标铸件的目标工艺参数的相关属性Xc的数据为O={o1,*o2,…,os},简称为目标数据,根据差异率,从case中选取一组与其相对接近的数据为对比*基准,选择的原则是令基准C与O中的对位属性的值相差越小越好;[0027] 步骤 4 .2:为 每个 添加 一行 与相关 变量X c维 度相同 的标 签用于记录相关属性上对应数据{xi1,xi2,…,xis}相*对基准的变化趋势,然后将case中除基准外的每一组挤压铸造工艺数据的相关属性数据*{xi1,xi2,…,xis}与基准C ={c1,c2,…,cs}每个属性数据对应地进行一一比较,并加标记,若xi1≥c1,则 为+,反之为‑,同样比较,衡量目标数据相关属性O={o1,o2,…,os}相对基准*C={c1,c2,…,cs}的相对变化趋势,结果记为[0028] 步骤4.3:将Ti与TO中的对应元素进行一一对比,判断Ti与TO中相关属性相对O={o1,o2,…,os}的变化趋势是否相同,若 与 同为+或同为‑,则将 改写为1,反之则将 改写为0;[0029] 步骤4.4:按每组数据,对所有工艺数据的相关属性相对变化趋势的对比结果的标签Ti求和,得到STi,其计算如下所示:[0030] STi=∑Ti[0031] STi的值为[0,s]中的一个整数,最大值为s。[0032] 步骤4.5:根据计算的STi,按整数数值大小划分STi等级,数值越大等级越高,相同数值STi划分为同一级,按级别降序,筛选取出前K1个等级的STi值其下标i所对应的case*中* * * *的工艺数据,K1为正整数,2≤K1≤s,记为S={S1,S2,...,Sp},p为所得的工艺数据样本数量。[0033] 进一步地,步骤5中,KNN算法的聚类和加权回归处理过程为:[0034] 步骤5.1:对数据进行预处理,利用数据归一化方法消除不同相关属性之间不同纲量的影响,即为步骤2选取的s个相关属性,具体过程为:[0035][0036] 其中,xis为Xc中的第i行第s列。[0037] 步骤5.2:计算样本间的距离,根据步骤3得到的相关属性权重,通过计算加权欧氏*距离衡量属性空间Xc内S 中的数据样本与目标铸件O的Xc各属性之间的距离dlO,(l=1,*′2,…,p),并根据距离的大小取K个与目标铸件O最近邻的工艺数据样本S ,最近邻即为距离最小,距离计算如下所示:[0038][0039] 其中,xlc为S*中第l个样本的第c个属性值,oc为目标数据O中第c个属性值。[0040] 步骤5.3:把S*′根据与目标样本之间的距离对S*′各个聚类样本赋权,得到聚类样k k k k本的权重W={w1 ,w2 ,…,ws},样本权重计算如下式所示:[0041][0042] 其中,di′O为S*′第i′个样本到目标数据O的距离, 是S*′第i′个样本的权重;[0043] 步骤5.4:根据步骤5.3所得样本权重,对所求的工艺参数进行加权求和,求和结果即为所设计的目标的工艺参数yoj的值,工艺参数计算如下式所示:[0044][0045] 工艺参数设计方法首先基于相似原理对工艺参数的相关变量的相对变化趋势进行衡量。在此基础上提取与目标案例的相关变量相对变化趋势相似的样本数据,基于这些样本数据,进行KNN聚类并对聚类样本中的对应参数进行加权回归作为目标案例的工艺参数设计值。该设计方法基于已有的研究数据,充分参考利用了现有的相关研究成果,无需进行繁琐的实验研究且工艺参数的设计精度较高。相比于现有的工艺参数设计方法,节省了大量的时间成本和实验成本。该方法具有普适性,不仅适用于挤压铸造工艺参数的设计,对于其它类似领域的参数设计同样适用。[0046] 本发明由于采用了上述技术方案,具有以下有益效果:[0047] 本发明直接利用过于已有的挤压铸造工艺参数数据来设计新铸件的工艺参数,无需进行实验,成本低,效率高,既跳出了繁琐的实验研究过程,又增强了对已有数据的利用,为挤压铸造工艺参数设计提供了一种数据驱动设计的新方法;不与特定单一铸件绑定,可同时能适应不同铸件,具有普适性,可推动挤压铸造应用和发展。不仅适用于挤压铸造工艺参数的设计,对其它类似领域的工艺参数设计具有借鉴作用。附图说明[0048] 图1是本发明的总体流程图。[0049] 图2是本发明的SVM‑RFE算法流程图。[0050] 图3是本发明的特征变量相对变化趋势示意图。[0051] 图4是本发明的改进KNN算法流程图。具体实施方式[0052] 为使本发明的目的、技术方案及优点更加清楚明白,以下参照附图并举出优选实施例,对本发明进一步详细说明。然而,需要说明的是,说明书中列出的许多细节仅仅是为了使读者对本发明的一个或多个方面有一个透彻的理解,即便没有这些特定的细节也可以实现本发明的这些方面。[0053] 如图1‑4所示,基于相似原理的改进KNN算法的挤压铸造工艺参数设计方法,所述的方法包括如下步骤:[0054] 步骤1:挤压铸造工艺数据的表示:对于已有挤压铸造工艺参数数据集case,表示为case={Sii=1,2,…,m},m为数据样本的个数,每个样本数据主要包含挤压铸造的工艺参数(挤压压力、浇注温度、模具预热温度等)、材料成分数据(如铝)和形状特征数据(如形状复杂度)等属性变量,按照性质将样本属性划分为工艺参数的影响因素Xk(k=1,2,...,t),t表示工艺影响因素的个数,和工艺参数Yj(j=1,2,...,n),n表示工艺参数的个数,数据样本Si的对应属性数据分别为xik和yij。[0055] 表4挤压铸造工艺数据样本[0056][0057] 步骤2:得到所设计的工艺参数的相关影响属性。对所设计的目标挤压铸件的特定的工艺参数Yj(称为目标工艺参数),对应值为yoj,工艺参数的影响因素Xk并非都是工艺参数Yj的相关影响因素,为此利用SVM‑RFE算法从Xk中选取直接影响该工艺参数的相关属性(如材料成分),设为Xc={X1,X2,…,Xs};[0058] 本实例以挤压铸造工艺的浇注温度设计为参数设计实例。浇注温度的选择主要受挤压铸件材料金属液相线和铸件结构的影响,而金属液相线又主要受材料成分的影响。利用SVM‑RFE算法提取工艺数据中浇注温度的相关属性。SVM‑RFE算法的模型参数选择:SVM的核函数选择linear函数,惩罚函数C=1,选择特征数为6个。[0059] 算法基本流程如图2所示,相关属性提取结果如表5所示;[0060] 表5基于SVM‑RFE算法提取的浇注温度相关属性[0061][0062] 步骤3:选出挤压铸造工艺参数数据集case中目标工艺参数Yj及其相关属性Xc所对* *应的数据,表示为case ,如表2所示,基于熵权法和数据集case计算步骤1选取的相关属性Xc={X1,X2,…,Xs}的权重,区分Xc对Yj的影响程度,得到各个相关属性的权重记为W={w1,w2,…,ws};表5中浇注温相关属性的权重分配结果如表6所示;[0063] 表6浇注温度相关属性权重分配结果[0064][0065] 具体步骤:[0066] 步骤3.1:将case*按下公式组成一个新的矩阵O*:[0067][0068] 步骤3.2:采用极差化法将O*标准化,然后对进行O*归一化处理,极差化法和归一化方法如下式:[0069][0070]* *[0071] 其中, 为O中的第i行第s列元素; 为O 中的第s列;同理,bis为π中的第i行第s列元素,πi's为πis归一化的后的值。[0072] 步骤3.3:则Xc中第s个相关属性的信息熵定义为:[0073][0074] 步骤3.4:工艺参数Yj有s个相关属性,则设定相关属性Xc对工艺参数Yj的影响权重为:[0075][0076] 步骤4:相关属性Xc的相对变化趋势的衡量和工艺数据筛选:根据步骤2选取的相关属性Xc={X1,X2,…,Xs},借鉴相似原理的思想,将对应的挤压铸造工艺参数数据视为N维变量集合,不同工艺参数数据的差异可视为N维变量运动、变化和发展的结果,对已有工艺参数数据和待求取的目标案例的工艺参数的相关属性进行相对变化趋势衡量,并筛选出于* * * *目标案例相对变化趋势程度较高的工艺参数数据,设为S ={S1 ,S2,...,Sp},p为本步骤聚类所得的工艺参数数据数量,相关属性的相对变化趋势衡量示意图如图3所示;[0077] 步骤4中,相关属性的相对变化趋势的衡量和挤压铸造工艺数据筛选的处理过程:[0078] 记设计的目标铸件的目标工艺参数的相关属性Xc的数据为O={o1,o2,…,os}(以*下简称目标数据),根据差异率,从case中选取一组与其相对接近的数据为对比基准,选择*的原则是令基准C与O中的主要的对位属性的值不宜相差太大。[0079] 为每个 添加一行与相关变量Xc维度相同的标签用于记录相关属性上对应数据{xi1,xi2,…,xis}相*对基准的变化趋势。然后将case中除基准外的每一组挤压铸造工艺数据的相关属性数据*{xi1,xi2,…,xis}与基准C ={c1,c2,…,cs}每个属性数据对应地进行一一比较,并加标记,如若xi1≥c1,则 为“+”,反之为“‑”,结果如表3所示。同样比较,衡量目标数据相关属性O=*{o1,o2,…,os}相对基准C ={c1,c2,…,cs}的相对变化趋势,结果记为[0080] 表2挤压铸造工艺数据case*的表示[0081][0082] 将Ti与TO中的对应元素进行一一对比,判断Ti与TO中相关属性相对O={o1,o2,…,os}的变化趋势是否相同。若 与 同为“+”或同为“‑”,则将 改写为1,反之则将 改写为0。[0083] 按每组数据,对表3中所有工艺数据的相关属性相对变化趋势的对比结果的标签Ti求和,得到STi,其计算如下所示:[0084] STi=∑Ti[0085] STi的值为[0,s]中的一个整数,最大值为s。[0086] 根据计算的STi,按整数数值大小划分STi等级,数值越大等级越高,相同数值STi划分为同一级。按级别降序,筛选取出前K1个等级的STi值其下标i所对应的case*中的工艺数*据(这些数据和目标工艺数据相对于基准工艺数据的变化趋势相同或者基本相同),记为S* * *={S1,S2,...,Sp},p为所得的工艺数据样本数量。[0087] 表3挤压铸造工艺数据case*添加标签Ti后的表示[0088][0089] 步骤5:应用KNN算法,对步骤4得到的聚类结果S*={S1*,S2*,...,Sp*}加权聚类,然后对聚类结果进行加权求和,得到求和结果即为所所需的工艺参数Yj。[0090] 步骤5中,KNN算法的聚类和加权回归处理过程为:[0091] 步骤5.1:对数据进行预处理,利用数据归一化方法消除不同相关属性之间不同纲量的影响:(步骤2选取的s个相关属性)[0092][0093] 其中,xis为Xc中的第i行第s列。[0094] 步骤5.2:计算样本间的距离。根据步骤3得到的相关属性权重,通过计算加权欧氏*距离衡量属性空间Xc内S 中的数据样本与目标铸件O的Xc各属性之间的距离dlO,(l=1,*′2,…,p),并根据距离的大小取K个与目标铸件O最近邻(即距离最小)的工艺数据样本S 。距离计算如下所示:[0095][0096] 其中,xlc为S*中第l个样本的第c个属性值,oc为目标数据O中第c个属性值。[0097] 步骤5.3:对S*′,根据与目标样本之间的距离对S*′各个聚类样本赋权,得到聚类样k k k k本的权重W={w1 ,w2 ,…,ws}。样本权重计算如下式所示:[0098][0099] 是S*′第i′个样本的权重。[0100] 步骤5.4:根据步骤4.3所得样本权重,对所求的工艺参数进行加权求和,求和结果即为所设计的目标的工艺参数Yj的值。工艺参数计算如下式所示:[0101][0102] 根据步骤4和步骤5的处理步骤,利用步骤2和步骤3所得表5和表6数据随机选取80%的样本作为训练集,20%作为测试集,进行五次重复实验,并取平均值作为实验结果。实验结果评价指标采用相对平均误差、均方误差作为算法性能评价指标。如下式所示:[0103][0104][0105] n为测试样本的数量, 为第i个测试样本的预测值,Yi为第i个测试样本的真值。[0106] 通过实验验证,该方法设计的浇注温度平均误差仅为1.96%,均方误差为314.7,浇注温度最大误差控制在30℃以内。误差很小,满足挤压铸造工艺的使用要求。[0107] 以上所述仅是本发明的优选实施方式,应当指出,对于本技术领域的普通技术人员来说,在不脱离本发明原理的前提下,还可以作出若干改进和润饰,这些改进和润饰也应视为本发明的保护范围。
专利地区:广西
专利申请日期:2021-11-18
专利公开日期:2024-11-22
专利公告号:CN114186357B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。




