 产学研创新服务平台(全国)


一种融合多源可靠信息的移动应用推荐方法及装置
更新时间:2026-10-01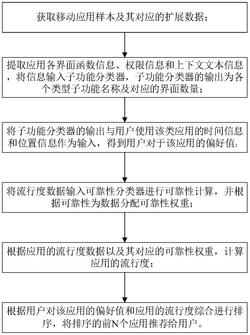 专利申请类型:发明专利;
地区:山东-济宁;
源自:济宁高价值专利检索信息库;
专利名称:一种融合多源可靠信息的移动应用推荐方法及装置
专利类型:发明专利
专利申请号:CN202210574977.9
专利申请(专利权)人:易运盈(山东)网络科技有限公司
权利人地址:山东省济宁市兖州区龙桥街道永华新百汇A座11楼1121室
专利发明(设计)人:胡阳雨,祝清意,张亮,余桀,毛美玲
专利摘要:本发明涉及推荐领域,具体涉及一种融合多源可靠信息的移动应用推荐方法及装置,方法包括获取移动应用样本及其对应的扩展数据;提取应用样本各界面的函数信息、权限信息和上下文文本信息,输入子功能分类器得到子功能分类,结合用户使用该类应用的时间信息和位置信息得到用户对该应用的偏好值;获取应用的流行度信息,通过可靠性分类器获取各个流行度数据的可靠性,计算应用的流行度;综合用户对应用的偏好值和应用的流行度向用户推荐应用;本发明通过提取应用包含的各类子功能,解决情境信息不全面且粗粒度的问题,提升应用推荐的准度和精度;通过提取跨市场级别的特征,更全面发现应用的虚假流行度数据,降低虚假数据对于推荐模型的影响。
主权利要求:
1.一种融合多源可靠信息的移动应用推荐方法,其特征在于,具体包括以下步骤:获取移动应用样本及其对应的扩展数据;
提取应用各界面函数信息、权限信息和上下文文本信息,将信息输入子功能分类器,子功能分类器的输出为各个类型子功能名称及对应的界面数量;子功能分类器的获取过程包括:对于不同类别的移动应用,分别选择m个应用,人工试用每个应用并遍历应用的所有界面,为每个界面的功能打上标签;
获取每个界面下使用的函数名以及申请的权限名,并根据系统组件使用的回调函数,定位每个界面的入口点,即入口组件的ID;
动态运行应用,遍历应用的所有界面,并获取各个界面的Activity名称以及包含的文本信息作为上下文信息,并将入口组件的文本加入上下文信息;
将上下文文本进行预处理,并进行分词和去停用词后按照从上到下的顺序进行排序,生成文本向量;
将每个子功能对应的界面的文本向量作为训练集的正集,其他界面的文本信息作为训练集的负集,对子功能分类器进行训练,得到完成训练的子功能分类器;
将子功能分类器的输出与用户使用该类应用的时间信息和位置信息作为输入,得到用户对于该应用的偏好值;用户对于应用a的偏好值表示为:Prefera=λ1PRtime+λ2PRposition+λ3SIMfunc,λ1+λ2+λ3=1其中,Prefera代表用户对于应用a的偏好值,PRtime为当前时间段用户使用该类应用的概率,PRposition为当前地点用户使用该类应用的概率;λ1、λ2、λ3分别为PRtime、PRposition、SIMfunc的影响因子;应用与用户使用的同类型应用的功能相似度SIMfunc表示为:其中,n为用户使用的同类型应用的数量, 代表该应用a与用户使用的某个同类型应用bi的相同功能比率, 为应用a与应用bi相同子功能对应的界面的总数量,SUM_UIa为应用a的界面的总数量;
将流行度数据输入可靠性分类器进行可靠性计算,并根据可靠性为数据分配可靠性权重;可靠性分类器的训练过程包括:爬取恶意应用在不同应用商店的流行度数据作为训练集的正集,爬取良性应用的流行度数据作为训练集的负集;
对训练集中每个应用的评论数据进行抽取,从评论数据中获取评论用户ID、评论内容、评分和评论时间信息;
获取每个应用在每个应用商店的流行度数据并进行特征提取,提取包括评分变化向量、排名变化向量、好评数量变化向量、相同评论内容比率、相似评论内容比率共5个维度的特征;
结合应用在不同应用商店的流行度数据,进行跨商店特征提取,提取包括不同商店内应用评分变化速率偏差值、不同商店内应用排名变化速率偏差值、不同商店内应用评论数量变化速率偏差值、相同评论内容比率、相似评论内容比率供5个维度的特征;
将获取的10个维度的特征作为可靠性分类器的输入,并根据可靠性分类器分类结果的准确率和召回率选择合适的分类算法,得到完成训练的可靠性分类器;
可靠性分类器对数据进行可靠性分类时,分别得出数据为可靠数据和不可靠数据的概率,用户设定可靠阈值和不可靠阈值,当可靠概率大于设置可靠阈值且不可靠概率小于设置的不可靠阈值的数据设为可靠数据,将可靠概率小于设置的可靠阈值且不可靠概率大于设置的不可靠阈值的数据设置为不可靠数据;否则,将数据设置为可疑数据,在为每种数据分配权重时,令可靠数据的权重>可疑数据的权重>不可靠数据的权重;
根据应用的流行度数据以及其对应的可靠性权重,计算应用的流行度,包括:POPA=kλkRank(∑βmDatam),λ1+λ2+…+λk=1其中,POPA表示应用A的流行度;βm表示为第m个流行度数据Datam分配的可靠性权重,Rank函数计算得到该类型流行度数据在相同偏好值应用中的排名,λk为各类型流行度数据对于流行度值的影响因子;
根据用户对该应用的偏好值和应用的流行度综合进行排序,将排序的前N个应用推荐给用户。
2.一种融合多源可靠信息的移动应用推荐装置,其特征在于,用于实现权利要求1所述的一种融合多源可靠信息的移动应用推荐方法,包括输入模块、应用功能程序提取模块、数据可靠性度量模块以及应用推荐模块,输入模块包括移动程序单元以及扩展数据单元,应用功能程序提取模块包括应用解析模块、上下文信息提取模块以及功能分类模块,数据可靠性度量模块包括多元数据搜集模块、可靠性分析模块以及流行度计算模块,其中:移动程序单元,用于存储应用样本;
扩展数据单元,用于获取应用样本的应用描述信息、应用类别以及该应用的流行度信息,流行度信息包括用户评论信息、评分信息、排名信息;
应用解析模块,用于对应用样本各个界面使用的函数信息以及函数对应的应用权限信息;
上下文信息提取模块,用于获取应用样本的上下文信息;
功能分类模块,用于获取应用样本的子功能;功能分类模块为一个子功能分类器,子功能分类器的获取过程包括:对于不同类别的移动应用,分别选择m个应用,分别人工试用每个应用并遍历用用的所有界面,为每个界面的功能打上标签;
获取每个界面下使用的函数名以及申请的权限名,并根据系统组件使用的回调函数,定位每个节点的入口点,即入口组件的ID;
动态运行应用,遍历应用的所有界面,并获取各个界面的Activity名称以及包含的文本信息作为上下文信息,并将系统组件的文本加入上下文信息;
将上下文文本进行预处理,并进行分词和去停用词后按照从上到下的顺序进行排序,生成文本向量;
将每个子功能对应的界面的文本向量作为训练集的正集,其他界面的文本信息作为训练集的负集,对子功能分类器进行训练,得到完成训练的子功能分类器;
多元数据搜集模块,用于爬取在不同移动应用商店中各个时间段不同应用类型的流行度数据;
可靠性分析模块,用于根据多元数据搜集模块爬取的流行度数据对相关数据的可靠性进行度量;可靠性分类器的训练过程包括:爬取恶意应用在不同应用商店的流行度数据作为训练集的正集,爬取良性应用的流行度数据作为训练集的负集;
对训练集中每个应用的评论数据进行抽取,从评论数据中获取评论用户ID、评论内容、评分和评论时间信息;
获取每个应用在每个应用商店的流行度数据并进行特征提取,提取包括评分变化向量、排名变化向量、好评数量变化向量、相同评论内容比率、相似评论内容比率共5个维度的特征;
结合应用在不同应用商店的流行度数据,进行跨商店特征提取,提取包括不同商店内应用评分变化速率偏差值、不同商店内应用排名变化速率偏差值、不同商店内应用评论数量变化速率偏差值、相同评论内容比率、相似评论内容比率供5个维度的特征;
将获取的10个维度的特征作为可靠性分类器的输入,并根据可靠性分类器分类结果的准确率和召回率作为衡量可靠性分类器的标准进行训练,得到完成训练的可靠性分类器流行度计算模块,用于根据流行度数据以及可靠性计算每个应用的流行度;
应用推荐模块,用于根据应用的流行度和用户对每个类型应用的偏好获取综合排序,并推荐排序最靠前的N个应用给用户。 说明书 : 一种融合多源可靠信息的移动应用推荐方法及装置技术领域[0001] 本发明涉及推荐领域,具体涉及一种融合多源可靠信息的移动应用推荐方法及装置。背景技术[0002] 目前,国内外相关学者在移动应用推荐领域做了大量的研究,提出了一些有效的推荐模型。模型从推荐方法角度上主要分为:基于协同过滤的推荐模型、基于交互信息的推荐模型和基于扩展信息的推荐模型。[0003] 协同过滤是推荐系统中较为传统的一种方法,在商品推荐、视频推荐等领域均有广泛的应用。因此,部分学者直接将该思想移植到移动应用推荐系统中。协同过滤主要基于具有相似物品经验的用户通常具有相似的偏好这一假设,通过计算用户与物品之间的相似度,来进行物品推荐。在移动应用推荐中,已有的研究对偏好相同的用户的识别主要包括:计算用户使用的移动应用间的语义关系相似度、挖掘用户使用应用日志的相似度、分析用户评论内容的相似度、分析用户功能需求或安全需求的相似度等。[0004] 基于交互信息的推荐模型通常利用的是移动用户与应用在交互过程中产生的丰富的信息,包括用户使用应用的时间信息、位置信息等,相关交互信息也可以理解为用户的情境日志,通过矩阵分解模型、语义模型或深度学习模型建立用户偏好与情境之间的关联,得到用户的行为习惯,从而实现移动应用的推荐。[0005] 扩展信息主要包括用户评论信息、应用版本信息、应用权限信息、应用描述信息、图片信息等,通常会加入到模型训练过程中,帮助丰富、过滤和填充用户与应用的交互模型,得到用户在特定的情境下对移动应用的偏好概率,从而更好的解释基于交互信息的推荐方法。[0006] 基于协同过滤的推荐方法在构建相似度模型的过程中,移动用户或应用的向量往往是非常稀疏的,因此模型构建非常困难,且推荐的准度和精度较低。另外两种方法虽然考虑了用户和应用的交互信息,以及其他扩展信息,但是忽略了相关信息的可靠性、完整性对模型的影响。例如,相关模型通常会引入应用描述、应用版本等扩展信息来帮助丰富用户的情境日志,然而,一个移动应用通常包括多个子功能,开发者提供的应用描述中的应用功能往往是不全面的,导致情境信息的不准确。另外,相关模型通常会结合应用流行度信息对推荐结果进行排序,而移动应用中常见的排名欺诈行为产生的虚假评论信息、评分信息等,会对推荐结果的准度产生较大影响。发明内容[0007] 为了提升输入数据的可靠性和完整性,以帮助更加精准和可靠地进行移动应用推荐,本发明提出一种融合多源可靠信息的移动应用推荐方法及装置,所述方法包括以下步骤:[0008] 获取移动应用样本及其对应的扩展数据;[0009] 提取应用各界面函数信息、权限信息和上下文文本信息,将信息输入子功能分类器,子功能分类器的输出为各个类型子功能名称及对应的界面数量;[0010] 将子功能分类器的输出与用户使用该类应用的时间信息和位置信息作为输入,得到用户对于该应用的偏好值;[0011] 将流行度数据输入可靠性分类器进行可靠性计算,并根据可靠性为数据分配可靠性权重;[0012] 根据应用的流行度数据以及其对应的可靠性权重,计算应用的流行度;[0013] 根据用户对该应用的偏好值和应用的流行度综合进行排序,将排序的前N个应用推荐给用户。[0014] 进一步的,子功能分类器的获取过程包括:[0015] 对于不同类别的移动应用,分别选择m个应用,人工试用每个应用并遍历应用的所有界面,为每个界面的功能打上标签;[0016] 获取每个界面下使用的函数名以及申请的权限名,并根据系统组件使用的回调函数,定位每个界面的入口点,即入口组件的ID;[0017] 动态运行应用,遍历应用的所有界面,并获取各个界面的Activity名称以及包含的文本信息作为上下文信息,并将入口组件的文本加入上下文信息;[0018] 将上下文文本进行预处理,并进行分词和去停用词后按照从上到下的顺序进行排序,生成文本向量;[0019] 将每个子功能对应的界面的文本向量作为训练集的正集,其他界面的文本信息作为训练集的负集,对子功能分类器进行训练,得到完成训练的子功能分类器。[0020] 进一步的,用户对于应用a的偏好值表示为:[0021] Prefera=λ1PRtime+λ2PRposition+λ3SIMfunc,λ1+λ2+λ3=1[0022] 其中,Prefera代表用户对于应用a的偏好值,PRtime为当前时间段用户使用该类应用的概率,PRposition为当前地点用户使用该类应用的概率,SIMfunc为应用与用户使用的同类型应用的功能相似度;λ1、λ2、λ3分别为PRtime、PRposition、SIMfunc的影响因子。[0023] 进一步的,应用与用户使用的同类型应用的功能相似度SIMfunc表示为:[0024][0025] 其中,n为用户使用的同类型应用的数量, 代表该应用a与用户使用的某个同类型应用bi的相同功能比率, 为应用a与应用bi相同子功能对应的界面的总数量,SUM_UIa为应用a的界面的总数量。[0026] 进一步的,可靠性分类器的训练过程包括:[0027] 爬取恶意应用在不同应用商店的流行度数据作为训练集的正集,爬取良性应用的流行度数据作为训练集的负集;[0028] 对训练集中每个应用的评论数据进行抽取,从评论数据中获取评论用户ID、评论内容、评分和评论时间信息;[0029] 获取每个应用在每个应用商店的流行度数据并进行特征提取,提取包括评分变化向量、排名变化向量、好评数量变化向量、相同评论内容比率、相似评论内容比率共5个维度的特征;[0030] 结合应用在不同应用商店的流行度数据,进行跨商店特征提取,提取包括不同商店内应用评分变化速率偏差值、不同商店内应用排名变化速率偏差值、不同商店内应用评论数量变化速率偏差值、相同评论内容比率、相似评论内容比率供5个维度的特征;[0031] 将获取的10个维度的特征作为可靠性分类器的输入,并根据可靠性分类器分类结果的准确率和召回率选择合适的分类算法,得到完成训练的可靠性分类器。[0032] 进一步的,可靠性分类器对数据进行可靠性分类时,分别得出数据为可靠数据和不可靠数据的概率,用户设定可靠阈值和不可靠阈值,当可靠概率大于设置可靠阈值且不可靠概率小于设置的不可靠阈值的数据设为可靠数据,将可靠概率小于设置的可靠阈值且不可靠概率大于设置的不可靠阈值的数据设置为不可靠数据;否则,将数据设置为可疑数据,在为每种数据分配权重时,令可靠数据的权重>可疑数据的权重>不可靠数据的权重;作为一种优选的实施方式可以将可靠、可疑以及不可靠三个级别分别分配的权重为1、0.5以及0,作为一种更为优选的方式,可以将判定为可靠数据的不可靠概率的平均值作为波动值,通过随机函数在该波动值之间得到一个数值,令可疑数据的权重为 的取值为 可以为判定为可靠数据的不可靠概率的平均值,或者判定为可靠数据的不可靠概率的中位数;作为一种更为优选的方式,可以将不可靠数据的权重设置为负数。[0033] 进一步的,根据当前应用样本对应流行度数据以及其对应的权重计算当前样本的流行度,表示为:[0034][0035] 其中,POPA表示应用A的流行度;βm表示为第m个流行度数据Datam(例如,某条评论)分配的可靠性权重,Rank函数计算得到该类型流行度数据在相同偏好值应用中的排名,λk为各类型流行度数据对于流行度值的影响因子,例如下载量、评分、评论等类型。[0036] 本发明还提出一种融合多源可靠信息的移动应用推荐装置,包括输入模块、应用功能程序提取模块、数据可靠性度量模块以及应用推荐模块,输入模块包括移动程序单元以及扩展数据单元,应用功能程序提取模块包括应用解析模块、上下文信息提取模块以及功能分类模块,数据可靠性度量模块包括多元数据搜集模块、可靠性分析模块以及流行度计算模块,其中:[0037] 移动程序单元,用于存储应用样本;[0038] 扩展数据单元,用于获取应用样本的应用描述信息、应用类别以及该应用的流行度信息,流行度信息包括用户评论信息、评分信息、排名信息;[0039] 应用解析模块,用于对应用样本各个界面使用的函数信息以及函数对应的应用权限信息;[0040] 上下文信息提取模块,用于获取应用样本的上下文信息;[0041] 功能分类模块,用于获取应用样本的子功能;[0042] 多元数据搜集模块,用于爬取在不同移动应用商店中各个时间段不同应用类型的流行度数据;[0043] 可靠性分析模块,用于根据多元数据搜集模块爬取的流行度数据对相关数据的可靠性进行度量;[0044] 流行度计算模块,用于根据流行度数据以及可靠性计算每个应用的流行度;[0045] 应用推荐模块,用于根据应用的流行度和用户对每个类型应用的偏好获取综合排序,并推荐排序最靠前的N个应用给用户。[0046] 本发明结合自然语言处理技术及程序分析技术,一方面通过分析应用上下文信息及函数信息,自动推断应用内各界面对应的子功能,完善描述不充分的情境信息;另一方面,该方法引入流行度信息的可靠性度量,降低虚假信息对于推荐结果排序的影响;综上所述,本发明提升相关推荐模型输入数据的可靠性和完整性,以帮助更加精准和可靠地进行移动应用推荐。附图说明[0047] 图1为本发明一种融合多源可靠信息的移动应用推荐方法流程示意图;[0048] 图2为本发明一种融合多源可靠信息的移动应用推荐装置结构示意图;[0049] 图3为本发明一种融合多源可靠信息的移动应用推荐方法中计算偏好值的示意图;[0050] 图4为本发明一种融合多源可靠信息的移动应用推荐方法中计算偏好值的示意图;[0051] 图5为本发明一种融合多源可靠信息的移动应用推荐方法中可靠性分类器的训练过程示意图。具体实施方式[0052] 下面将结合本发明实施例中的附图,对本发明实施例中的技术方案进行清楚、完整地描述,显然,所描述的实施例仅仅是本发明一部分实施例,而不是全部的实施例。基于本发明中的实施例,本领域普通技术人员在没有做出创造性劳动前提下所获得的所有其他实施例,都属于本发明保护的范围。[0053] 本发明提出一种融合多源可靠信息的移动应用推荐方法,具体包括以下步骤:[0054] 获取移动应用样本及其对应的扩展数据;[0055] 将应用样本对应的扩展数据作为输入子功能分类器,子功能分类器的输出为当前样本各个截面对应子功能名称及改名称对应的界面数量;[0056] 将子功能分类器的输出与用户使用对应应用的时间信息和位置信息作为输入,得到用户对于该应用的偏好值;[0057] 将应用样本的应用名和包名信息输入爬虫,通过爬虫获取其在第三方应用商店及ASO检测平台的流行度数据;[0058] 将流行度数据输入可靠性分类器进行可靠性预测,预测结果包括可靠、可疑以及不可靠三个级别,三个级别分别分配的权重为1、0.5以及0;[0059] 根据当前应用样本对应流行度数据以及其对应的权重计算当前样本的流行度;[0060] 根据用户的偏好值和应用的流行度综合进行排序,将排序的前N个应用推荐给用户。[0061] 本发明采用的模型,或者本发明一种融合多源可靠信息的移动应用推荐装置结构如图1,根据核心功能可划分为4个模块:输入模块、应用功能提取模块、数据可靠性度量模块和应用推荐模块。各模块主要功能包括:[0062] 1)输入模块包括多个移动应用样本及对应的扩展数据。扩展数据包括应用描述信息、应用类别等应用元数据,以及用户评论信息、评分信息、排名信息等应用流行度数据。[0063] 2)应用功能提取模块首先利用应用解析模块和上下文信息提取模块,获取应用各界面使用的函数信息、权限信息,以及上下文信息。然后,基于训练好的分类器,将相关数据输入得到应用包含的所有子功能。子功能的划分包含两级,第一级为应用类别,第二级为子功能名称。例如,子功能“游戏‑支付”表示游戏类应用“愤怒的小鸟”中包含应用内支付功能。[0064] 3)数据可靠性度量模块主要面向应用流行度数据,包括应用评分、应用排名、应用评论。首先,基于应用名和应用包名信息,利用多源数据搜集模块从国内主流的移动应用商店(例如豌豆荚、华为应用商店、应用宝等)及ASO监测平台(例如酷传、蝉大师等)中,获取应用在不同应用商店中一定时间内(例如,3个月)的各类型流行度数据。然后,利用可靠性分析模块对相关数据的可靠性进行度量,将数据分为可靠、可疑及不可靠三个等级。最后,将数据输入流行度计算模块得到应用的流行度值。[0065] 4)应用推荐模块利用已有的基于扩展信息的推荐模型,将上述处理后的扩展数据进行输入,得到用户对于应用的偏好值。[0066] 采用本发明一种融合多源可靠信息的移动应用推荐方法进行推荐时的流程如图2所示,具体包括以下步骤:[0067] S1.输入:将应用的样本文件、相应的扩展数据进行输入。[0068] S2.应用解析:利用应用逆向工具静态分析应用样本,从中提取应用各个界面使用的函数信息,以及函数对应的应用权限信息。[0069] S3.上下文信息提取:自动化运行应用,遍历应用界面,并获取各个应用界面的XML格式布局信息,从中提取“Text”属性值,作为当前界面的上下文信息。另外,对于使用图片型组件的界面,在遍历过程中进行截图,使用OCR技术进行文本识别,提取文字作为当前界面的上下文信息。[0070] S4.子功能分类:将S2和S3的数据输入训练好的子功能分类器,得到当前应用各个界面对应的子功能,并按照两级划分的方式进行输出。输出结果包括两列,第一列为子功能名称,第二列为子功能对应的界面数量。例如,“游戏‑支付,2″表示当前游戏类应用,包含两个不同的应用内支付功能界面。[0071] S5.多源数据采集:将应用的应用名和包名信息输入爬虫模块,从国内主流的第三方移动应用商店及ASO监测平台中,爬取该应用的流行度数据变化情况,可以根据实际需求设置采集周期范围,例如采集近3个月内该应用的流行度数据。[0072] S6.可靠性分析:将采集的多源数据输入训练好的可靠性分类器,输出各条数据的可靠性预测结果,分为可靠、可疑和不可靠三个级别,并对应的分配权重1、0.5及0。[0073] S7.流行度计算:基于S6的输出数据,对应用的流行度值POP进行计算,计算公式为:[0074][0075] 其中,βm代表流行度数据Datam分配的可靠性权重,λk为各类型流行度数据对于流行度值的影响参数,可以平均分配,也可以由应用商店或用户手动配置。[0076] S8.偏好值计算:利用已有的基于扩展信息的推荐模型,将S4的输出数据作为情境日志的一部分进行输入,结合其他的模型输入数据(例如用户使用应用的时间、位置数据),得到用户对于该应用的偏好值。然后,基于S7计算得到的流行度值,对相关应用按照偏好值及流行度值进行综合排序,为用户进行应用推荐。[0077] 对分类器的训练过程如图3所示,具体包括以下步骤:[0078] S41.训练集构建:通过人工标记的方式,构建训练集。对于不同类别的移动应用,分别选择m个应用(例如,50个)作为训练集。人工试用所有应用并遍历应用的所有界面,为每个界面的功能打上标签。例如,应用A的界面1(Activity名称:LoginActivity)为登录功能。[0079] S42.函数、权限信息提取:对训练集中的应用进行逆向,提取每个界面(Activity)下使用的函数名以及申请的权限名。同时,根据系统组件使用的回调函数,定位每个界面的入口点,即系统组件的ID。[0080] S43.上下文信息提取:利用UIAutomator等自动化测试工具,动态运行应用,遍历应用的所有界面,并获取各个界面的Activity名称,以及包含的上下文文本信息。同时,根据S42获取的界面的入口点,将入口组件的文本也加入上下文信息中。[0081] S44.文本预处理:对获取的上下文信息进行预处理,利用jieba等第三方库进行分词及去停用词。将上下文信息按照从上之下的顺序进行排序,生成文本向量。[0082] S45.功能分类器:对各类型应用中的各个子功能,将其对应的界面信息(即S42和S44的输出信息)作为正集,其他的界面信息作为负集,使用机器学习算法(例如SVM二分类算法)训练分类器。[0083] 在本实施例中,用户对于应用a的偏好值表示为:[0084] Prefera=λ1PRtime+λ2PRposition+λ3SIMfunc,λ1+λ2+λ3=1[0085] 其中,Prefera代表用户对于应用a的偏好值,PRtime为当前时间段用户使用该类应用的概率,PRposition为当前地点用户使用该类应用的概率,SIMfumc为应用与用户使用的同类型应用的功能相似度;λ1、λ2、λ3分别为PRtime、PRposition、SIMfumc的影响因子,在设置影响因子时,可以将某一个影响因子的值设置为1,表示只计算当前影响因子的。[0086] 应用与用户使用的同类型应用的功能相似度SIMfumc表示为:[0087][0088] 其中,n为用户使用的同类型应用的数量, 代表该应用a与用户使用的某个同类型应用bi的相同功能比率, 为应用a与应用bi相同子功能对应的界面的总数量,SUM_UIa为应用a的界面的总数量。[0089] 本发明中步骤S6对可靠性分类器的训练过程如图4所示,具体包括以下步骤:[0090] S61.训练集构建:考虑到国内外暂没有一个公开的排名欺诈应用数据集用于训练,本方法基于恶意应用的大部分流行度数据(例如好评、高分)都是虚假的、被操纵的数据这一假设,从AndrooZoo等公开的恶意应用知识库中,爬取相关恶意应用在不同应用商店的流行度数据,作为训练集的正集,爬取良性应用的流行度数据作为训练集的负集。[0091] S62.数据抽取:对评论数据进行抽取,从中获取评论用户ID、评论内容、评分和评论时间信息。[0092] S63.商店内特征提取:分别对应用在每个应用商店的流行度数据进行特征提取,提取包括评分变化向量、排名变化向量、好评数量变化向量、相同评论内容比率、相似评论内容比率共5个维度的特征。[0093] S64.跨商店特征提取:结合应用在不同应用商店的流行度数据,进行跨商店特征提取,提取包括不同商店内应用评分变化速率偏差值、不同商店内应用排名变化速率偏差值、不同商店内应用评论数量变化速率偏差值、相同评论内容比率、相似评论内容比率供5个维度的特征。[0094] S65.分类器训练:将S63和S64提取的10个维度的特征进行输入,使用机器学习算法(例如SVM分类算法、随机森林算法等)进行分类器训练,根据分类结果的准确率和召回率选择更适合当前数据的分类模型。[0095] 本发明还提出一种融合多源可靠信息的移动应用推荐装置,包括输入模块、应用功能程序提取模块、数据可靠性度量模块以及应用推荐模块,输入模块包括移动程序单元以及扩展数据单元,应用功能程序提取模块包括应用解析模块、上下文信息提取模块以及功能分类模块,数据可靠性度量模块包括多元数据搜集模块、可靠性分析模块以及流行度计算模块,其中:[0096] 移动程序单元,用于存储应用样本;[0097] 扩展数据单元,用于获取应用样本的应用描述信息、应用类别以及该应用的流行度信息,流行度信息包括用户评论信息、评分信息、排名信息;[0098] 应用解析模块,用于对应用样本各个界面使用的函数信息以及函数对应的应用权限信息;[0099] 上下文信息提取模块,用于获取应用样本的上下文信息;[0100] 功能分类模块,用于获取应用样本的子功能;[0101] 多元数据搜集模块,用于爬取在不同移动应用商店中各个时间段不同应用类型的流行度数据;[0102] 可靠性分析模块,用于根据多元数据搜集模块爬取的流行度数据对相关数据的可靠性进行度量;[0103] 流行度计算模块,用于根据流行度数据以及可靠性计算每个应用的流行度;[0104] 应用推荐模块,用于根据应用的流行度和用户对每个类型应用的偏好获取综合排序,并推荐排序最靠前的N个应用给用户。[0105] 尽管已经示出和描述了本发明的实施例,对于本领域的普通技术人员而言,可以理解在不脱离本发明的原理和精神的情况下可以对这些实施例进行多种变化、修改、替换和变型,本发明的范围由所附权利要求及其等同物限定。
专利地区:山东
专利申请日期:2022-05-25
专利公开日期:2024-11-29
专利公告号:CN114860918B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。




