 产学研创新服务平台(全国)


一种动态多尺度注意力网络的火灾检测方法发明专利
更新时间:2026-10-01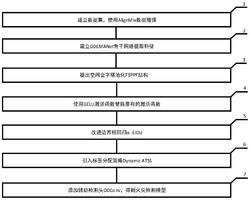 专利申请类型:发明专利;
地区:江苏-淮安;
源自:淮安高价值专利检索信息库;
专利名称:一种动态多尺度注意力网络的火灾检测方法
专利类型:发明专利
专利申请号:CN202311439450.6
专利申请(专利权)人:淮阴工学院
权利人地址:江苏省淮安市经济技术开发区枚乘东路1号
专利发明(设计)人:严云洋,叶翔,王盘龙,董可,冷志超,祝巧巧,耿嘉雯,朱妍
专利摘要:本发明公开了一种动态多尺度注意力网络的火灾检测方法,首先利用ODConv改进YOLOv7‑tiny中的ELAN模块,提出ODMBRBlock模块,引入EMA注意力机制,建立ODEMANet骨干网络提取火灾场景特征。针对空间特征容易丢失的问题,提出空间金字塔池化FSPPF结构,用于提取多尺度空间特征。使用GELU激活函数替换原有的激活函数,提高训练过程的收敛速度和性能。使用#imgabs0#边界框回归,解决损失函数无法优化预测框和真实框不相交的问题。引入动态标签分配策略,根据分类与回归的加权分数选择正负样本。加入ODConv辅助检测头,通过牺牲训练时间,提高模型的性能。最终得到一种动态多尺度注意力网络的火灾检测方法,实验表明,本发明有效提高了对火灾场景的特征提取能力,获得了更好的检测性能。
主权利要求:
1.一种动态多尺度注意力网络的火灾检测方法,其特征在于,包括如下步骤:步骤1:从互联网采集火灾数据,进行数据清洗和数据预处理,得到火灾检测数据集F,输入模型训练时通过AlignMix进行数据增强;
步骤2:提出ODMBRBlock模块,所述ODMBRBlock模块添加多分支残差连接,同时将一个常规卷积替换为ODConv全维动态卷积,利用ODMBRBlock模块改进YOLOv7‑tiny中的ELAN模块;在ODMBRBlock模块后加入EMA注意力机制,与MP模块结合,建立ODEMANet骨干网络提取特征;
步骤2.1:定义一个CBG卷积块,其为卷积、批归一化和GELU激活函数的组合块;
步骤2.2:改进YOLOv7‑tiny中的ELAN模块,通过加入ODConv动态卷积,并定义ODMBRBlock模块,所述ODMBRBlock模块包括第一分支和第二分支;
步骤2.3:所述第一分支由一个1×1的CBG卷积块进行通道数减半,直接输出到Concat拼接,所述第二分支经过1×1的CBG卷积块后,分为第三分支和第四分支;
步骤2.4:所述第三分支经过一个3×3的CBG卷积块和两个1×1的CBG卷积块后,通道数不变,输出到Concat拼接,所述第四分支经过一个ODConv动态卷积,再经过一个3×3的CBG卷积块后,分为第五分支和第六分支;
步骤2.5:所述第五分支经过两个1×1的CBG卷积块后,输出到Concat拼接,所述第六分支直接输出到Concat拼接;
步骤2.6:将所述第一分支、第三分支、第五分支和第六分支通过Concat拼接后,再经过一个1×1的CBG卷积块后输出,得到ODMBRBlock模块;
步骤2.7:在ODMBRBlock模块后加入EMA注意力机制,与MP模块结合,建立ODEMANet骨干网络进行特征提取;
步骤3:使用空间金字塔池化FSPPF结构替换YOLOv7‑tiny原有的SP结构,建立颈部网络层;
步骤3.1:定义一个CBF卷积块,其为卷积、批归一化和FReLU激活函数的组合块;
步骤3.2:特征输入首先通过一个1×1的CBF卷积块,特征输出到Concat拼接;
步骤3.3:所述步骤3.2的特征输出同时连续通过三个5×5的最大池化层,特征分别输出到Concat拼接;
步骤3.4:将所有特征输出通过Concat拼接后,再通过一个1×1的CBF卷积块,通道数翻倍,得到空间金字塔池化FSPPF结构;
步骤3.5:将空间金字塔池化FSPPF结构替换YOLOv7‑tiny原有的SP结构,建立颈部网络层进行特征融合;
步骤4:使用GELU激活函数替换YOLOv7‑tiny原有的LeakyReLU激活函数;
步骤5:引入EIOU损失函数,使用α‑IOU损失函数与EIOU损失函数进行组合,得到α‑EIOU损失函数;
步骤6:加入动态标签分配策略,即DynamicATSS,优化正负样本分配,提高模型性能;
步骤7:使用辅助检测头ODConv,建立动态多尺度注意力网络,即DynamicMulti‑ScaleAttentionNetworks,得到DMANet火灾检测模型,利用DMANet火灾检测模型对待检测的火灾数据图片进行检测。
2.根据权利要求1所述的一种动态多尺度注意力网络的火灾检测方法,其特征在于,所述步骤1的具体方法为:步骤1.1:通过互联网采集火灾场景图片和视频,得到原始火灾图片数据集P1和原始火灾视频数据集V1;
步骤1.2:对所述原始火灾图片数据集进行数据清洗,得到清洗火灾图片数据集P2,同时对所述火灾视频数据集V1进行逐帧裁剪和清洗,得到清洗火灾视频数据集V2;
步骤1.3:对所述清洗火灾图片数据集P2和清洗火灾视频数据集V2进行合并,然后进行数据预处理,得到可供训练的火灾检测数据集F;
步骤1.4:使用AlignMix方法对所述火灾检测数据集F进行数据增强;
步骤1.5:将经过数据增强后的火灾检测数据集F输入火灾检测网络进行训练。
3.根据权利要求1所述的一种动态多尺度注意力网络的火灾检测方法,其特征在于,所述步骤4的具体方法为:所述GELU的计算方法为:
其中,Φ(x)表示正态分布的累积分布函数,其表达式为:其中,erf()表示高斯误差函数。
4.根据权利要求1所述的一种动态多尺度注意力网络的火灾检测方法,其特征在于,所述步骤5的具体方法为:步骤5.1:首先引入EIOU损失函数,其公式为:
其中,LIOU为预测框与真值框的重叠损失,Ldis为预测框和真值框中心点的中心距离损gt gt gt失,Lasp为边界框的宽高损失,b和b 分别表示预测框和真值框的中心点,w,h和w ,h 分别c c表示预测框和真值框的宽度和高度,w 和h是预测框与真值框的最小外接矩形的宽度和高度,ρ(x,y)是两点之间的欧式距离;
步骤5.2:然后在LIOU=1‑IOU上使用Box‑Cox变化,得到α‑IOU损失:将α‑IOU与EIOU进行组合,得到α‑EIOU损失函数的公式为:
5.根据权利要求1所述的一种动态多尺度注意力网络的火灾检测方法,其特征在于,所述步骤6加入动态标签分配策略的具体方法为:步骤6.1:把预测引入到标签分配的锚点,将预测框与真值框的预测IOU和锚点框与真值框的锚点IOU组合以选择正样本,组合公式如下:CIOUs=PIOUs+AIOUs
mean(CIOUs)=mean(PIOUs)+mean(AIOUs)std(CIOUs)=std(PIOUs)+std(AIOUs)threshold(CIOUs)=mean(CIOUs)+std(CIOUs)其中,PIOUs是预测框和真值框之间的预测IOU,AIOUs是预定义的锚点框和真值框之间的锚点IOU,CIOUs表示组合IOUs,即预测IOU和锚点IOU的总和,mean()表示平均值,std()表示标准偏差,threshold()表示阈值;
步骤6.2:在计算CIOUs的平均值和标准偏差时,分别计算PIOUs和AIOUs的平均值和标准偏差,并将它们相加;
步骤6.3:最后,通过CIOUs的平均值和标准偏差的总和来计算CIOUs的阈值。
6.根据权利要求1所述的一种动态多尺度注意力网络的火灾检测方法,其特征在于,所述步骤7的具体方法为:步骤7.1:在检测头Head部分添加辅助头辅助训练;
步骤7.2:辅助头使用ODConv动态卷积替换普通的卷积层;
步骤7.3:建立动态多尺度注意力网络DMANet,将步骤1中火灾检测数据集F放入所述动态多尺度注意力网络DMANet进行训练,得到DMANet火灾检测模型;
步骤7.4:将待检测的火灾数据放入DMANet火灾检测模型,得到检测结果。 说明书 : 一种动态多尺度注意力网络的火灾检测方法技术领域[0001] 本发明涉及火灾检测领域,具体是一种动态多尺度注意力网络的火灾检测方法。背景技术[0002] 火灾威胁着人类的生命和财产安全,严重时会造成巨大经济损失和人员伤亡。随着经济快速发展,城市建筑物的规模越来越大,火情愈加复杂,灭火难度也随之增大。目前的灭火方式仍然以人工灭火为主,在灭火过程中,经常有消防人员受伤甚至牺牲。[0003] 发展安全和高效的消防手段,如在火灾发生前使用摄像头等设备进行火灾监测,火灾发生后使用消防机器人代替人工灭火可以有效减少人员伤亡和财产损失。消防机器人主要通过摄像头等设备对火场情况进行探索,基于图像对火灾目标进行精确识别是消防机器人高效灭火的关键,且消防机器人对火灾目标检测有着较高的实时性和准确性的要求,所以,针对基于图像的火灾检测方法进行研究具有重要的价值。[0004] ODConv利用一种新颖的多维注意力机制和并行策略来学习卷积核在任意卷积层的内核空间中的四个维度上的互补注意力。[0005] EMA是一种新颖高效的多尺度注意力模块,通过将部分通道重塑为批量维度,并分组为多个子特征,可以保留每个通道上的维度信息,从而使空间语义在每个子特征组内均匀分布。[0006] FReLU是针对图像识别任务提出的一种简单有效的漏斗激活方法,通过增加可忽略不计的空间条件开销,将ReLU和PReLU扩展为二维激活方法。此外,空间条件通过规则卷积捕捉复杂的视觉布局,实现像素级建模能力。[0007] GELU即高斯误差线性单元,一个高性能的神经网络激活函数,与ReLU等激活函数相比,GELU更加平滑,有助于提高训练过程的收敛速度和检测精度,可以在一定程度缓解神经元死亡的问题。[0008] DynamicATSS是一种简单有效的基于可预测训练状态的标签分配方法。通过在标签赋值中引入预测,选择更多对真实值IOU影响较大的高质量样本作为正样本,可以减小分类得分与IOU得分之间的差异,并生成更多高质量的边界框。[0009] EIOU是一种高效交叉联合损失,它明确测量了边界框回归中三个几何因素即重叠区域、中心点和边长之间的差异。α‑IOU即Alpha‑IOU,用于精确的边界框回归和目标检测,可以通过调制,为检测头提供更大的灵活性,以实现不同尺度边界框回归精度,在实验中α取3时可得到更好的检测性能。[0010] AlignMix即AlignMixup是一种强大的数据增强方法,可以在输入特征的目标标签中进行插值,通过在特征空间中对两个图像进行几何对齐,可以在两组特征之间进行插值,并保持一组特征的位置,同时可以保留一个图像的几何形状或姿势以及另一个图像的纹理。[0011] YOLOv7算法是一种实时物体检测器框架和相应的模型缩放方法。YOLOv7将模型重参数化引入到网络架构中,通过增大训练结构换取更小的推理结构,同时保留推理性能。主干网络使用高效聚合网络ELAN,在不改变原有的梯度传输路径情况下,利用组卷积来增加新增特征的基数,将不同组的特征组合起来,提高参数的利用率和计算效率。[0012] YOLOv7算法虽然拥有优秀的检测性能,但在面对复杂火灾场景如工厂火灾、隧道火灾等存在烟雾干扰的场景时,对火灾特征的提取能力仍然存在不足,导致无法准确提取真实火灾场景特征,影响火灾检测的速度和精度。发明内容[0013] 发明目的:针对背景技术中指出的对火灾场景的特征容易丢失的问题,本发明公开一种动态多尺度注意力网络的火灾检测方法,有效提高了对火灾场景的特征提取能力,获得了更好的检测性能,有效减少人员伤亡和财产损失。[0014] 技术方案:本发明提出了一种动态多尺度注意力网络的火灾检测方法,包括如下步骤:[0015] 步骤1:从互联网采集火灾数据,进行数据清洗和数据预处理,得到火灾检测数据集F,输入模型训练时通过AlignMix进行数据增强;[0016] 步骤2:提出ODMBRBlock模块,所述ODMBRBlock模块添加多分支残差连接,同时将一个常规卷积替换为ODConv全维动态卷积,利用ODMBRBlock模块改进YOLOv7‑tiny中的ELAN模块;在ODMBRBlock模块后加入EMA注意力机制,与MP模块结合,建立ODEMANet骨干网络提取特征;[0017] 步骤3:使用空间金字塔池化FSPPF结构替换YOLOv7‑tiny原有的SP结构,建立颈部网络层;[0018] 步骤4:使用GELU激活函数替换YOLOv7‑tiny原有的LeakyReLU激活函数;[0019] 步骤5:引入EIOU损失函数,使用α‑IOU损失函数与EIOU损失函数进行组合,得到α‑EIOU损失函数;[0020] 步骤6:加入动态标签分配策略,即DynamicATSS,优化正负样本分配,提高模型性能;[0021] 步骤7:使用辅助检测头ODConv,建立动态多尺度注意力网络,即DynamicMulti‑ScaleAttentionNetworks,得到DMANet火灾检测模型,利用DMANet火灾检测模型对待检测的火灾数据图片进行检测。[0022] 进一步地,所述步骤1的具体方法为:[0023] 步骤1.1:通过互联网采集火灾场景图片和视频,得到原始火灾图片数据集P1和原始火灾视频数据集V1;[0024] 步骤1.2:对所述原始火灾图片数据集进行数据清洗,得到清洗火灾图片数据集P2,同时对所述火灾视频数据集V1进行逐帧裁剪和清洗,得到清洗火灾视频数据集V2;[0025] 步骤1.3:对所述清洗火灾图片数据集P2和清洗火灾视频数据集V2进行合并,然后进行数据预处理,得到可供训练的火灾检测数据集F;[0026] 步骤1.4:使用AlignMix方法对所述火灾检测数据集F进行数据增强;[0027] 步骤1.5:将经过数据增强后的火灾检测数据集F输入火灾检测网络进行训练。[0028] 进一步地,所述步骤2建立ODEMANet骨干网络提取特征的具体方法为:[0029] 步骤2.1:定义一个CBG卷积块,其为卷积、批归一化和GELU激活函数的组合块;[0030] 步骤2.2:改进YOLOv7‑tiny中的ELAN模块,通过加入ODConv动态卷积,并定义ODMBRBlock模块,所述ODMBRBlock模块包括第一分支和第二分支;[0031] 步骤2.3:所述第一分支由一个1×1的CBG卷积块进行通道数减半,直接输出到Concat拼接,所述第二分支经过1×1的CBG卷积块后,分为第三分支和第四分支;[0032] 步骤2.4:所述第三分支经过一个3×3的CBG卷积块和两个1×1的CBG卷积块后,通道数不变,输出到Concat拼接,所述第四分支经过一个ODConv动态卷积,再经过一个3×3的CBG卷积块后,分为第五分支和第六分支;[0033] 步骤2.5:所述第五分支经过两个1×1的CBG卷积块后,输出到Concat拼接,所述第六分支直接输出到Concat拼接;[0034] 步骤2.6:将所述第一分支、第三分支、第五分支和第六分支通过Concat拼接后,再经过一个1×1的CBG卷积块后输出,得到ODMBRBlock模块;[0035] 步骤2.7:在ODMBRBlock模块后加入EMA注意力机制,与MP模块结合,建立ODEMANet骨干网络进行特征提取。[0036] 进一步地,所述步骤3建立颈部网络层的具体方法为:[0037] 步骤3.1:定义一个CBF卷积块,其为卷积、批归一化和FReLU激活函数的组合块;[0038] 步骤3.2:特征输入首先通过一个1×1的CBF卷积块,特征输出到Concat拼接;[0039] 步骤3.3:所述步骤3.2的特征输出同时连续通过三个5×5的最大池化层,特征分别输出到Concat拼接;[0040] 步骤3.4:将所有特征输出通过Concat拼接后,再通过一个1×1的CBF卷积块,通道数翻倍,得到空间金字塔池化FSPPF结构;[0041] 步骤3.5:将空间金字塔池化FSPPF结构替换YOLOv7‑tiny原有的SP结构,建立颈部网络层进行特征融合。[0042] 进一步地,所述步骤4的具体方法为:[0043] 所述GELU的计算方法为:[0044] GELU(x)=x*P(X≤x)=x*Φ(x)[0045] 其中,Φ(x)表示正态分布的累积分布函数,其表达式为:[0046][0047] 其中,erf()表示高斯误差函数。[0048] 进一步地,所述步骤5的具体方法为:[0049] 步骤5.1:首先引入EIOU损失函数,其公式为:[0050][0051] 其中,LIOU为预测框与真值框的重叠损失,Ldis为预测框和真值框中心点的中心距gt gt gt离损失,Lasp为边界框的宽高损失,b和b 分别表示预测框和真值框的中心点,w,h和w ,hc c分别表示预测框和真值框的宽度和高度,w和h 是预测框与真值框的最小外接矩形的宽度和高度,ρ(x,y)是两点之间的欧式距离;[0052] 步骤5.2:然后在LIOU=1‑IOU上使用Box‑Cox变化,得到α‑IOU损失:[0053][0054] 将α‑IOU与EIOU进行组合,得到α‑EIOU损失函数的公式为:[0055][0056] 进一步地,所述步骤6加入动态标签分配策略的具体方法为:[0057] 步骤6.1:把预测引入到标签分配的锚点,将预测框与真值框的预测IOU和锚点框与真值框的锚点IOU组合以选择正样本,组合公式如下:[0058] CIOUs=PIOUs+AIOUs[0059] mean(CIOUs)=mean(PIOUs)+mean(AIOUs)[0060] std(CIOUs)=std(PIOUs)+std(AIOUs)[0061] threshold(CIOUs)=mean(CIOUs)+std(CIOUs)[0062] 其中,PIOUs是预测框和真值框之间的预测IOU,AIOUs是预定义的锚点框和真值框之间的锚点IOU,CIOUs表示组合IOUs,即预测IOU和锚点IOU的总和,mean()表示平均值,std()表示标准偏差,threshold()表示阈值;[0063] 步骤6.2:在计算CIOUs的平均值和标准偏差时,分别计算PIOUs和AIOUs的平均值和标准偏差,并将它们相加;[0064] 步骤6.3:最后,通过CIOUs的平均值和标准偏差的总和来计算CIOUs的阈值。[0065] 进一步地,所述步骤7的具体方法为:[0066] 步骤7.1:在检测头Head部分添加辅助头辅助训练;[0067] 步骤7.2:辅助头使用ODConv动态卷积替换普通的卷积层;[0068] 步骤7.3:建立动态多尺度注意力网络,将步骤1中火灾检测数据集F放入所述DMANet火灾检测网络进行训练,得到DMANet火灾检测模型;[0069] 步骤7.4:将待检测的火灾数据放入DMANet火灾检测模型,得到检测结果。[0070] 有益效果:[0071] 1、本发明首先改进了YOLOv7的骨干网络,使用ODMBRBlock来优化ELAN模块。ELAN模块通过控制梯度路径的长度,使深层网络更有效地学习和收敛;ODMBRBlock模块通过添加多分支残差连接,提升特征学习深度,同时将一个常规卷积替换为ODConv全维动态卷积,这使得ODMBRBlock模块能够显著提高特征提取能力,改善模型性能,而不增加模型参数量;引入EMA注意力机制,通过将通道维度分组,使建立的ODEMANet骨干网络可以减小通道降维带来的特征缺失问题,同时降低模型参数量和计算成本。[0072] 2、其次,在瓶颈网络Neck部分提出空间金字塔池化FSPPF结构,有效避免对图像区域进行裁剪、缩放时导致的图像失真问题,通过多滑动窗口进行Pooling池化操作,在不同尺寸下对特征图提取特征,忽略输入图像尺寸不同的影响并且产生固定长度的输出尺寸,增加了提取特征的丰富度。[0073] 3、然后,在IOU损失函数中使用EIOU损失函数和α‑IOU损失函数进行组合,得到α‑EIOU损失函数,通过调节α使检测头更灵活地实现不同尺度的边界框回归精度,同时EIOU提供了更快的收敛速度和更好的定位结果,使α‑EIOU可以获得更高的检测精度。[0074] 4、最后,在检测头Head部分增加ODConv辅助头,使检测头在仅增加训练成本的情况下提高检测精度,同时增加动态标签分配策略,优化正负样本分配策略,获得更高的模型性能。[0075] 5、实验证明,本发明方法有效增加了对火灾场景的特征提取能力,与YOLOv7‑tiny模型相比,在只增加部分参数量的情况下,获得了更深的网络层数,准确率也得到有效提升。附图说明[0076] 图1为本发明中一种动态多尺度注意力网络的火灾检测方法整体流程图;[0077] 图2为本发明中动态多尺度注意力网络火灾检测模型结构图;[0078] 图3为本发明中ODConv全维动态卷积示意图;[0079] 图4为本发明中ODMBRBlock模块结构图;[0080] 图5为本发明中EMA注意力模块示意图;[0081] 图6为本发明中ODEMANet骨干网络示意图;[0082] 图7为本发明中空间金字塔池化FSPPF结构示意图;[0083] 图8为火灾检测数据集F在YOLOv7‑tiny模型的测试结果;[0084] 图9为火灾检测数据集F在本发明DMANet火灾检测模型中的测试结果。具体实施方式[0085] 下面结合具体实施例,进一步阐明本发明,应理解这些实施例仅用于说明本发明而不用于限制本发明的范围,在阅读了本发明之后,本领域技术人员对本发明的各种等价形式的修改均落于本申请所附权利要求所限定的范围。[0086] 本发明提出了一种动态多尺度注意力网络的火灾检测方法,包括:[0087] 步骤1:从互联网采集火灾数据,进行数据清洗和数据预处理,得到火灾检测数据集F,输入模型训练时通过AlignMix进行数据增强,其具体方法为:[0088] 步骤1.1:通过互联网采集火灾场景图片和视频,得到原始火灾图片数据集P1和原始火灾视频数据集V1。[0089] 步骤1.2:对所述原始火灾图片数据集进行数据清洗,包括去重复和去无关等操作,得到清洗火灾图片数据集P2,同时对所述火灾视频数据集V1进行逐帧裁剪和数据清洗,得到清洗火灾视频数据集V2。[0090] 步骤1.3:对所述清洗火灾图片数据集P2和清洗火灾视频数据集V2进行数据预处理,将所述数据集P2和V2进行合并,得到预处理火灾数据集P3。[0091] 步骤1.4:对所述预处理火灾数据集P3进行数据标注等预处理操作,得到可供训练的火灾检测数据集F。[0092] 步骤1.5:使用AlignMix方法对所述火灾检测数据集F进行数据增强,AlignMix考虑了融合后图像的质量问题,提出在特征空间上将两个图像各个位置进行对齐,然后再在对应位置做差值,以此实现更高质量的图像融合。[0093] 步骤1.6:将经过数据增强后的数据集F输入火灾检测网络进行训练。[0094] 步骤2:提出ODMBRBlock模块,加入EMA注意力机制,与MP结构结合,建立ODEMANet骨干网络提取特征,其具体方法为:[0095] 步骤2.1:定义一个CBG卷积块,其为卷积、批归一化和GELU激活函数的组合块。[0096] 步骤2.2:改进YOLOv7‑tiny中的ELAN模块,加入ODConv动态卷积,ODConv动态卷积的结构图参见图3。定义ODMBRBlock模块,参见图4,其结构包括第一分支和第二分支。[0097] 步骤2.3:第一分支由一个1×1的CBG卷积块进行通道数减半,直接输出到Concat拼接,所述第二分支经过1×1的CBG卷积块后,分为第三分支和第四分支。[0098] 步骤2.4:所述第三分支经过一个3×3的CBG卷积块和两个1×1的CBG卷积块后,通道数不变,输出到Concat拼接,所述第四分支经过一个ODConv动态卷积,再经过一个3×3的CBG卷积块后,分为第五分支和第六分支。[0099] 步骤2.5:所述第五分支经过两个1×1的CBG卷积块后,输出到Concat拼接,所述第六分支直接输出到Concat拼接。[0100] 步骤2.6:将所述第一分支、第三分支、第五分支和第六分支通过Concat拼接后,再经过一个1×1的CBG卷积块后输出,得到ODMBRBlock模块。[0101] 步骤2.7:在ODMBRBlock模块后加入EMA注意力机制,与MP模块结合,建立ODEMANet骨干网络进行特征提取,具体参见图5和图6,图5为EMA注意力机制结构图,图6为ODEMANet骨干网络示意图。[0102] 步骤3:使用空间金字塔池化FSPPF结构,建立颈部网络层,参见图7,其具体方法为:[0103] 步骤3.1:定义一个CBF卷积块,其为卷积、批归一化和FReLU激活函数的组合块。[0104] 步骤3.2:将所述ODEMANet骨干网络提取到的特征作为输入,首先通过一个1×1的CBF卷积块,特征输出到Concat拼接。[0105] 步骤3.3:所述步骤3.2的特征输出同时连续通过三个5×5的最大池化层,特征分别输出到Concat拼接。[0106] 步骤3.4:将所述所有特征输出通过Concat拼接后,再通过一个1×1的CBF卷积块,通道数翻倍,得到空间金字塔池化FSPPF结构。[0107] 步骤3.5:将空间金字塔池化FSPPF结构替换YOLOv7‑tiny原有的SP结构,建立颈部网络层进行特征融合。[0108] 步骤4:使用GELU激活函数替换原有的LeakyReLU激活函数,其具体方法为:[0109] 将YOLOv7‑tiny原有的LeakyReLU激活函数替换为GELU激活函数,GELU的计算方法为:[0110] GELU(x)=x*P(X≤x)=x*Φ(x)[0111] 其中,Φ(x)表示正态分布的累积分布函数,其表达式为:[0112][0113] erf()表示高斯误差函数,该函数可通过近似估计进行计算:[0114][0115] 其中,tanh()为双曲正切函数,为简化计算过程,可使用下式:[0116] xσ(1.702x)[0117] 进行近似计算,计算时σ取值为1。[0118] 步骤5:引入EIOU损失函数,使用α‑IOU损失函数与EIOU损失函数进行组合,得到α‑EIOU损失函数,其具体方法为:[0119] 步骤5.1:首先引入EIOU损失函数,其公式为:[0120][0121] 其中,LIOU为预测框与真值框的重叠损失,Ldis为预测框和真值框中心点的中心距gt gt gt离损失,Lasp为边界框的宽高损失,b和b 分别表示预测框和真值框的中心点,w,h和w ,hc c分别表示预测框和真值框的宽度和高度,w和h 是预测框与真值框的最小外接矩形的宽度和高度,ρ(x,y)是两点之间的欧式距离;[0122] 步骤5.2:然后引入α‑IOU损失函数,在LIOU=1‑IOU上使用Box‑Cox变化,得到α‑IOU损失函数公式:[0123][0124] 将α‑IOU损失函数与EIOU进行结合,即在LEIOU=LIOU+Ldis+Lasp上使用Box‑Cox变化,得到α‑EIOU损失函数的公式为:[0125][0126] 在实际应用中,α取值为3时性能更好。[0127] 步骤6:加入动态标签分配策略,即DynamicATSS,优化正负样本分配,提高模型性能,其具体方法为:[0128] 步骤6.1:加入动态标签分配策略,把预测引入到标签分配的锚点,将预测框与真值框的预测IOU和锚点框与真值框的锚点IOU组合以选择正样本,组合公式如下:[0129] CIOUs=PIOUs+AIOUs[0130] mean(CIOUs)=mean(PIOUs)+mean(AIOUs)[0131] std(CIOUs)=std(PIOUs)+std(AIOUs)[0132] threshold(CIOUs)=mean(CIOUs)+std(CIOUs)[0133] 其中PIOUs是预测框和真值框之间的预测IOU,AIOUs是预定义的锚点框和真值框之间的锚点IOU,CIOUs表示组合IOUs,即预测IOU和锚点IOU的总和,mean()表示平均值,std()表示标准偏差,threshold()表示阈值。[0134] 步骤6.2:在计算CIOUs的平均值和标准偏差时,分别计算PIOUs和AIOUs的平均值和标准偏差,并将它们相加。[0135] 步骤6.3:最后,通过CIOUs的平均值和标准偏差的总和来计算CIOUs的阈值。[0136] 步骤7:使用辅助检测头ODConv,建立动态多尺度注意力网络,即DynamicMultiscaleAttentionNetworks,得到DMANet火灾检测模型,其具体方法为:[0137] 步骤7.1:在检测头Head部分添加辅助头辅助训练。[0138] 步骤7.2:辅助头使用ODConv动态卷积替换普通的卷积层,仅增加训练成本,提高网络的特征提取能力。[0139] 步骤7.3:基于上述方法建立动态多尺度注意力网络,将火灾检测数据集F放入上述DMANet火灾检测网络进行训练,得到DMANet火灾检测模型,具体过程为:[0140] 首先,将火灾检测数据集F按照7∶3的比例划分训练集和测试集,再对训练集按9∶1的比例划分训练集和验证集,设定输入图像的尺寸为640×640,设置批处理大小为8和训练世代为300,将数据集载入DMANet火灾检测网络进行训练,得到DMAnet火灾检测模型,其次,在网络训练阶段,各模块的详细步骤如下:[0141] (1)骨干网络ODEMANet主要对输入图像进行特征提取,开始的两个卷积层用于对输入图像进行下采样,增加通道数,将输入图像的RGB三维通道增加到32维通道和64维通道。然后是三组ODMBRBlock模块和EMA注意力与MP组合模块的模块组,每个模块组使特征图大小减半,通道数翻倍,最后是一个ODMBRBlock模块,得到20×20×512的特征输出映射。[0142] (2)瓶颈网络层Neck主要用于构建特征金字塔,特征金字塔有助于模型获得多尺度的火灾场景特征。由骨干网络输出的特征映射进入空间金字塔池化FSPPF结构,进行空间金字塔池化操作,可以有效避免图像区域裁剪、缩放操作导致的图像失真问题,提高了产生候选框的速度,节约计算成本。FSPPF使用FReLU作为激活函数,使用1、5、9、13等四个并行的最大池化操作,可以在不同尺度上的滑动窗口上进行Pooling操作,在不同尺寸特征图上提取特征,增加了特征提取的丰富度;使用特征金字塔网络结构,将骨干网络中ODMBRBlock模块输出的特征分支进行特征融合,获得多尺度的火灾场景特征,同时加入上采样,增大图像的分辨率。[0143] (3)检测头Head负责最终的检测步骤,增加ODConv辅助头检测头,通过增加训练成本,使实时检测器可以在不提高推理成本的情况下提高检测精度,将瓶颈网络输出的火灾场景特征进行分类识别,提取火灾预测框,得到最终的特征输出向量,生成预测结果,判断火灾位置和发生概率。[0144] 步骤7.4:将待检测的火灾数据放入DMANet火灾检测模型,得到检测结果。[0145] 通过表1可以看出,本发明的火灾检测方法,在复杂火灾场景特征难以识别的火灾数据集上表现了优秀的性能。本方法通过改进的ODMRBlock模块并加入EMA注意力机制构建的ODEMANet特征提取网络能够有效地提取复杂火灾场景特征,同时加入FSPPF空间金字塔池化模块和GELU激活函数解决了特征丢失的问题,增加了特征丰富度,最后加入ODConv动态辅助头,提高检测精度。最终,得到的DMANet火灾检测模型与YOLOv7‑tiny模型相比,在只增加部分参数量的情况下,获得了更深的网络层数,准确率也得到较大提升,具体参见图8和图9的对比。[0146] 表1[0147][0148] 相关词汇或变量说明:[0149][0150][0151]
专利地区:江苏
专利申请日期:2023-10-31
专利公开日期:2024-11-29
专利公告号:CN117409359B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。




