 产学研创新服务平台(全国)


一种基于小样本元学习的水果图像分类方法发明专利
更新时间:2026-10-01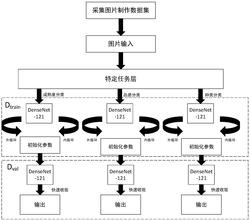 专利申请类型:发明专利;
源自:重庆高价值专利检索信息库;
专利名称:一种基于小样本元学习的水果图像分类方法
专利类型:发明专利
专利申请号:CN202210457901.8
专利申请(专利权)人:重庆邮电大学
权利人地址:重庆市南岸区黄桷垭崇文路2号
专利发明(设计)人:郑太雄,谭科,杨新琴
专利摘要:本发明涉及一种基于小样本元学习的水果图像分类方法,属于水果图像分类领域,采用模型无关的元学习模型MAML作为图像分类框架,将DenseNet‑121作为骨干网络,并与特征金字塔网络FPN架构相结合进行目标特征提取,通过独特的内外循环算法进行训练,其中内循环负责模拟小样本学习中模型学习新任务的场景,外循环则负责收集内循环学习后的效果,最终实现基于小样本的水果图像分类。本发明解决了传统数字图像处理技术因果实阶段性状变化造成分类精度较低以及鲁棒性不强的问题,还克服了基于大数据的卷积神经网络所需数据集庞大、梯度消失慢、计算训练量大以及模型收敛慢等缺点。
主权利要求:
1.一种基于小样本元学习的水果图像分类方法,其特征在于:包括以下步骤:S1:采集多类自然环境下的果实图像,并进行尺寸缩放,分类标注训练图像和测试图像作为元数据集,采集少量目标水果图像完成标注;
S2:准备N个训练任务以及每个训练任务对应的SupportSet和QuerySet;再准备多个测试任务,用于评估模型学习到的参数的效果;训练任务和测试任务均从采集的数据中采样产生;
S3:采用模型无关的元学习模型MAML作为图像分类的主体算法,将密集连接网络DenseNet‑121作为骨干网络,并结合特征金字塔网络FPN架构对经过标注和尺寸缩放处理后的图像进行目标特征提取;
S4:初始化DenseNet‑121网络参数为θ,设定子任务内的学习率α和任务间的学习率β;
S5:每一次训练从中提取一个或者一个批次子任务Ti;
S6:在子任务Ti中,利用loss函数对θ进行梯度更新,其更新公式为重复在任务Ti中利用loss函数对θ进行梯度更新的过程即为内循环过程;
S7:当子任务Ti训练完,利用在所有任务上的loss和的梯度更新最后的θ,其更新公式为重复在任务Ti训练完后利用在所有任务上的loss和的梯度更新最后的θ的过程即为外循环过程;
S8:直到所有的子任务都训练完毕,得到最后的θ;
S9:通过S8得到的初始化参数θ,使用目标水果图像为数据集,经过一两次迭代训练得到优秀的分类效果。
2.根据权利要求1所述的基于小样本元学习的水果图像分类方法,其特征在于:步骤S3中,骨干网络DenseNet‑121提取目标特征分为4个阶段,将每个阶段提取的特征与FPN进行特征融合;底层特征层通过1×1的卷积得到与上一层特征层相同的通道数,上层的特征层通过上采样得到与下一层特征层一样的长和宽,再进行相加得到融合好的新的特征层。
3.根据权利要求1所述的基于小样本元学习的水果图像分类方法,其特征在于:步骤S3中,采用随机池化替换骨干网DenseNet‑121中的最大池化和平均池化。
4.根据权利要求1所述的基于小样本元学习的水果图像分类方法,其特征在于:步骤0
S6、S7中,将骨干网络的参数φ 赋值给任务m独有的网络,得到 初始的 使用任务m的SupportSet,基于任务m的学习率αm,对m进行1次优化,更新 基于1次优化后的使用QuerySet计算任务m的 并计算 对 的梯度,用该梯度,乘以
0 1 1
元网络的学习率α,更新φ ,得到φ ;采样1个任务n,将参数φ 赋值给任务n,得到 初始的 使用任务n的训练数据,基于任务n的学习率β,对 进行一次优化,更新 基于1次优化后的 使用QuerySet计算任务n的 并计算 上的梯度,用该梯度,
1 2
乘以元网络的学习率α,更新φ ,得到φ ;在训练任务上,重复执行本步骤直至所有采样任务采样完成。
5.根据权利要求1所述的基于小样本元学习的水果图像分类方法,其特征在于:步骤S6、S7中,所使用的损失函数为交叉熵损失函数:其中,i表示观测样本,c表示类别,M表示类别数量,N表示类别总数,yic表示符号函数,取值0或1,如果样本i的真实类别等于c则取1,否则取0;pic表示观测样本i属于类别c的预测概率。
6.根据权利要求1所述的基于小样本元学习的水果图像分类方法,其特征在于:步骤S9中,使用DenseNet‑121作为特征提取网络。
7.根据权利要求1所述的基于小样本元学习的水果图像分类方法,其特征在于:水果图像分类包括成熟度分类、品质分类和种类分类。 说明书 : 一种基于小样本元学习的水果图像分类方法技术领域[0001] 本发明属于水果图像分类领域,涉及一种基于小样本元学习的水果图像分类方法。背景技术[0002] 对于大规模的水果产量,如何将其准确的分类识别是一个大问题,不同种类水果的产后处理情况也影响着水果行业的销售规模。传统水果的产后处理技术主要依靠人力完成,依靠人工对水果的形状、大小、颜色进行不同种类的分拣。自计算机视觉技术与智能农业领域融合以来,在图像分类领域上涌现出许多新的方法。传统数字图像处理技术,如基于颜色、纹理、形状等特征提取识别从而进行分类,其缺点是依赖目标果实的外在颜色、纹理和形状等特征,但果实的外在特征会随着果实不同生长阶段发生改变,其鲁棒性不高。机器学习图像分割技术与分类器,如基于K‑means聚类算法、基于贝叶斯分类器算法、基于支持向量机SVM算法、基于KNN聚类算法和基于Adaboost和Haar‑like特征算法等,其缺点是需要提前设定参数值,且提前设定的参数对分类精度影响较大。[0003] 伴随着人工智能热潮的掀起和计算设备并行计算性能的大幅度进步,基于大数据深度学习的卷积神经网络算法被大量用于水果图像分类,如LeNet、AlexNet、VGG、GoogLeNet、ResNet、MobileNet系列等。这些算法模型虽然能解决水果后生产中的图像分类问题,但是这些模型泛化性能不足、对新种类任务适应性较差。而且卷积神经网络在图像分类任务中大多数是基于监督学习的研究,而监督学习的数据集需要大量的标记数据,成本高且不易获得。同时计算成本也大幅上升,测试时需要占用大量的内存且极为耗时,使得它们不适合部署在资源有限的移动平台上。这意味着上述网络模型不能满足小样本低成本下水果图像分类的要求。发明内容[0004] 有鉴于此,本发明的目的在于提供一种基于小样本元学习的水果图像分类方法,解决传统图像易受几何特征随生长周期改变影响、鲁棒性不高等问题,还克服了一般基于大数据深度学习神经网络模型需要大量数据集、计算量大、计算时间长、收敛速度慢和对计算机硬件要求高等缺点。[0005] 为达到上述目的,本发明提供如下技术方案:[0006] 一种基于小样本元学习的水果图像分类方法,包括以下步骤:[0007] S1:采集多类自然环境下的果实图像,并进行尺寸缩放,分类标注训练图像和测试图像作为元数据集,采集少量目标水果图像完成标注;[0008] S2:准备N个训练任务(TrainTask)以及每个训练任务对应的SupportSet和QuerySet;再准备多个测试任务,用于评估模型学习到的参数的效果;训练任务和测试任务均从采集的数据中采样产生;[0009] S3:采用模型无关的元学习模型(Model‑AgnosticMeta‑Learning,MAML)作为图像分类的主体算法,将密集连接网络DenseNet‑121作为骨干网络,并结合特征金字塔网络(FeaturePyramidNetworks,FPN)架构对经过标注和尺寸缩放处理后的图像进行目标特征提取;[0010] S4:初始化DenseNet‑121网络参数为θ,设定子任务内的学习率α和任务间的学习率β;[0011] S5:每一次训练从中提取一个或者一个批次子任务Ti;[0012] S6:在子任务Ti中,利用loss函数对θ进行梯度更新,其更新公式为重复在任务Ti中利用loss函数对θ进行梯度更新的过程即为内循环过程;[0013] S7:当子任务Ti训练完,利用在所有任务上的loss和的梯度更新最后的θ,其更新公式为 重复在任务Ti训练完后利用在所有任务上的loss和的梯度更新最后的θ的过程即为外循环过程;[0014] S8:直到所有的子任务都训练完毕,得到最后的θ;[0015] S9:通过S8得到的初始化参数θ,使用目标水果图像为数据集,经过一两次迭代训练得到优秀的分类效果。[0016] 进一步,步骤S3中,骨干网络DenseNet‑121提取目标特征分为4个阶段,将每个阶段提取的特征与FPN进行特征融合;底层特征层通过1×1的卷积得到与上一层特征层相同的通道数,上层的特征层通过上采样得到与下一层特征层一样的长和宽,再进行相加得到融合好的新的特征层。[0017] 进一步,步骤S3中,采用随机池化替换骨干网DenseNet‑121中的最大池化和平均池化。0[0018] 进一步,步骤S6、S7中,将骨干网络的参数φ 赋值给任务m独有的网络,得到 初始的 使用任务m的SupportSet,基于任务m的学习率αm,对m进行1次优化,更新基于1次优化后的 使用QuerySet计算任务m的 并计算 对 的梯0 1 1度,用该梯度,乘以元网络的学习率α,更新φ ,得到φ ;采样1个任务n,将参数φ 赋值给任务n,得到 初始的 使用任务n的训练数据,基于任务n的学习率β,对 进行一次优m化,更新 基于1次优化后的 使用QuerySet计算任务n的loss—l 并计算 上1 2的梯度,用该梯度,乘以元网络的学习率α,更新φ ,得到φ ;在训练任务上,重复执行本步骤直至所有采样任务采样完成。[0019] 进一步,步骤S6、S7中,所使用的损失函数为交叉熵损失函数:[0020][0021] 其中,i表示观测样本,c表示类别,M表示类别数量,N表示类别总数,yic表示符号函数,取值0或1,如果样本i的真实类别等于c则取1,否则取0;pic表示观测样本i属于类别c的预测概率。[0022] 进一步,步骤S9中,只需要少量的目标水果图像作为数据集。[0023] 进一步,步骤S9中,使用DenseNet‑121作为特征提取网络。[0024] 进一步,水果图像分类包括成熟度分类、品质分类和种类分类。[0025] 本发明的有益效果在于:[0026] 1)本发明能够解决自然光照条件变化、果实聚类重叠、枝叶遮挡的分类难题以及针对不同类型的水果进行检测,具有较好的鲁棒性和通用性。[0027] 2)本发明采用MAML网络,不仅可以准确地识别水果类别,而且还能只需要少量目标水果图像,节省了数据标注成本和计算成本。[0028] 3)本发明采用密集连接网络(DenseNet)作为骨干网络提取图像特征,由于密集连接结构不会增加模型参数,可以降低梯度消失和训练的难度,提高模型的收敛性能。[0029] 4)本发明采用特征金字塔网络(FPN)扩展骨干网络,在小目标分类方面效果比较明显,解决果实部分遮挡或果实目标体积小被忽略等问题。[0030] 5)本发明采用随机池化替换骨干网DenseNet‑121中的最大池化和平均池化,提高了模型的泛化能力。[0031] 本发明的其他优点、目标和特征在某种程度上将在随后的说明书中进行阐述,并且在某种程度上,基于对下文的考察研究对本领域技术人员而言将是显而易见的,或者可以从本发明的实践中得到教导。本发明的目标和其他优点可以通过下面的说明书来实现和获得。附图说明[0032] 为了使本发明的目的、技术方案和优点更加清楚,下面将结合附图对本发明作优选的详细描述,其中:[0033] 图1为本发明基于小样本元学习的水果图像分类方法的流程示意图;[0034] 图2为本发明基于小样本元学习的水果图像分类方法的算法流程图;[0035] 图3为本发明基于小样本元学习的水果图像分类方法训练示意图;[0036] 图4为本发明基于小样本元学习的水果图像分类方法DenseNet‑121的网络原理图;[0037] 图5为本发明基于小样本元学习的水果图像分类方法DenseNet‑121的网络结构图;[0038] 图6为本发明MAML图像分类框架骨干网FPN融合底层到高层的特征图的流程图;[0039] 图7为本发明MAML图像分类框架骨干网DenseNet‑121和FPN提取特征融合的意义解释。具体实施方式[0040] 以下通过特定的具体实例说明本发明的实施方式,本领域技术人员可由本说明书所揭露的内容轻易地了解本发明的其他优点与功效。本发明还可以通过另外不同的具体实施方式加以实施或应用,本说明书中的各项细节也可以基于不同观点与应用,在没有背离本发明的精神下进行各种修饰或改变。需要说明的是,以下实施例中所提供的图示仅以示意方式说明本发明的基本构想,在不冲突的情况下,以下实施例及实施例中的特征可以相互组合。[0041] 其中,附图仅用于示例性说明,表示的仅是示意图,而非实物图,不能理解为对本发明的限制;为了更好地说明本发明的实施例,附图某些部件会有省略、放大或缩小,并不代表实际产品的尺寸;对本领域技术人员来说,附图中某些公知结构及其说明可能省略是可以理解的。[0042] 本发明实施例的附图中相同或相似的标号对应相同或相似的部件;在本发明的描述中,需要理解的是,若有术语“上”、“下”、“左”、“右”、“前”、“后”等指示的方位或位置关系为基于附图所示的方位或位置关系,仅是为了便于描述本发明和简化描述,而不是指示或暗示所指的装置或元件必须具有特定的方位、以特定的方位构造和操作,因此附图中描述位置关系的用语仅用于示例性说明,不能理解为对本发明的限制,对于本领域的普通技术人员而言,可以根据具体情况理解上述术语的具体含义。[0043] 请参阅图1~图7,本发明优选了一种基于小样本元学习的水果图像分类方法的流程图,包括如下具体步骤:[0044] (1):采用模型无关的元学习模型(Model‑AgnosticMeta‑Learning,MAML)作为图像分类的主体算法,将DenseNet‑121作为骨干网络,并结合特征金字塔网络(FeaturePyramidNetworks,FPN)架构对经过标注和尺寸缩放处理后的图像进行目标特征提取;骨干网络DenseNet‑121提取目标特征分为4个阶段,将每个阶段提取的特征与FPN进行特征融合;底层特征层通过1×1的卷积得到与上一层特征层相同的通道数,上层的特征层通过上采样得到与下一层特征层一样的长和宽,再进行相加得到融合好的新的特征层。采用随机池化替换骨干网DenseNet‑121中的最大池化和平均池化。[0045] (2):采集多类自然环境下的果实图像,并进行尺寸缩放,分类标注训练图像和测试图像作为元数据集,采集少量目标水果图像完成标注;[0046] (3):准备N个训练任务(TrainTask)以及每个训练任务对应的SupportSet和QuerySet。[0047] 再准备几个测试任务,测试任务用于评估模型学习到的参数的效果。训练任务和测试任务均从采集的数据中采样产生;[0048] (4):初始化DenseNet‑121网络参数为θ,设定子任务内的学习率α和任务间的学习率β;[0049] (5):每一次训练从中提取一个或者一个批次子任务Ti;[0050] (6):在任务Ti中,利用loss函数对θ进行梯度更新,其更新公式为重复在任务Ti中利用loss函数对θ进行梯度更新的过程即为内循环过程;[0051] (7):当任务Ti训练完,利用在所有任务上的loss和的梯度更新最后的θ,其更新公式为 重复在任务Ti训练完后利用在所有任务上的loss和的梯度更新最后的θ的过程即为外循环过程;[0052] 步骤(6)、(7)具体包括:将骨干网络的参数φ0赋值给任务m独有的网络,得到初始的 使用任务m的SupportSet,基于任务m的学习率αm,对m进行1次优化,更新基于1次优化后的 使用QuerySet计算任务m的 并计算 对0 1 1的梯度,用该梯度,乘以元网络的学习率α,更新φ ,得到φ ;采样1个任务n,将参数φ 赋值给任务n,得到 初始的 使用任务n的训练数据,基于任务n的学习率β,对 进行一m次优化,更新 基于1次优化后的 使用QuerySet计算任务n的loss—l 并计算1 2上的梯度,用该梯度,乘以元网络的学习率α,更新φ ,得到φ ;在训练任务上,重复执行本步骤直至所有采样任务采样完成。本步骤中所使用的损失函数为交叉熵损失函数:[0053][0054] 其中,i表示观测样本,c表示类别,M表示类别数量,N表示类别总数,yic表示符号函数,取值0或1,如果样本i的真实类别等于c则取1,否则取0;pic表示观测样本i属于类别c的预测概率。[0055] (8):直到所有的子任务都训练完毕,得到最后的θ;[0056] (9):通过(8)得到的初始化参数,使用目标水果图像为数据集,经过一两次迭代训练即可得到优秀的分类效果。[0057] 最后说明的是,以上实施例仅用以说明本发明的技术方案而非限制,尽管参照较佳实施例对本发明进行了详细说明,本领域的普通技术人员应当理解,可以对本发明的技术方案进行修改或者等同替换,而不脱离本技术方案的宗旨和范围,其均应涵盖在本发明的权利要求范围当中。
专利地区:重庆
专利申请日期:2022-04-27
专利公开日期:2024-11-29
专利公告号:CN114818931B
以上信息来自国家知识产权局,如信息有误请联系我方更正!
该专利所有权非本平台所有,我方无法提供专利权所有者联系方式,请勿联系我方。




